Qwen-Image-2.1 是阿里巴巴 Qwen 團隊在九月二十日開源的生圖模型。跟上一代 Qwen-Image 2512 與 Qwen-Image-Edit 分成兩顆模型不同,這次是一顆權重同時做文生圖與圖片編輯,而且官方列了幾項很具體的能力:原生透明背景輸出(直接給 alpha 通道,不用另外去背)、編輯時最多接十張參考圖、原生 2048×2048 直出、局部編輯。文字編碼器換成 Qwen3-VL 8B,圖片壓縮的 VAE 也是全新的 64 通道 RGBA 版本。
官方把話說得這麼具體,這篇就照 HiDream-O1 與 Lens 兩篇的做法:官方說什麼,就在自己的電腦上出題對照,看對不對。四章共 182 張圖,每一張都跟之前評測過的模型同題並排,判定由我逐張看完後給出。
快速結論
- 成立的宣稱:原生透明輸出。玻璃杯、線香的煙、新娘頭紗這類半透明的東西,只有它能給出真正有層次的 alpha,去背模型只能給實心遮罩。但拿它當一般去背工具,髮絲、毛髮、雜亂背景的人像會輸給 BiRefNet,有兩題甚至把人物整個切掉
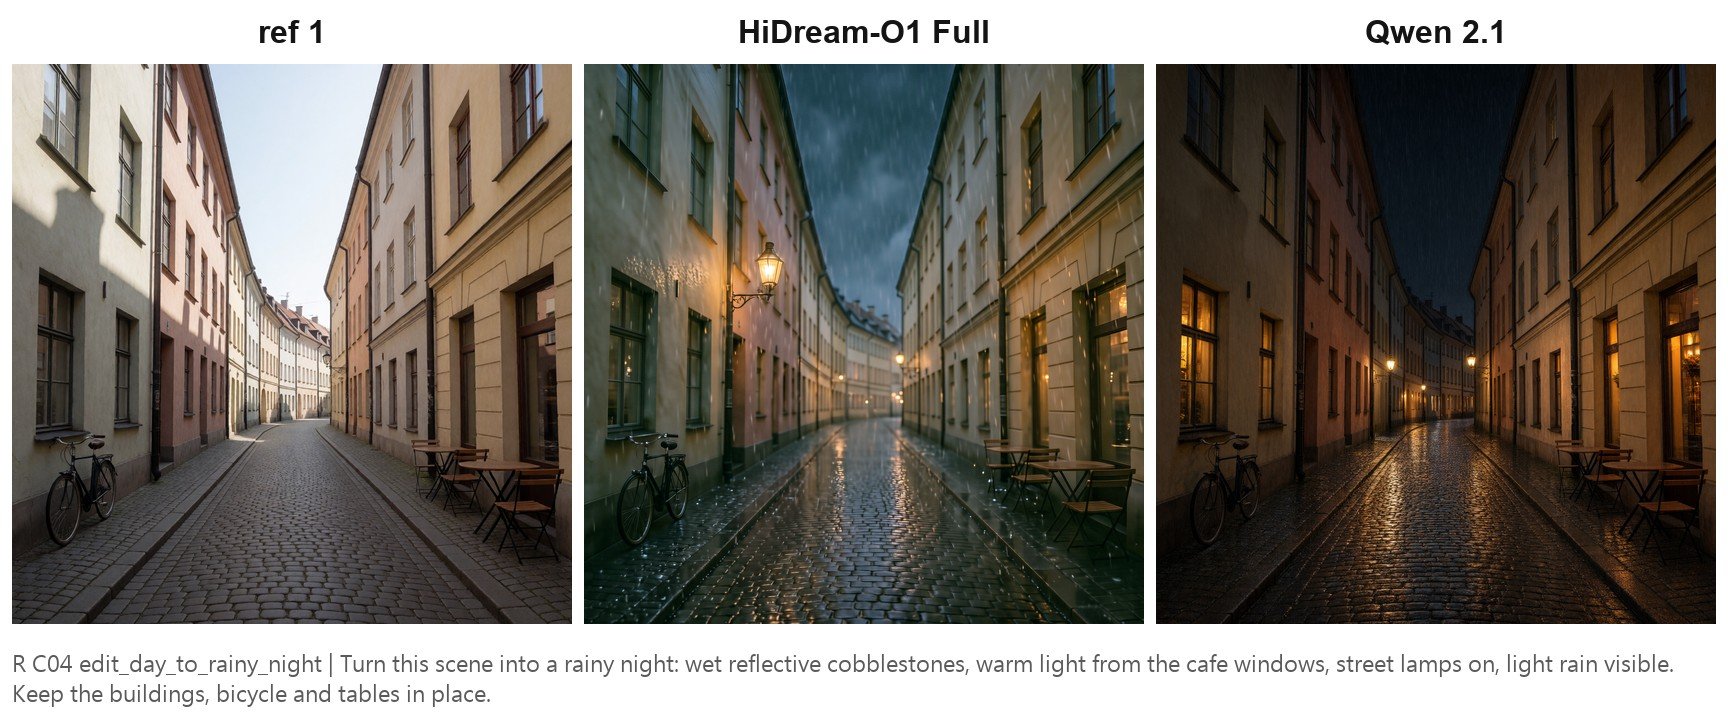
- 成立的宣稱:單張參考圖的編輯。換招牌文字、換沙發材質、把白天改成雨夜,沒被要求改的區域幾乎逐像素不動,這點贏過 HiDream-O1
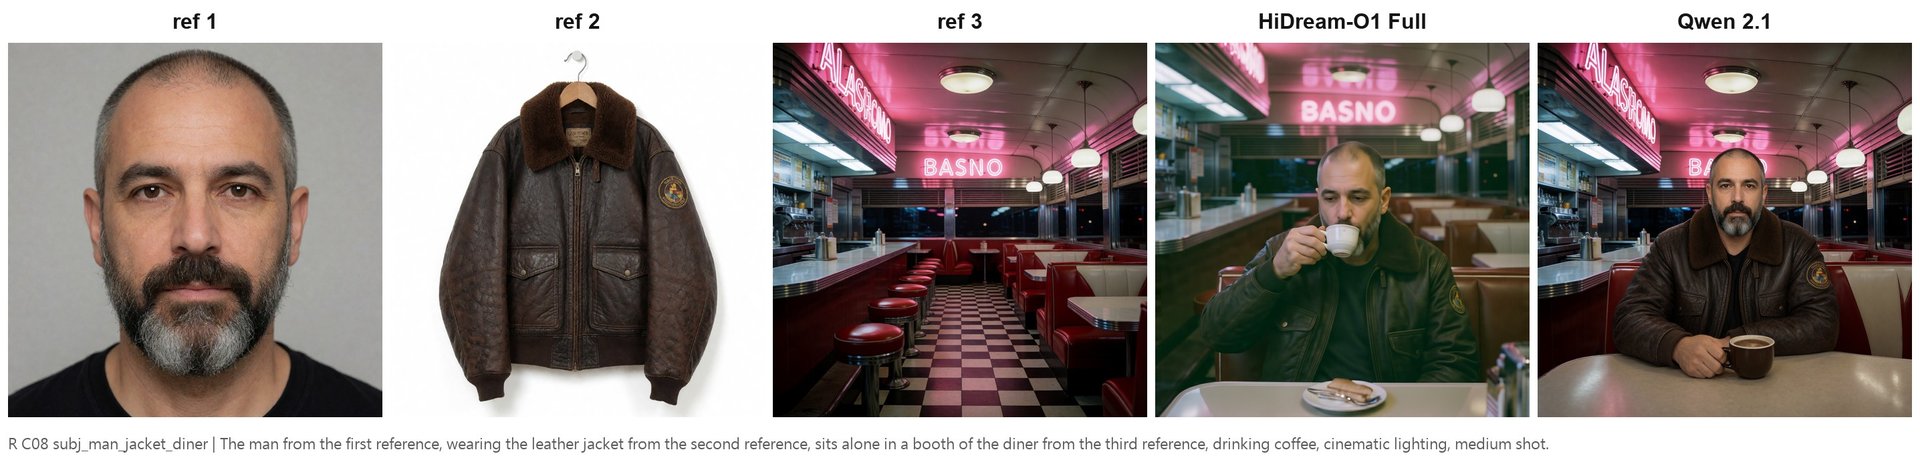
- 打折的宣稱:多張參考圖合成。臉、雀斑、配件、場景霓虹都保得住,但會把主角畫成兩個人、物件比例不對、光影像貼上去的,整體融合輸給 HiDream-O1
- 繁體中文:53 題有 30 題勝出,與 SenseNova U1.5 並列目前最穩的選擇,明顯優於同門的 Qwen 2512;輸的集中在菜單、詩句這類小字密度高的題目
- 原生 2K:十題全部贏過「先生 1024 再用 SeedVR2 放大」,毛髮、水花、皮膚毛孔都是真的畫出來的細節
- 授權要注意:Qwen Research License,非商用,跟上一代的 Apache-2.0 不同
先認識一下這個模型
先解釋兩個名詞。
alpha 通道:一般圖片每個像素有紅、綠、藍三個數值,透明圖片多一個 alpha 數值記錄「這個點有多不透明」。過去要拿生圖結果去合成,都是先生一張有背景的圖,再用去背模型把主體切出來;去背模型輸出的 alpha 大多是「在主體上就是不透明、不在就是透明」的實心遮罩,玻璃、煙這類本身半透明的東西它給不出中間值。Qwen-Image-2.1 的 VAE 直接多學了一個 alpha 通道,模型畫圖的時候就把透明度一起畫出來,這是它跟其他模型最不一樣的地方。
參考圖編輯:把一張或多張圖跟一句指令一起送進模型,模型看著參考圖畫新的一張。一張參考圖的用法是「改這張圖的某個地方」;多張參考圖的用法是「第一張的人穿第二張的衣服坐在第三張的場景裡」,prompt 裡用 <image1>、<image2> 指涉。上一篇 HiDream-O1 在多參考合成表現很好,這篇拿同樣的參考圖與指令對照。
它的規格:畫圖的部分 7B 參數、32 層單流 DiT;文字編碼器是 Qwen3-VL 8B;原生 2048×2048,也支援 2400×1792、2752×1536 這類比例。官方預設 25 步、CFG 1,沒有 shift 節點。ComfyUI 在開源當天就原生支援,需要 0.37.0 以上,範本庫裡有文生圖、編輯、去背三個工作流。
這次怎麼測
| 章節 | 題目 | 對照組 |
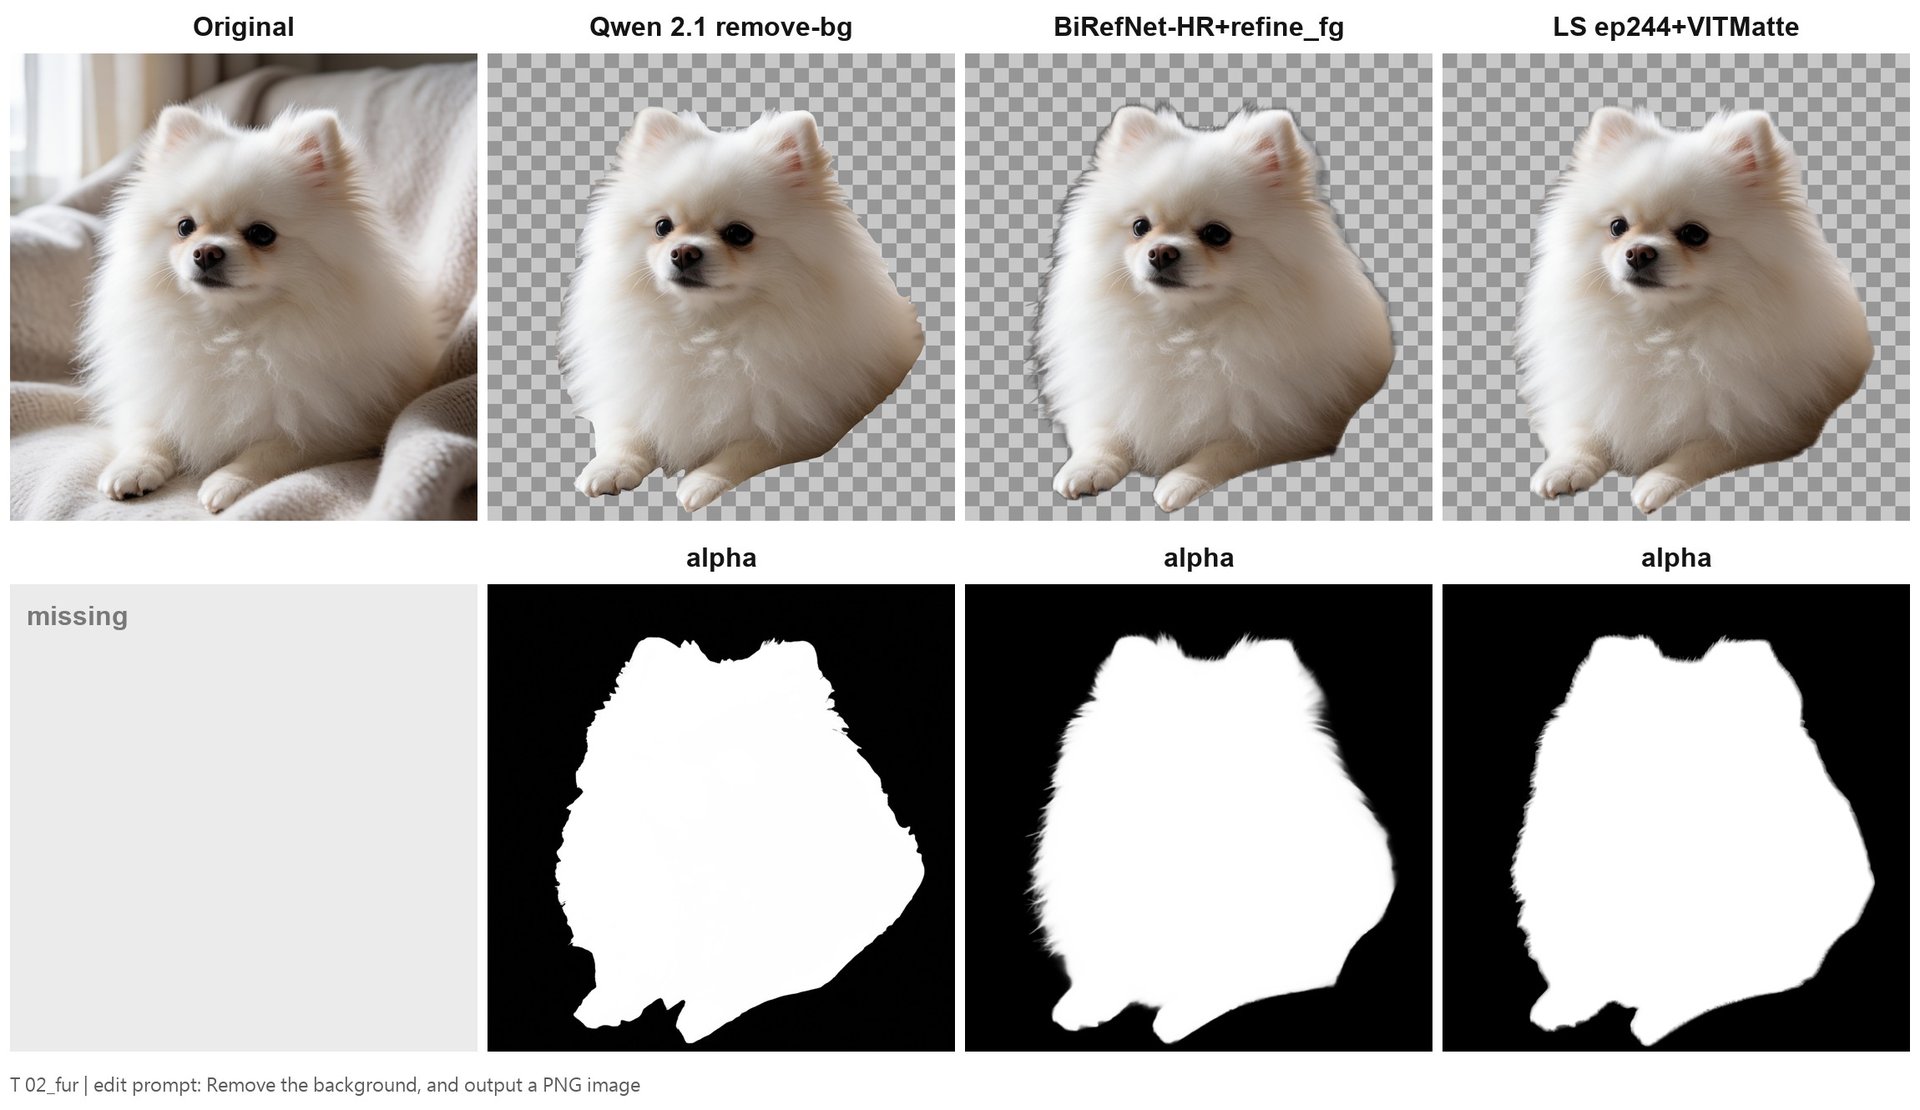
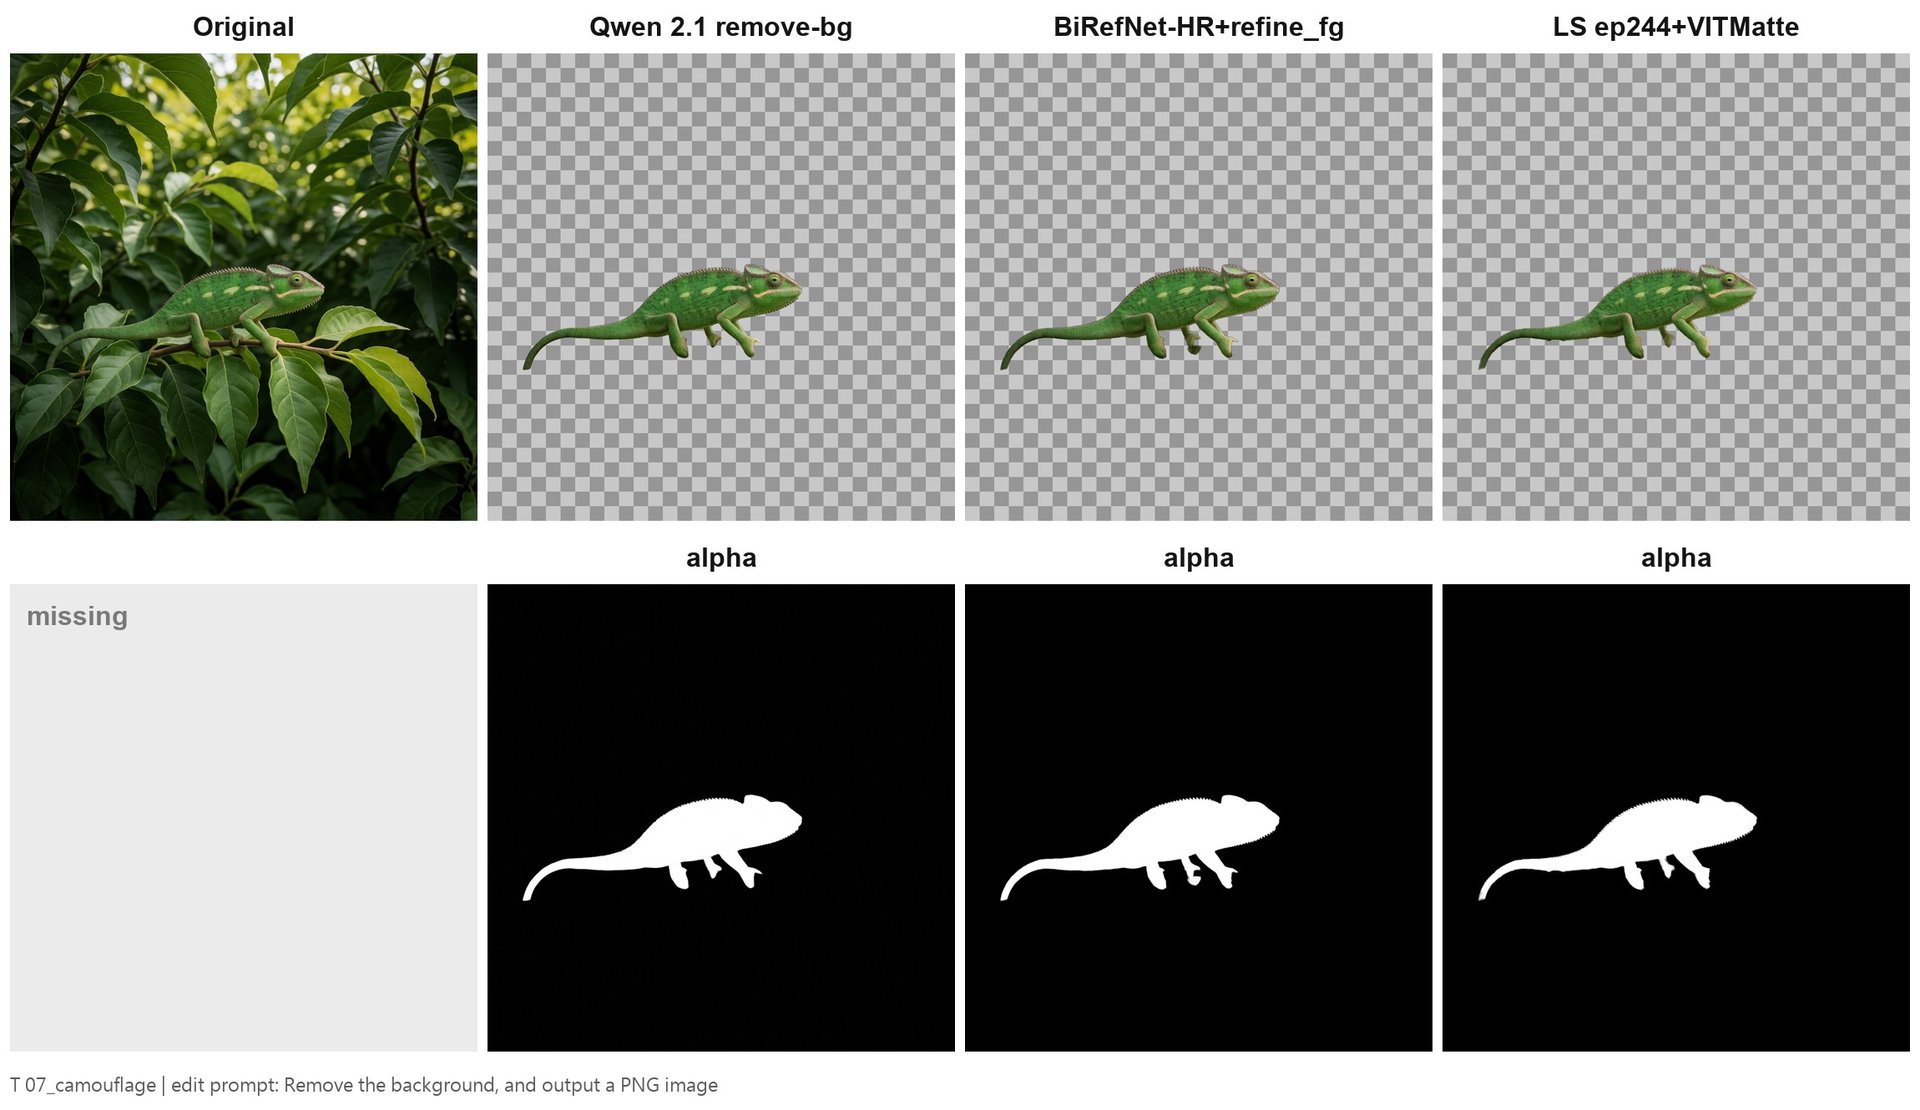
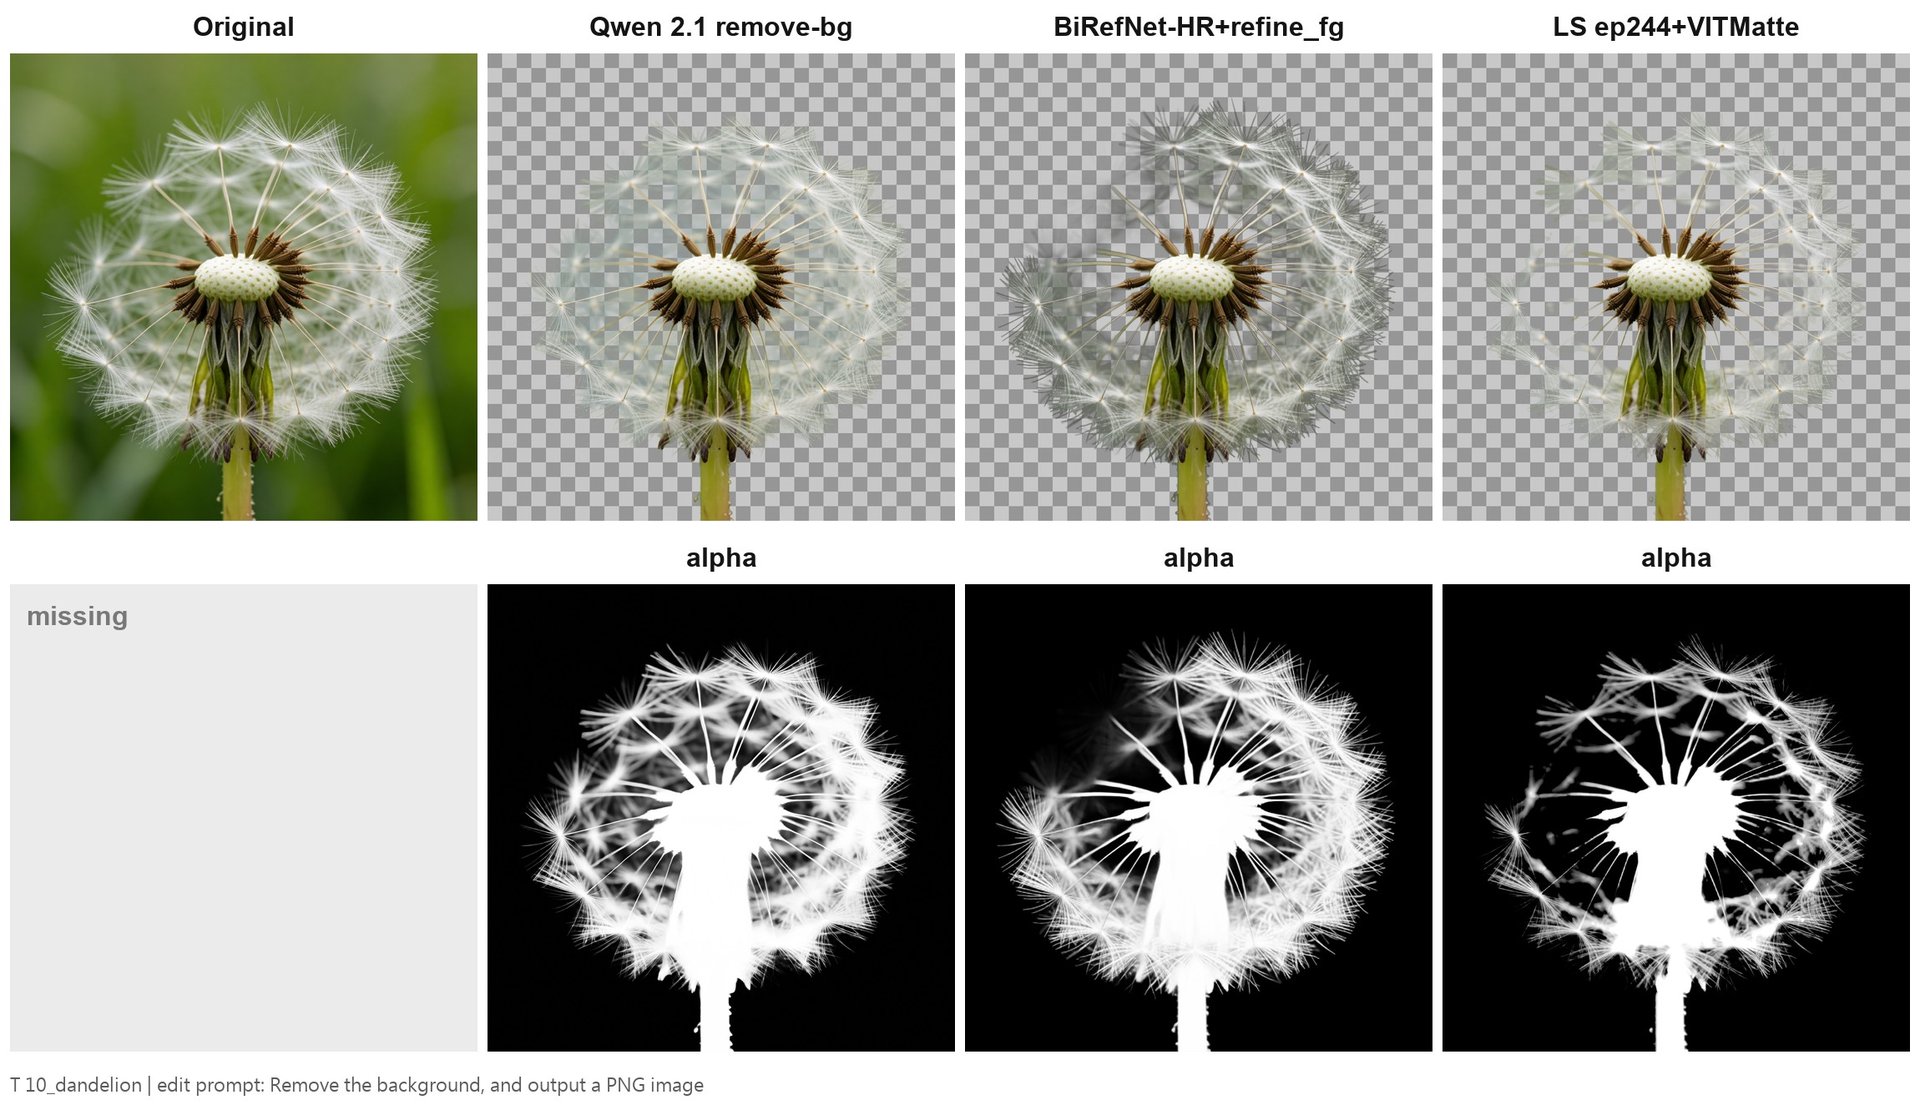
| T 透明輸出 | 去背評比的 15 張測試圖走它的去背模式;另出 8 題細邊緣主題(髮絲、玻璃、煙、薄紗、蒲公英、羽毛、細鍊),同 seed 生「原生透明版」與「不透明版再去背」 | BiRefNet-HR、LayerStyle BiRefNet+VITMatte(去背評比的前段班) |
| R 參考圖編輯 | HiDream-O1 那篇的 9 題:5 題單參考編輯、4 題多參考合成,同參考圖同指令 | HiDream-O1 Full |
| B 文生圖基線 | 35 題常用題庫、12 題數量顏色位置考題、繁體中文 53 題 | Krea2 Turbo、Lens、SenseNova、HiDream-O1、Kroma、Z-Image、Qwen 2512 等 |
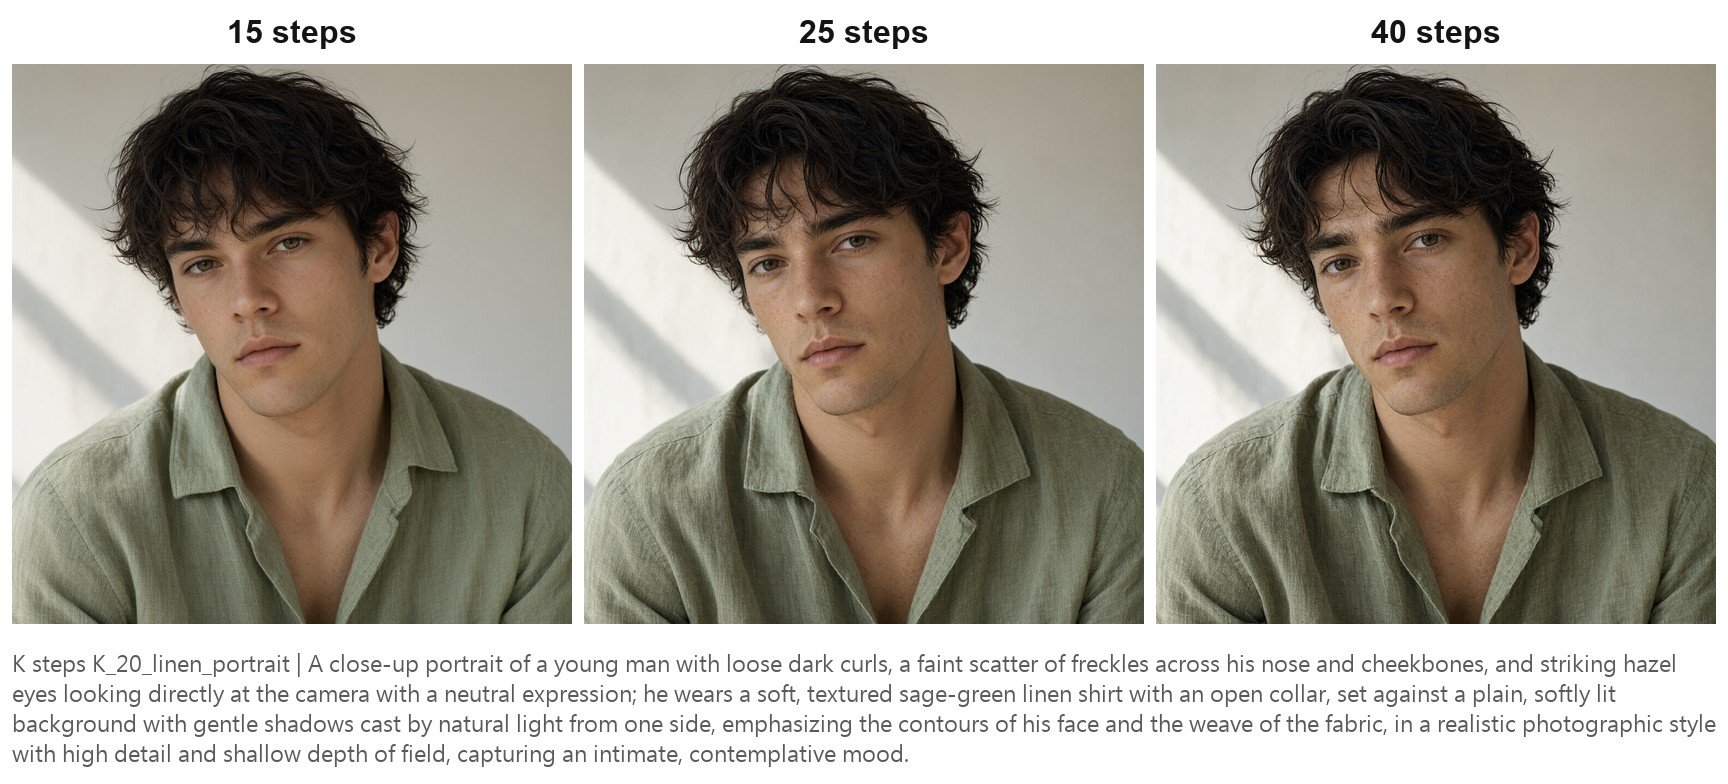
| K 原生 2K | 10 題細節多的題目,同 seed 生 2048² 直出,另生 1024² 用 SeedVR2 3B 放大到 2048;6 題比 15、25、40 步 | 自己跟自己比 |
模型檔用 bf16 的擴散模型加 int8 的文字編碼器,全部 25 步、CFG 1、euler simple,就是官方範本的設定。每一組的 prompt 都印在對照圖底部,判定的欄位順序也寫在圖上。
幾件要先講清楚的事:去背測試集那 15 張是 Krea2 生成的合成圖,不是真實照片;細邊緣那 8 題的「透明版」與「不透明版」雖然同 seed,但 prompt 多了一句透明的包裝句,構圖會不一樣,是同題不同圖的比較;參考圖編輯的 9 張參考圖也是 AI 生成的。判定以我的眼睛為準,不是自動評分。
T. 透明輸出:半透明的東西它獨贏,一般去背還是交給專用模型
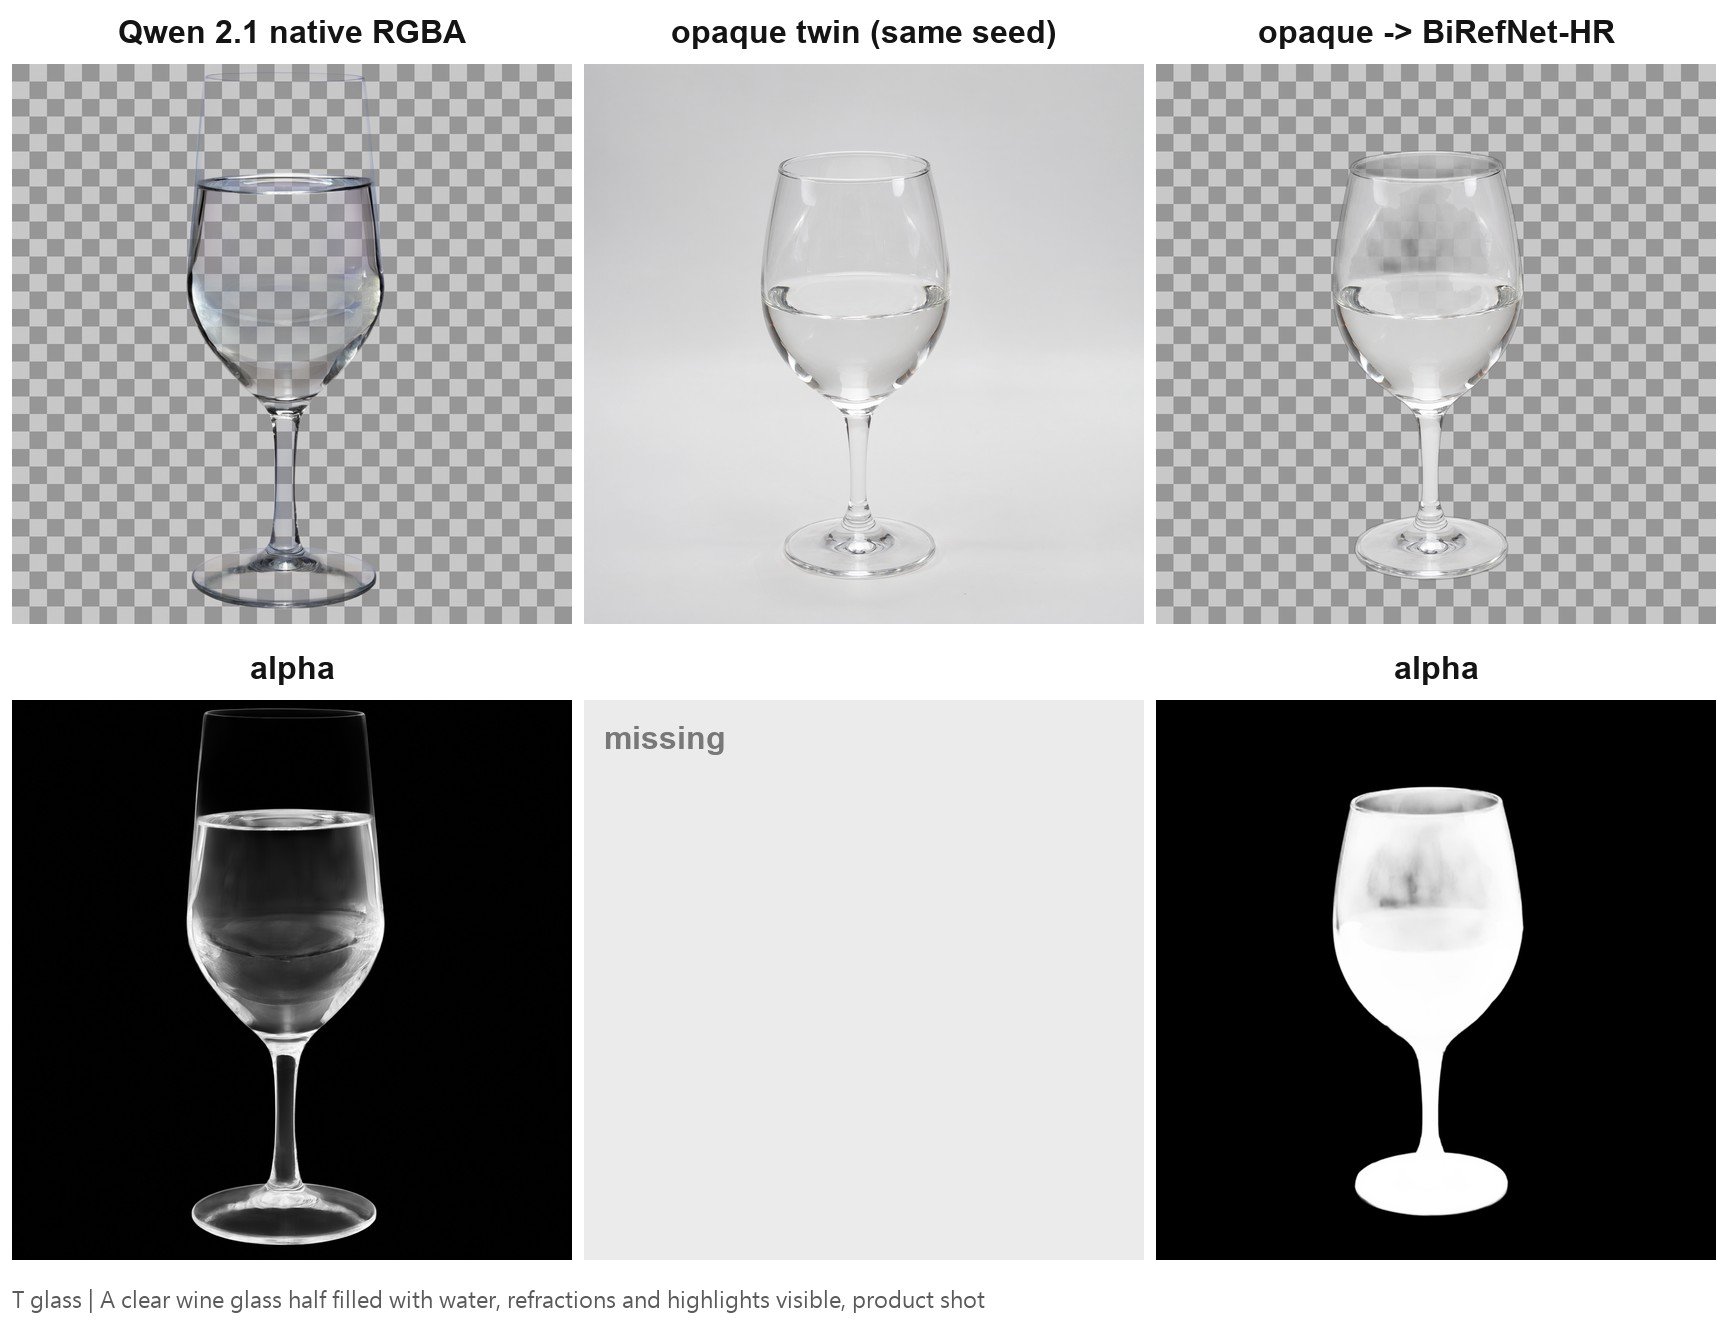
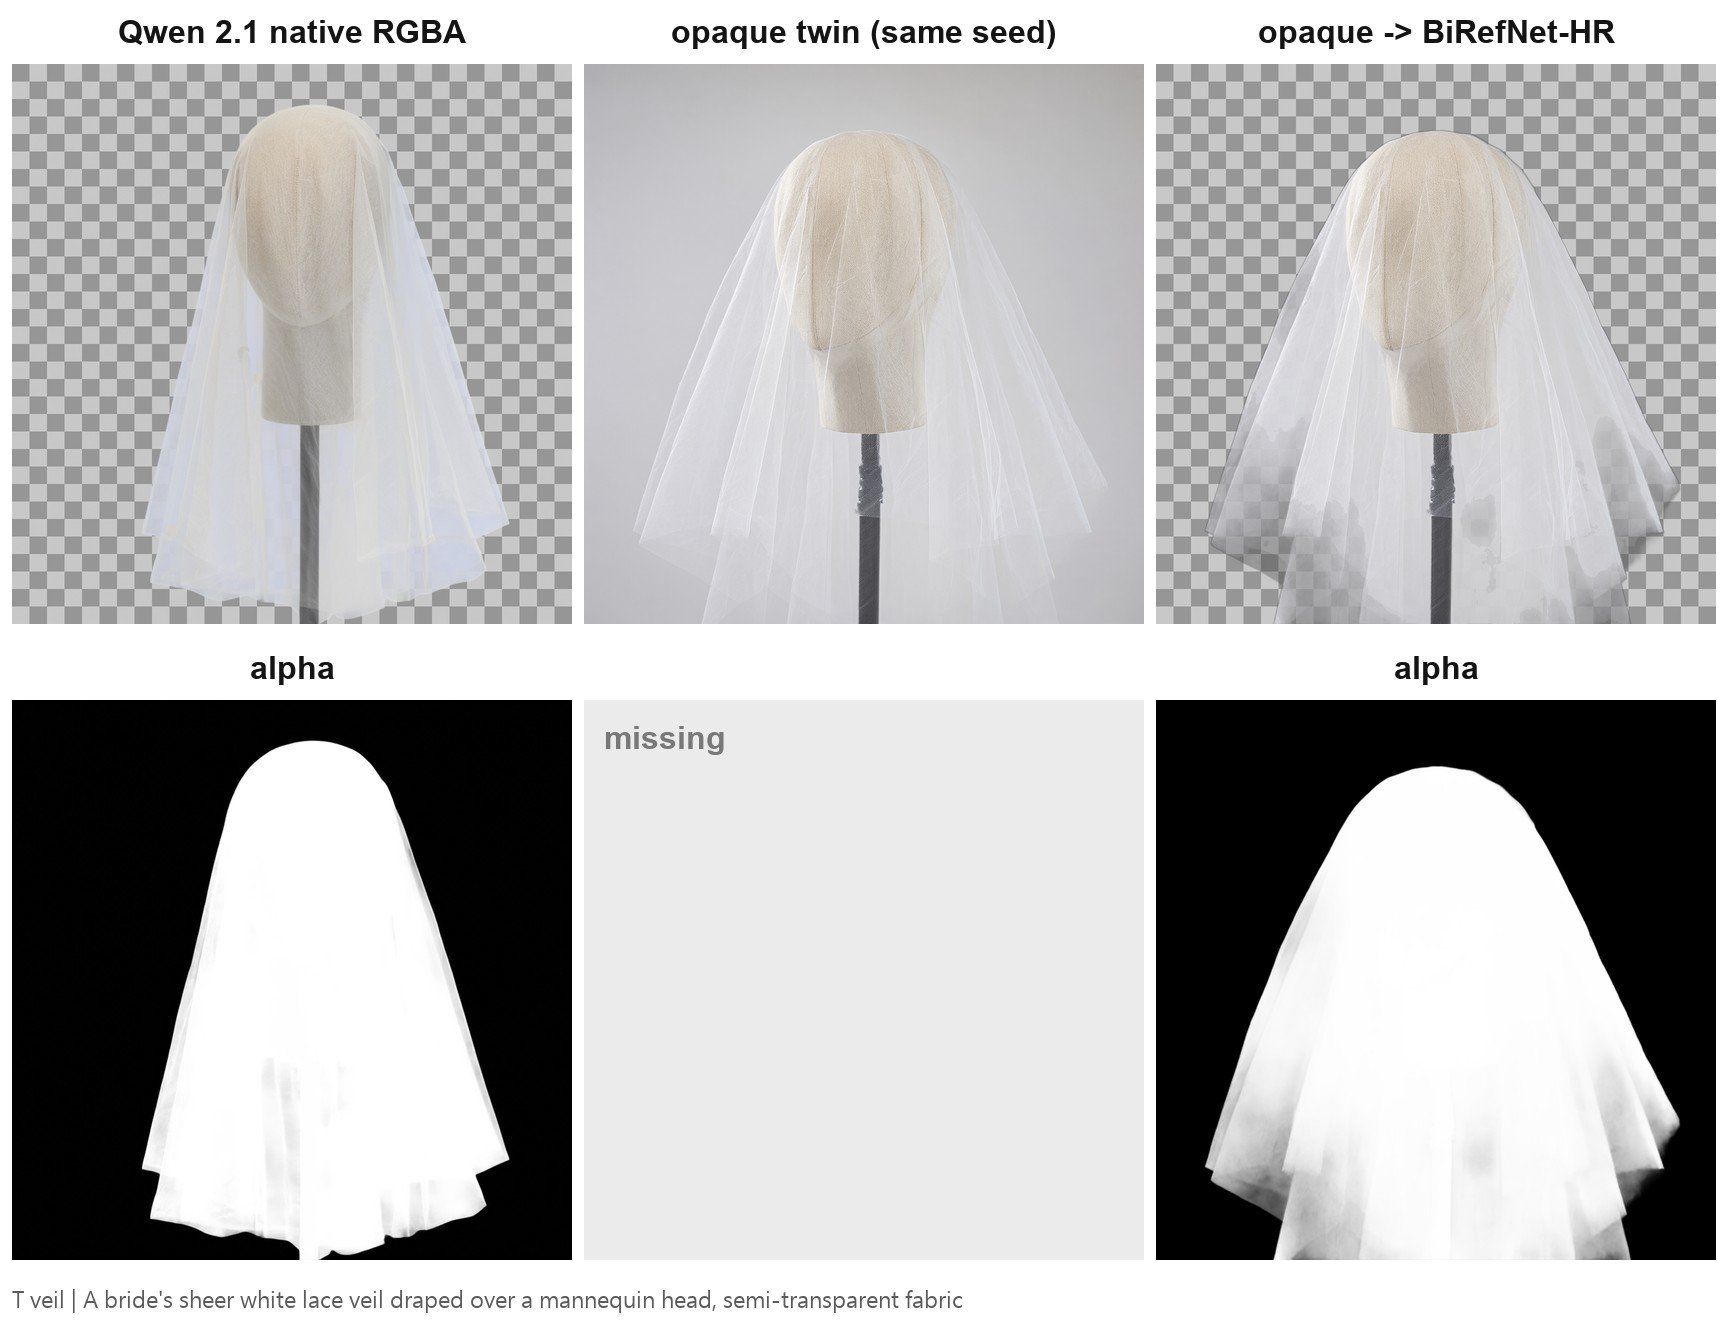
先看它最特別的能力。8 題細邊緣主題裡,玻璃杯這題最能說明差別:原生透明版的杯身 alpha 是有層次的灰階,透過杯子看得到後面的棋盤格;不透明版交給 BiRefNet 去背,杯子就是一塊實心白。
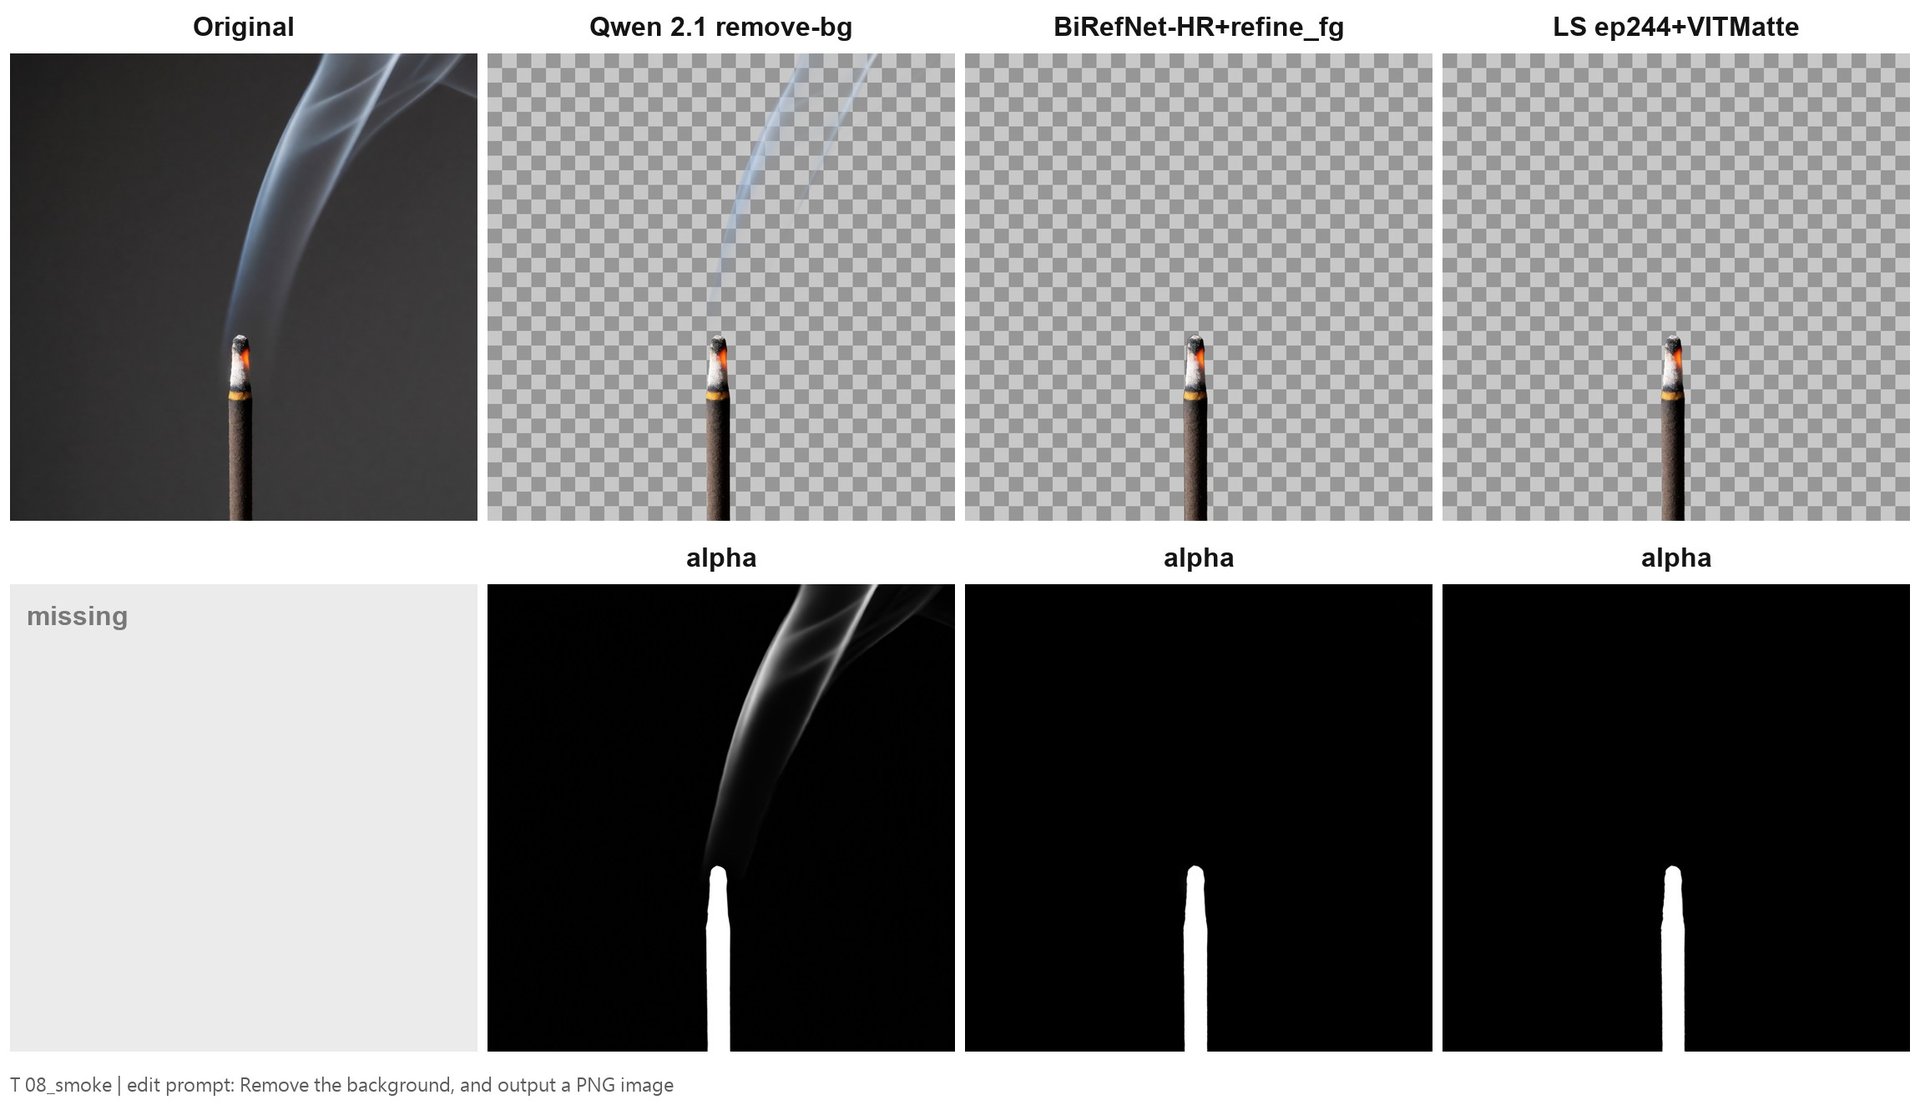
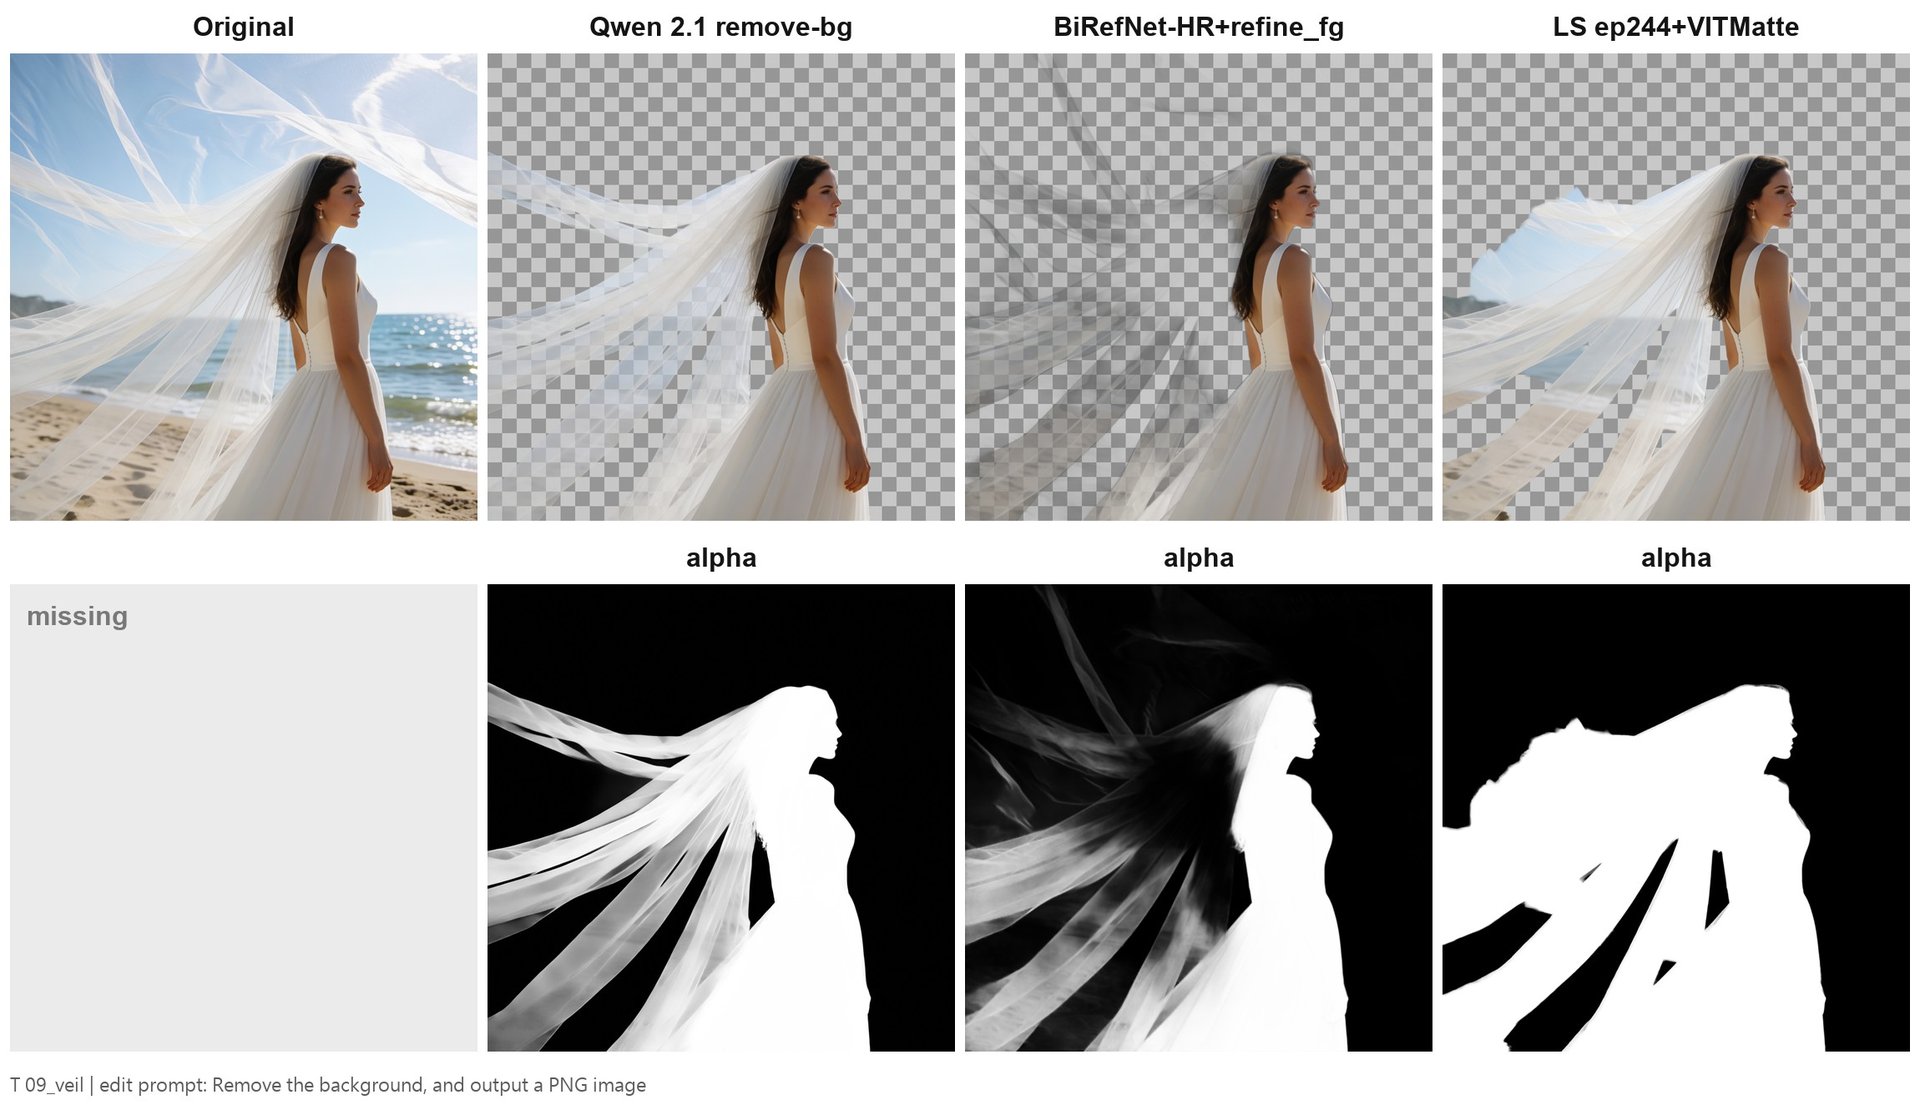
去背測試集那 15 張也是一樣的趨勢。線香的煙、新娘的頭紗,只有它的 alpha 是半透明的;BiRefNet 的頭紗雖然也有透明度,中間卻斷了一段。
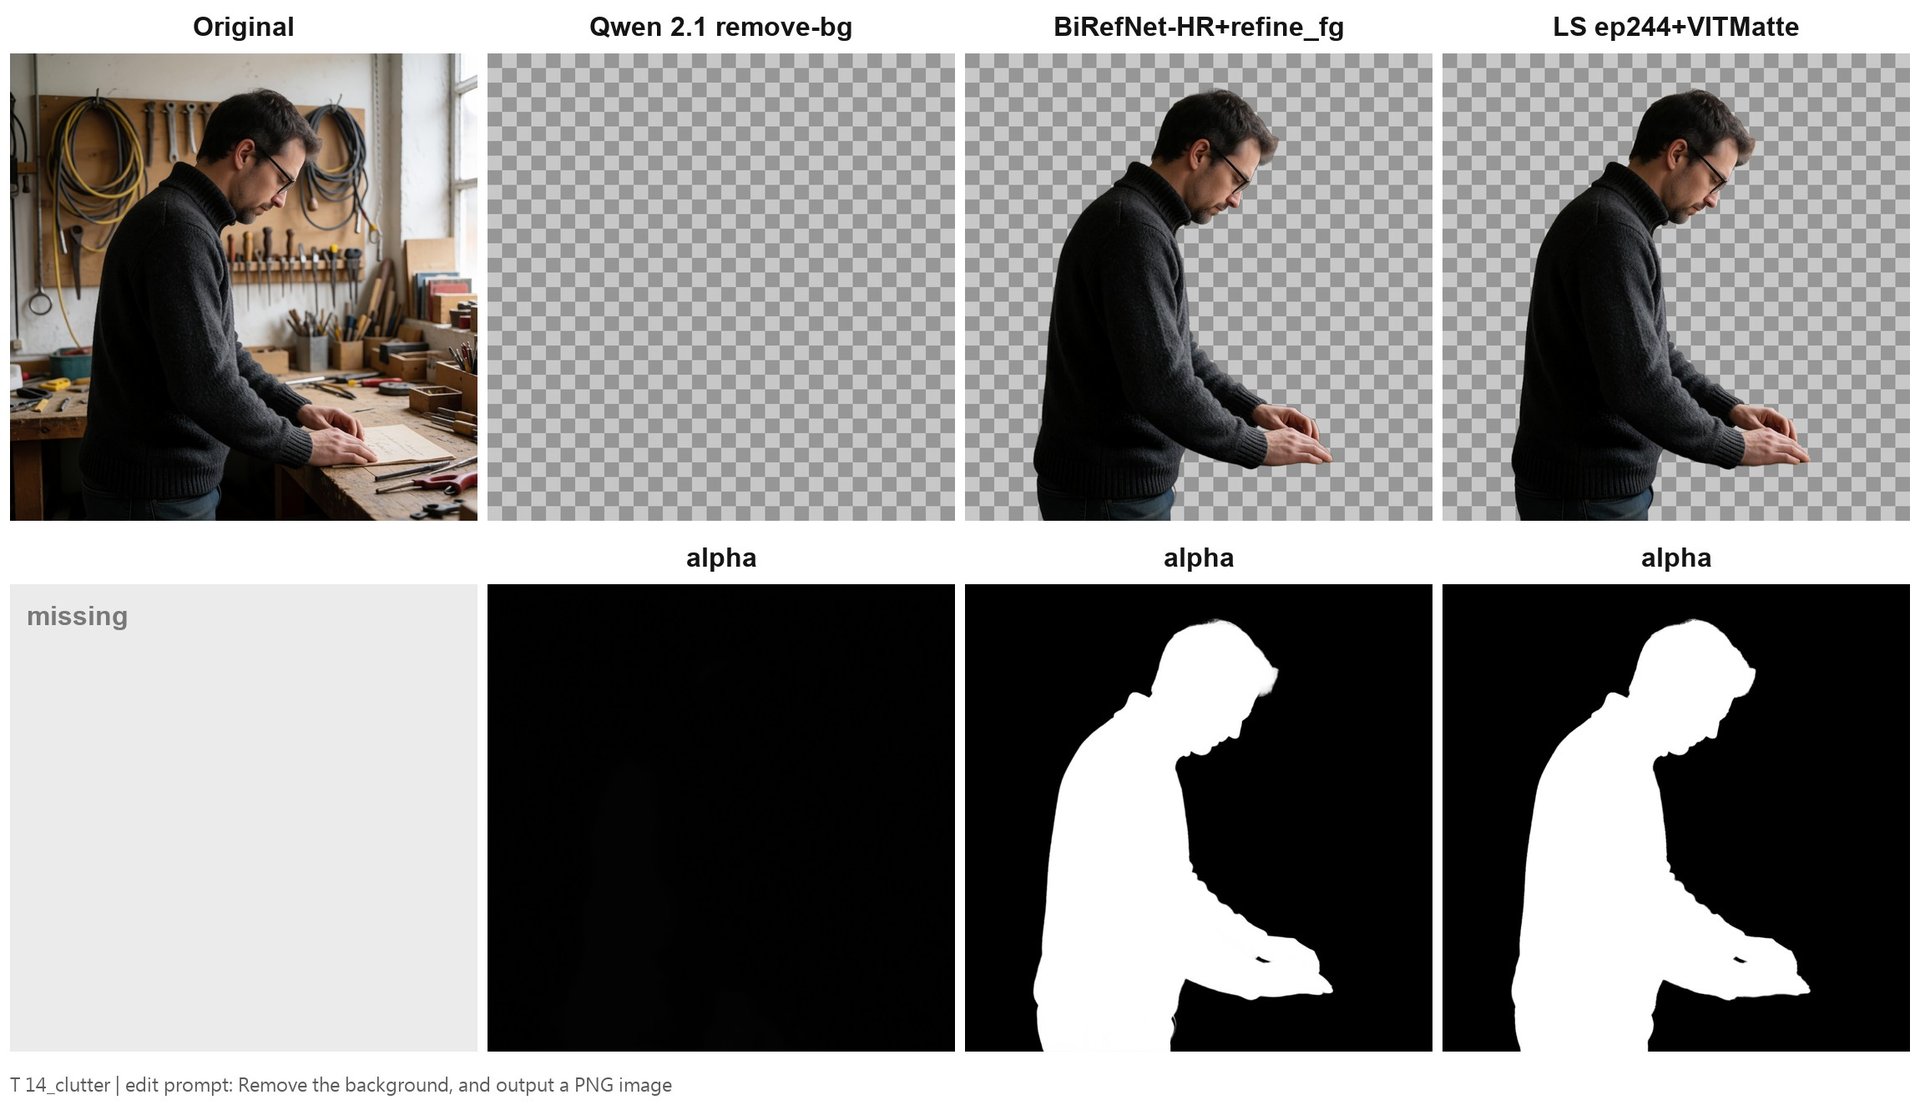
但拿它當一般去背工具就不是這回事。髮絲題它把背景的散景光點當成前景留了下來;毛髮題所有邊緣都沒有細節;最嚴重的是雜亂工作檯前的人像與洋紅色全息主體這兩題,人物整個被切掉,BiRefNet 與 LayerStyle 都正常切出來。
細邊緣 8 題的原生透明版對上不透明版去背:髮絲、玻璃、蒲公英、羽毛四題原生透明保留較多;毛髮與薄紗尾端兩題是去背路線較好;煙與細鍊打平。
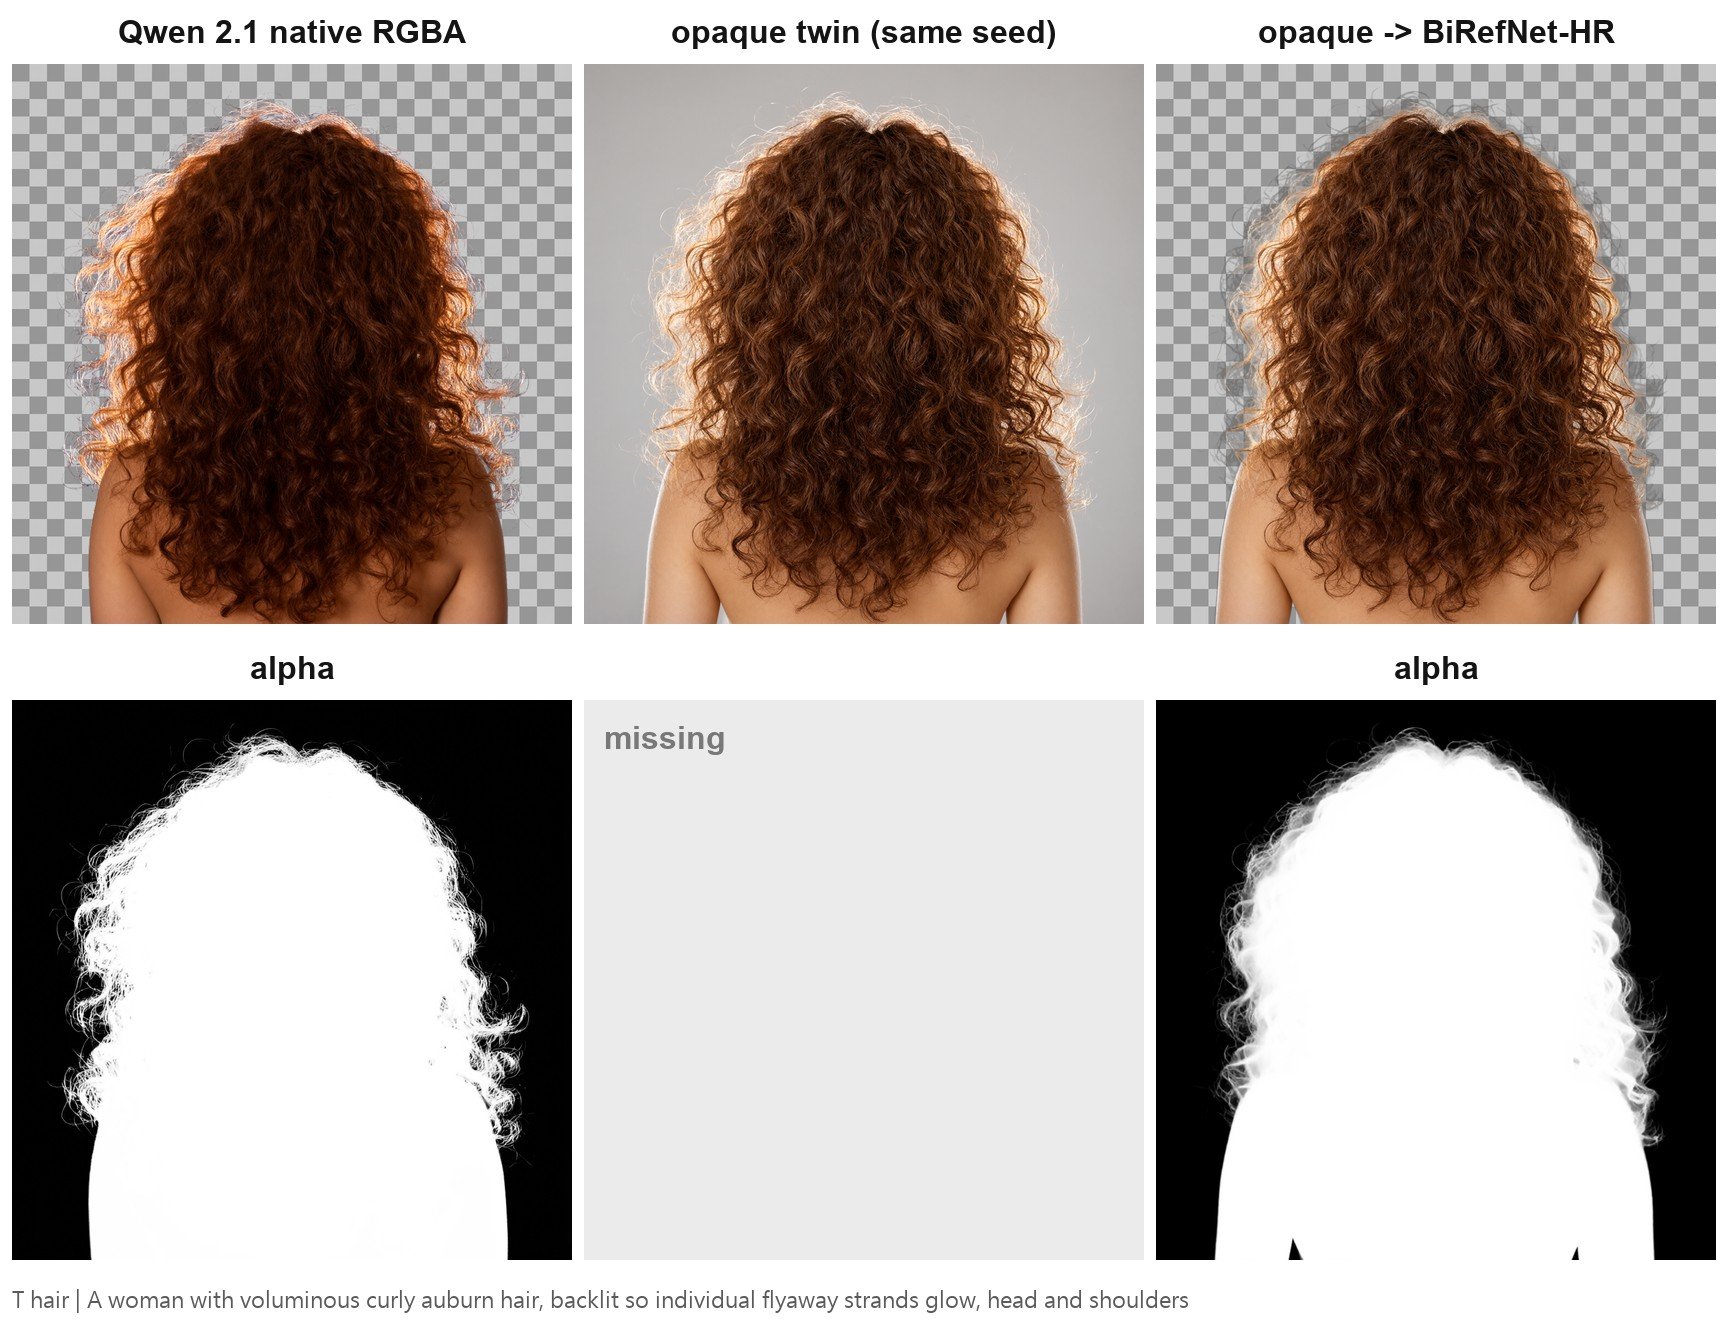
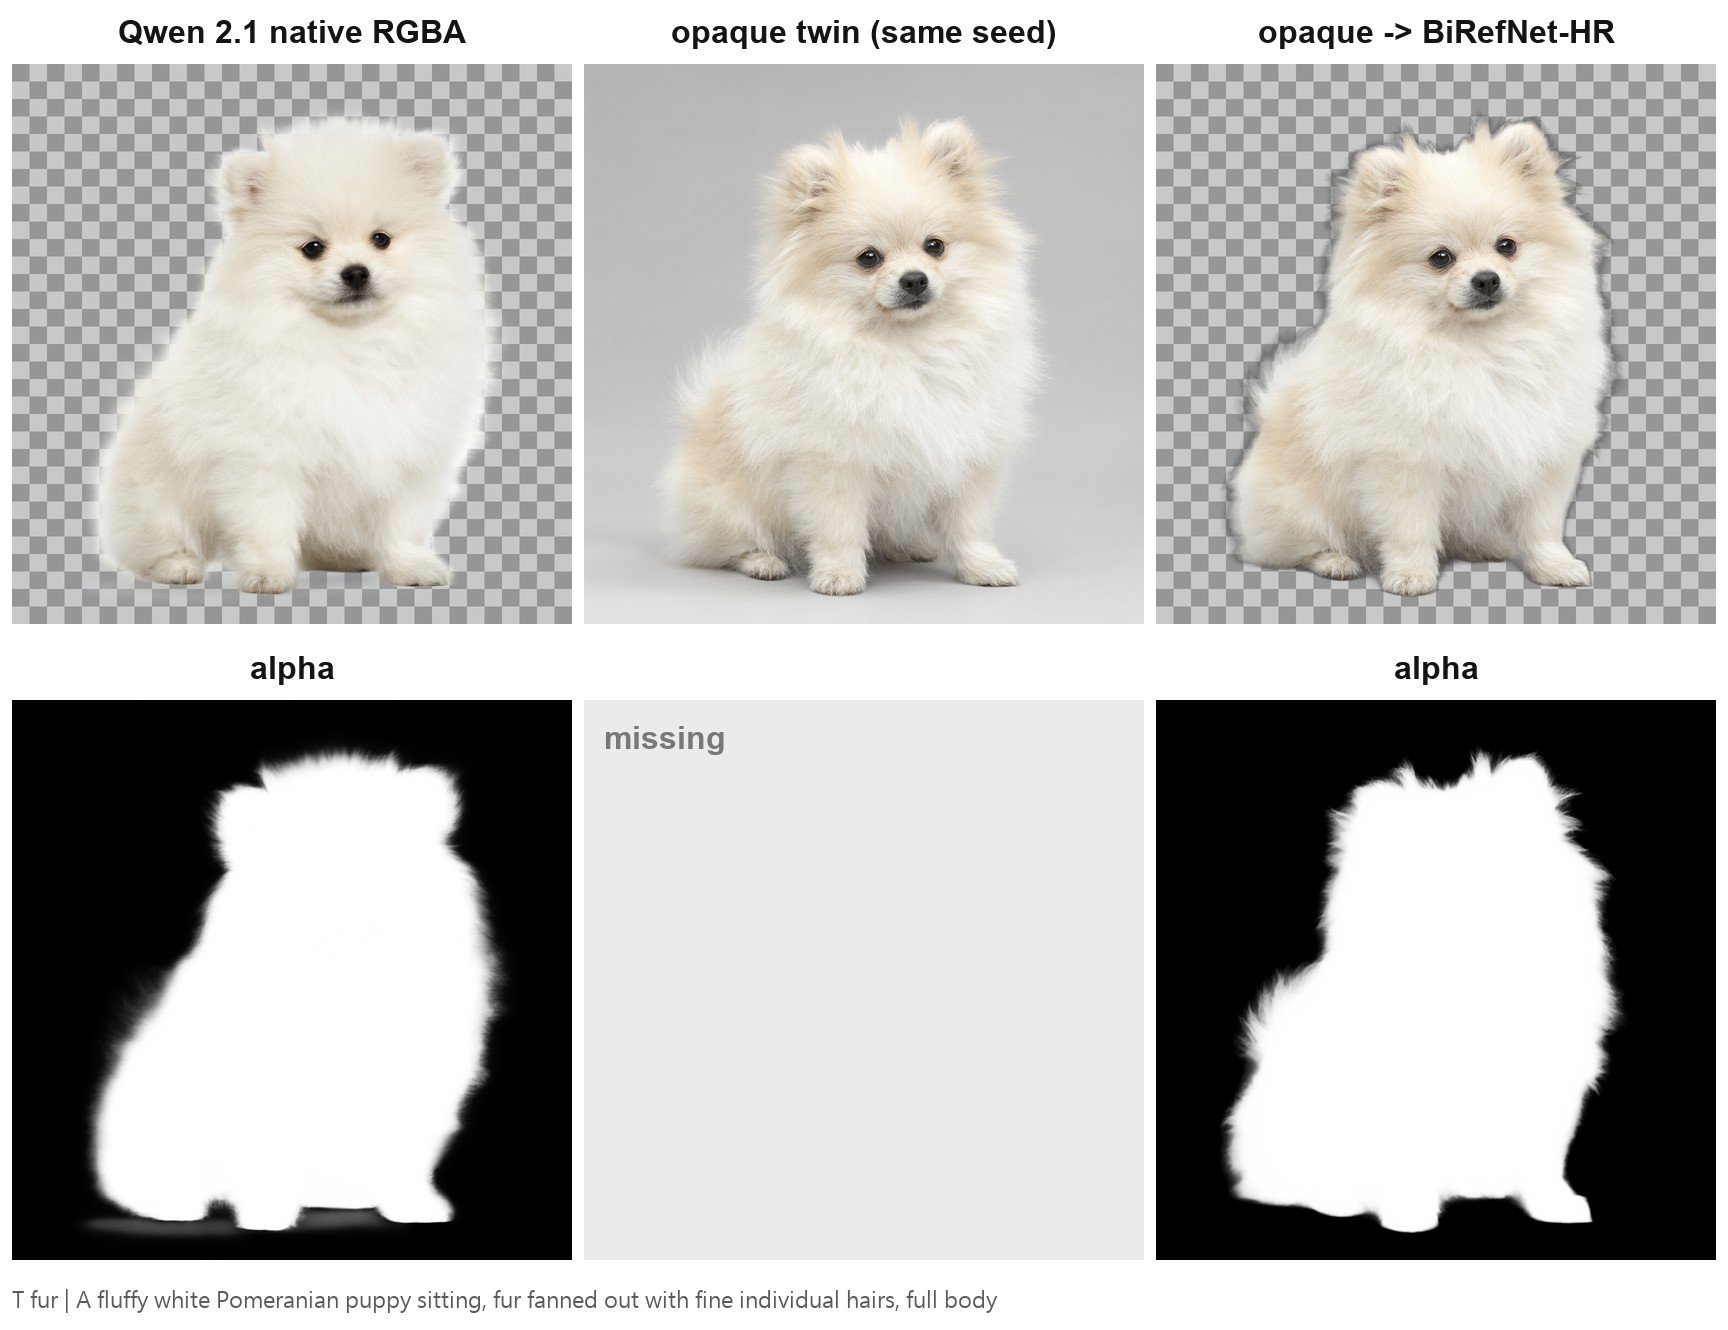
15 張去背測試集的判定是 5 勝 5 平 5 輸,8 題細邊緣是 4 勝 2 平 2 輸。結論很清楚:要真正的半透明 alpha 就用它生,要把一張既有的圖去背還是用 BiRefNet。
R. 參考圖編輯:單張參考贏,多張參考輸
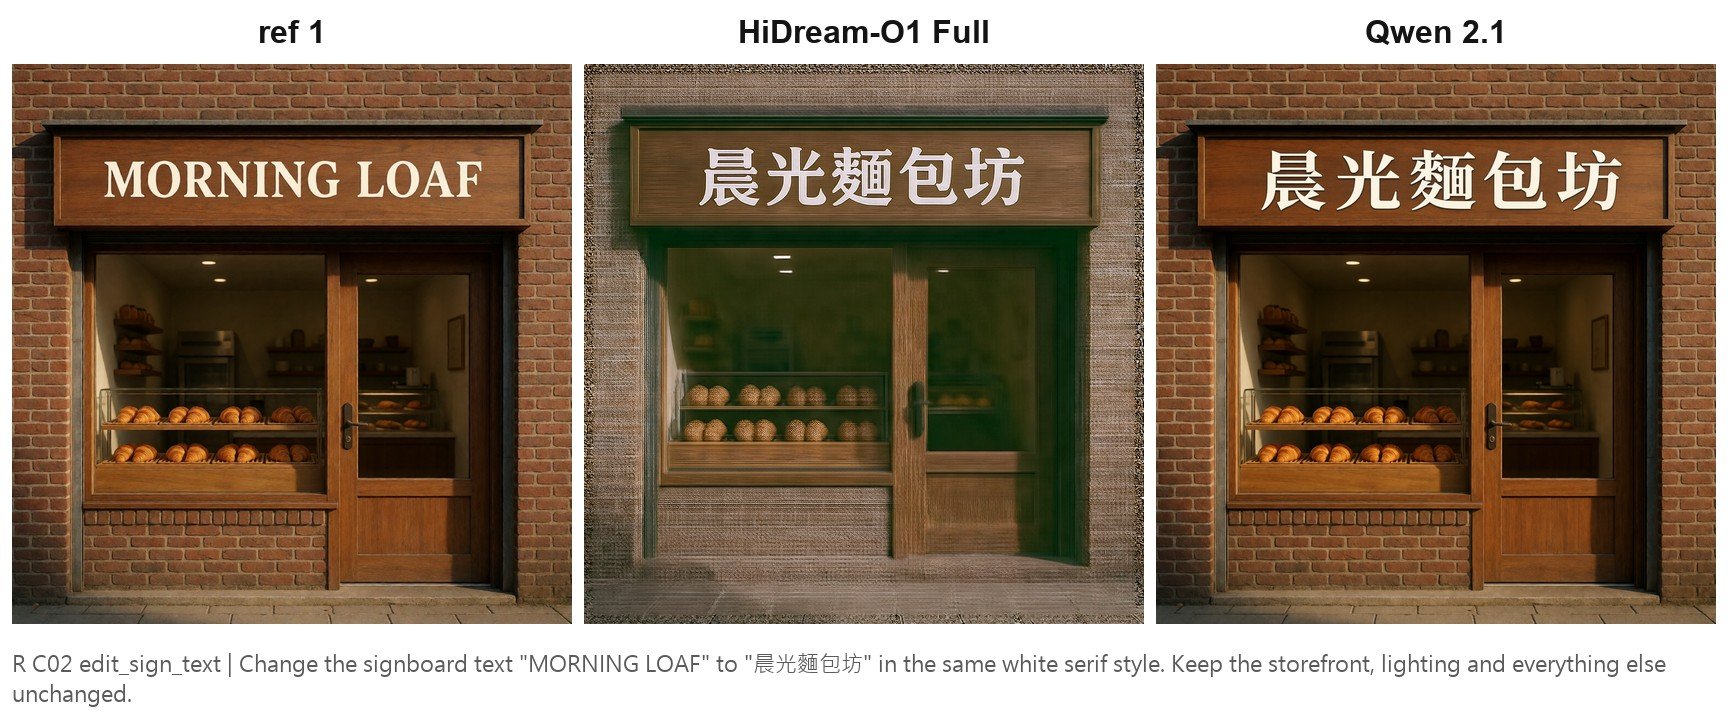
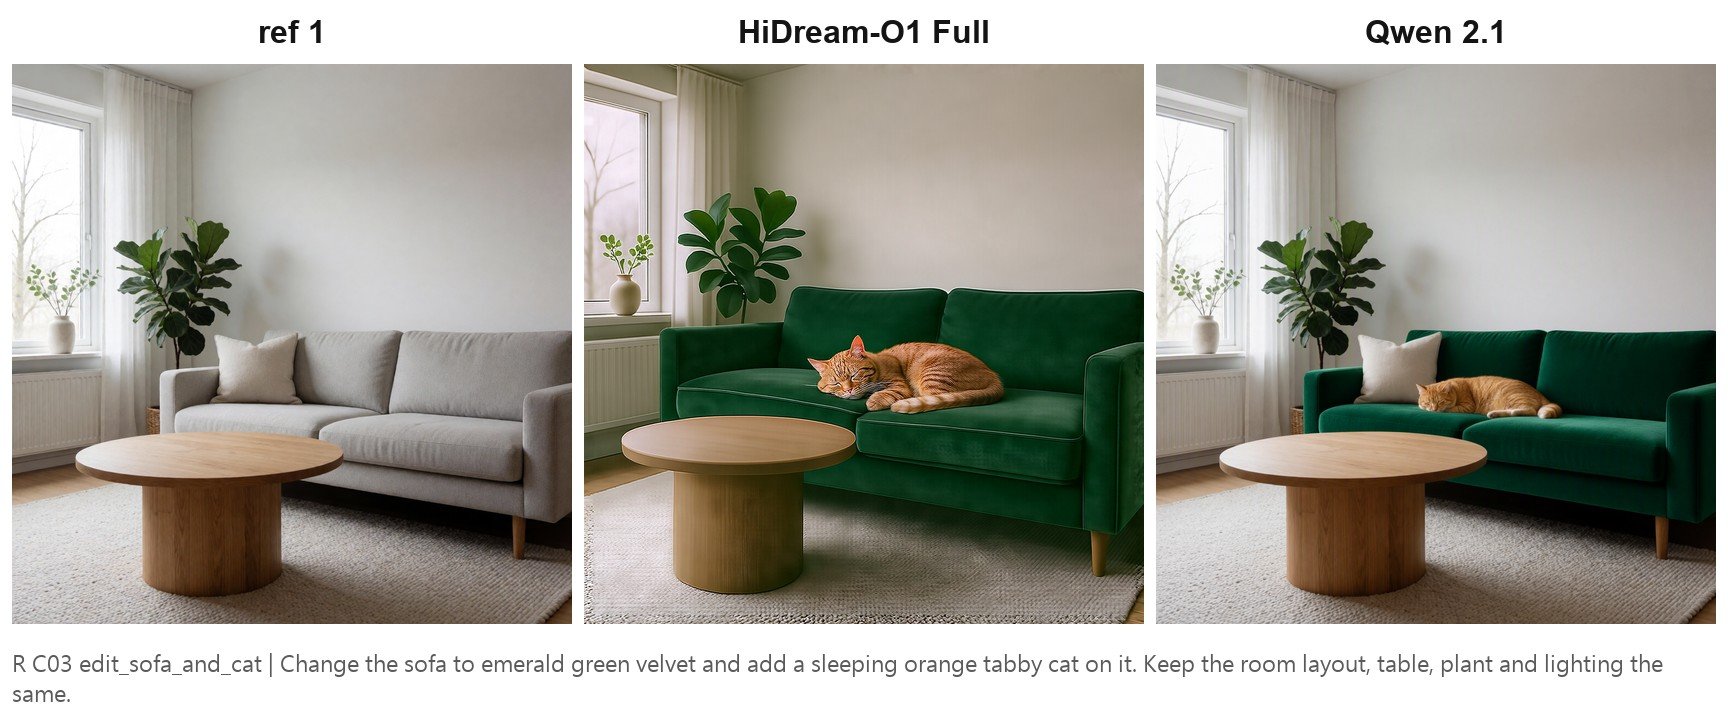
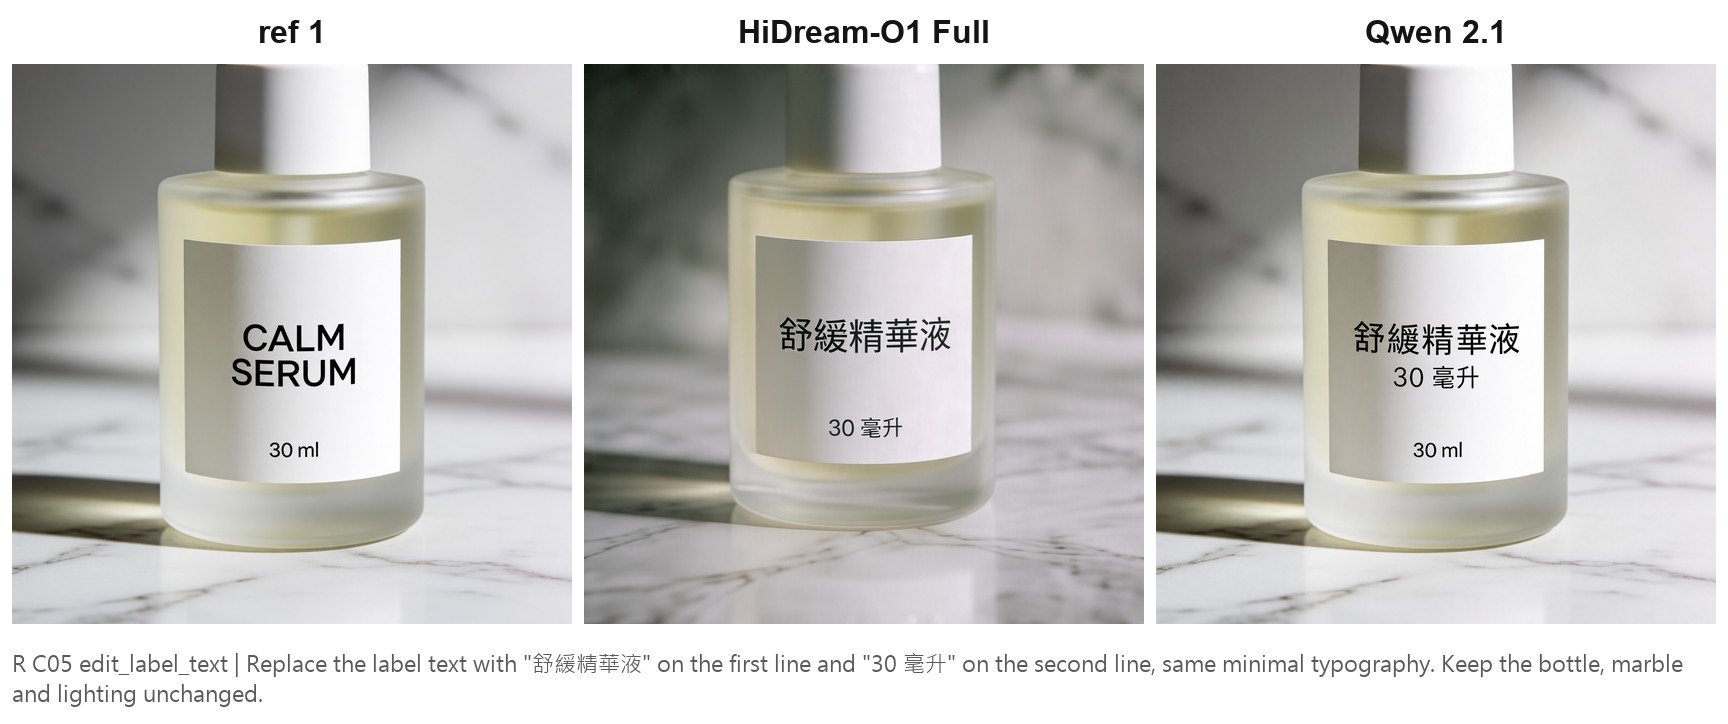
單參考編輯 5 題是 3 勝 1 平 1 輸。贏的地方都是同一件事:沒被要求改的區域幾乎不動。換招牌文字這題,HiDream-O1 整體色偏,它的字保留了原本的風格,磚牆、櫥窗、門完全沒動;換沙發材質加一隻貓這題,HiDream-O1 把沙發形狀、桌子、綠植都改了,它只動了沙發與貓。
輸的那題是換繁體中文標籤:「舒緩精華液」的「緩」寫錯,還多了一行「30 毫升」。HiDream-O1 這題文字正確但整體色偏。
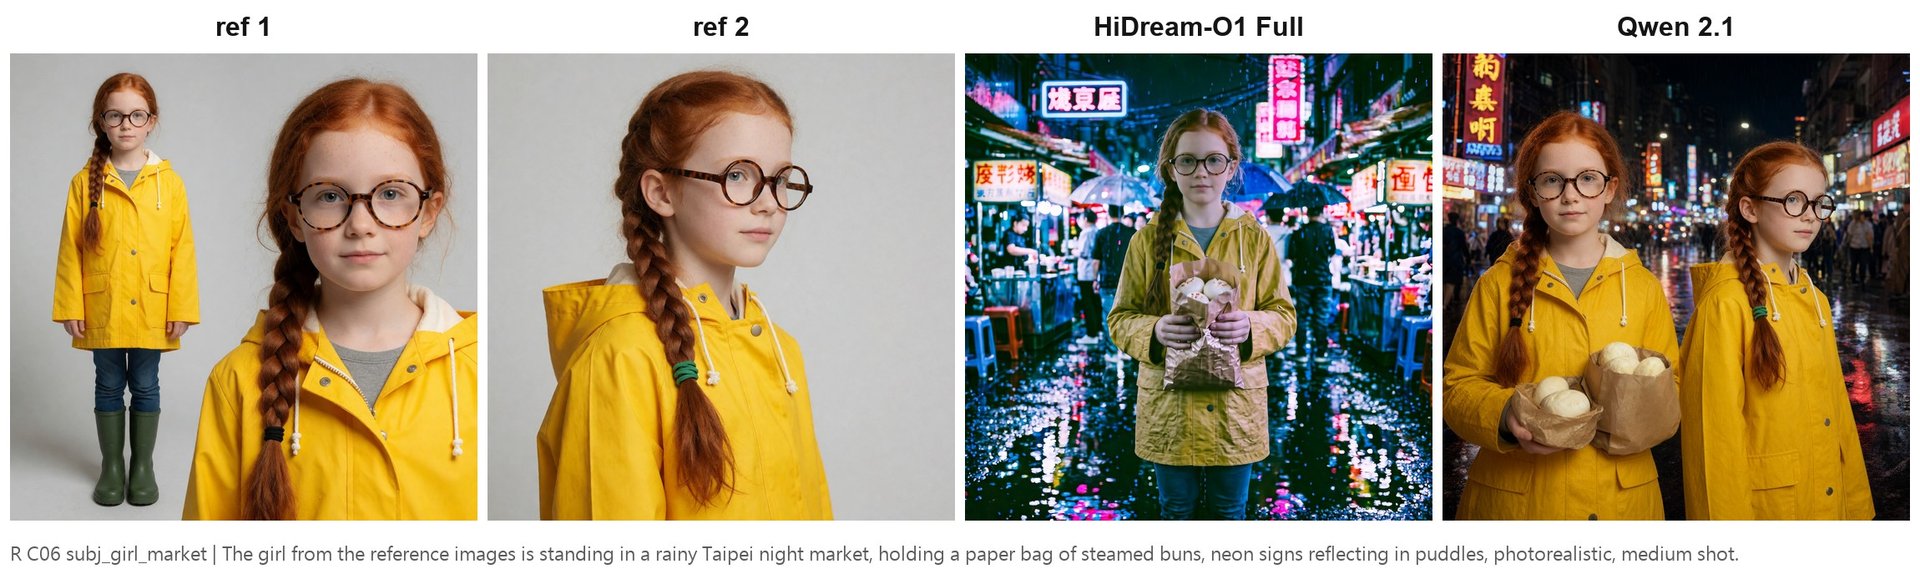
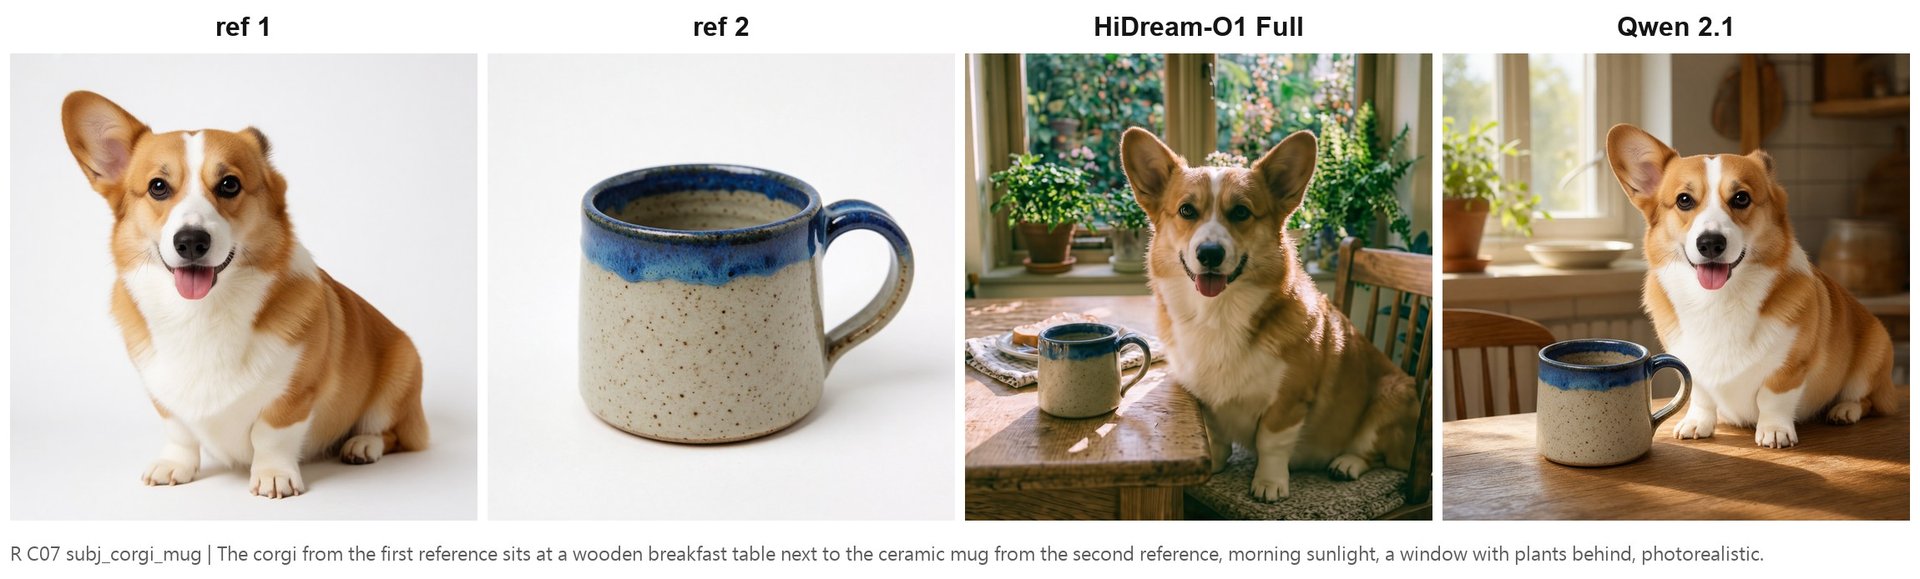
多參考合成 4 題是 1 勝 1 平 2 輸。臉、雀斑、眼鏡、辮子、夾克袖章、餐館霓虹這些細節它都保得住,問題出在融合:女孩夜市那題畫了兩個一模一樣的女孩;柯基與馬克杯那題杯子比例過大,柯基的光影跟場景不合,像貼紙貼上去的。HiDream-O1 的融合自然很多。
還有一個要揭露的觀察:我第一次測編輯時拿它自己生的圖回頭當參考,整張出現過度銳化的漂移;這 9 題的參考圖是 Krea2 生的,完全沒有這個現象。用照片或其他模型的圖當參考應該不會遇到。
B. 文生圖基線:跟誰比都不輸,繁體中文是驚喜
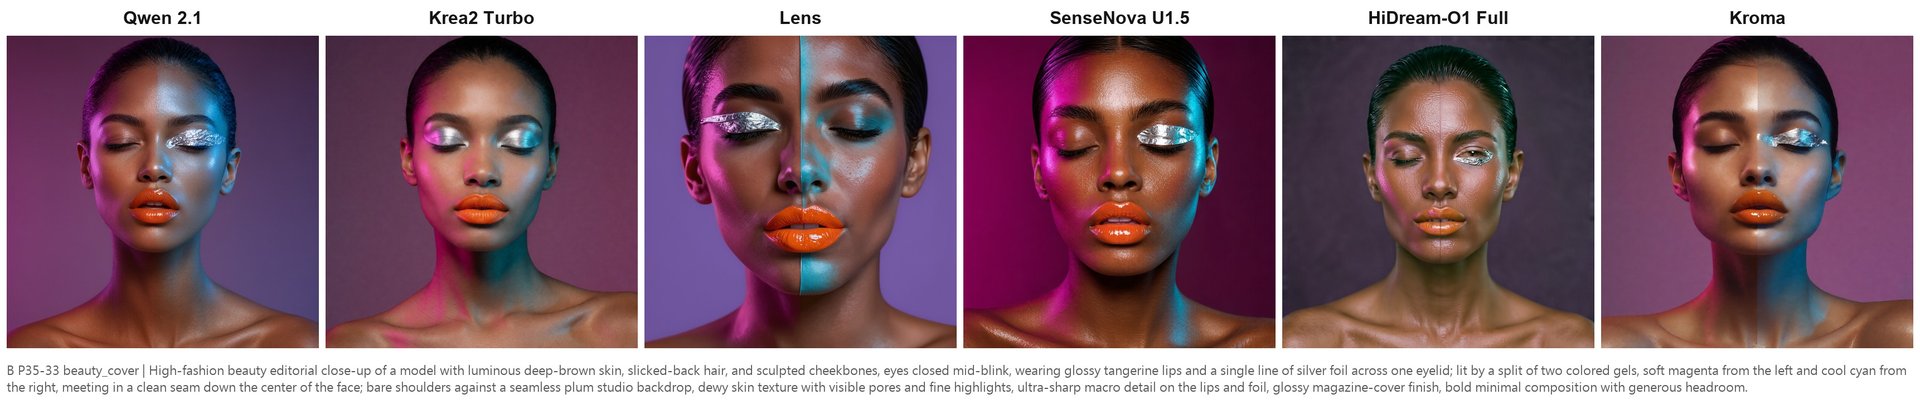
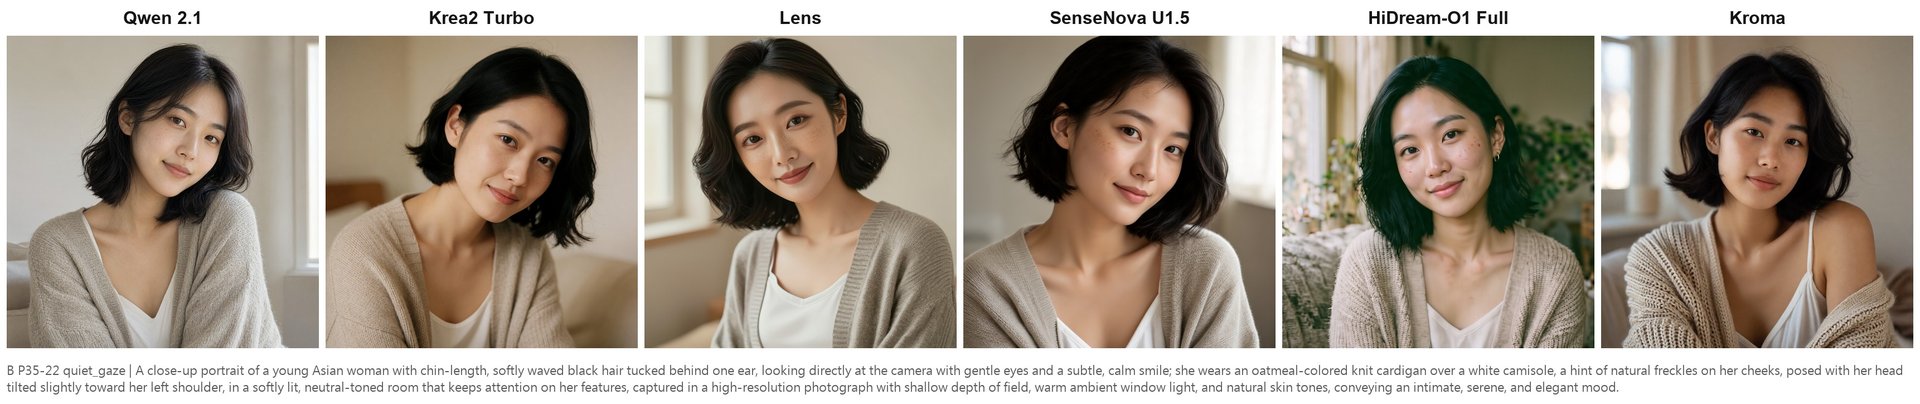
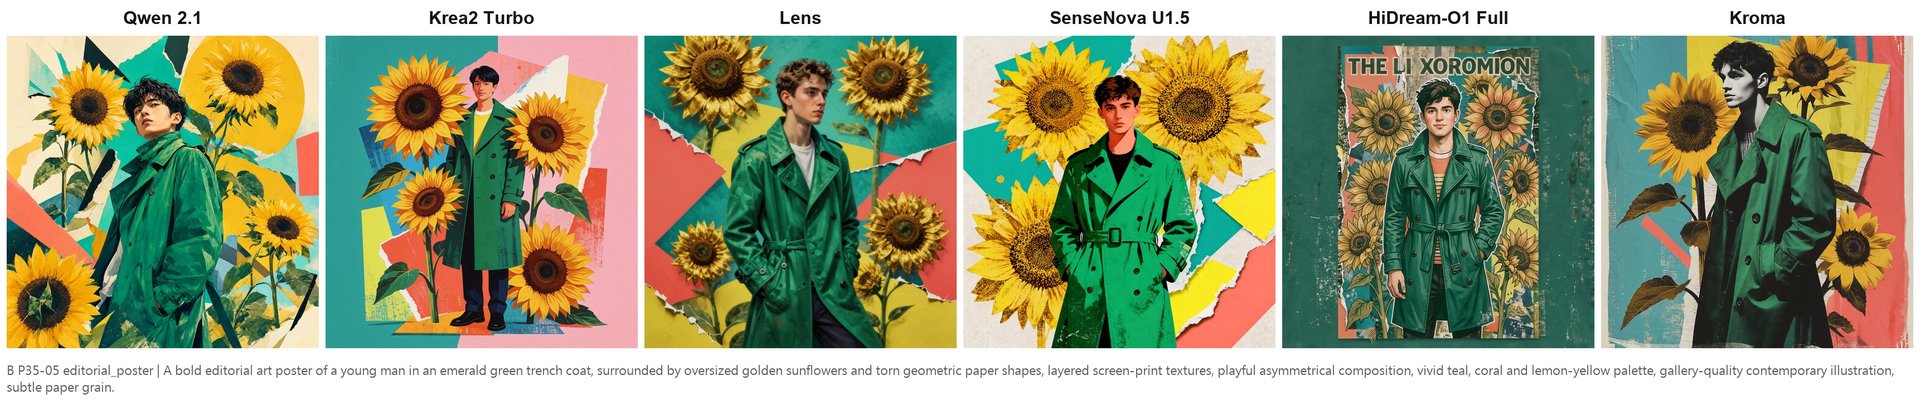
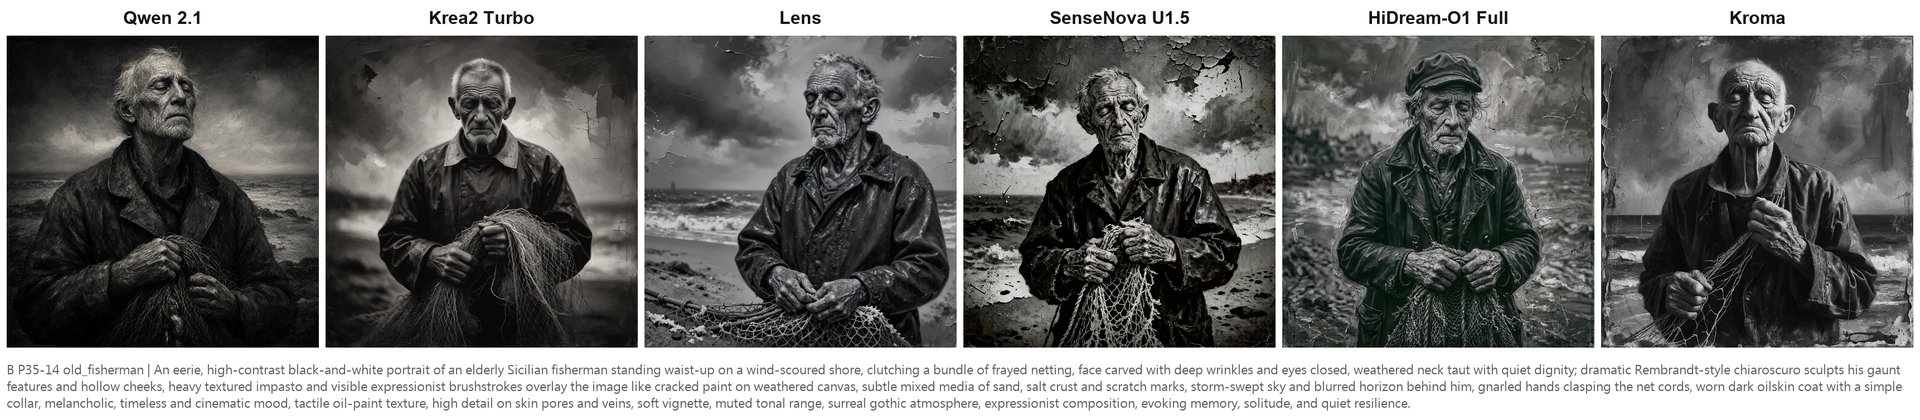
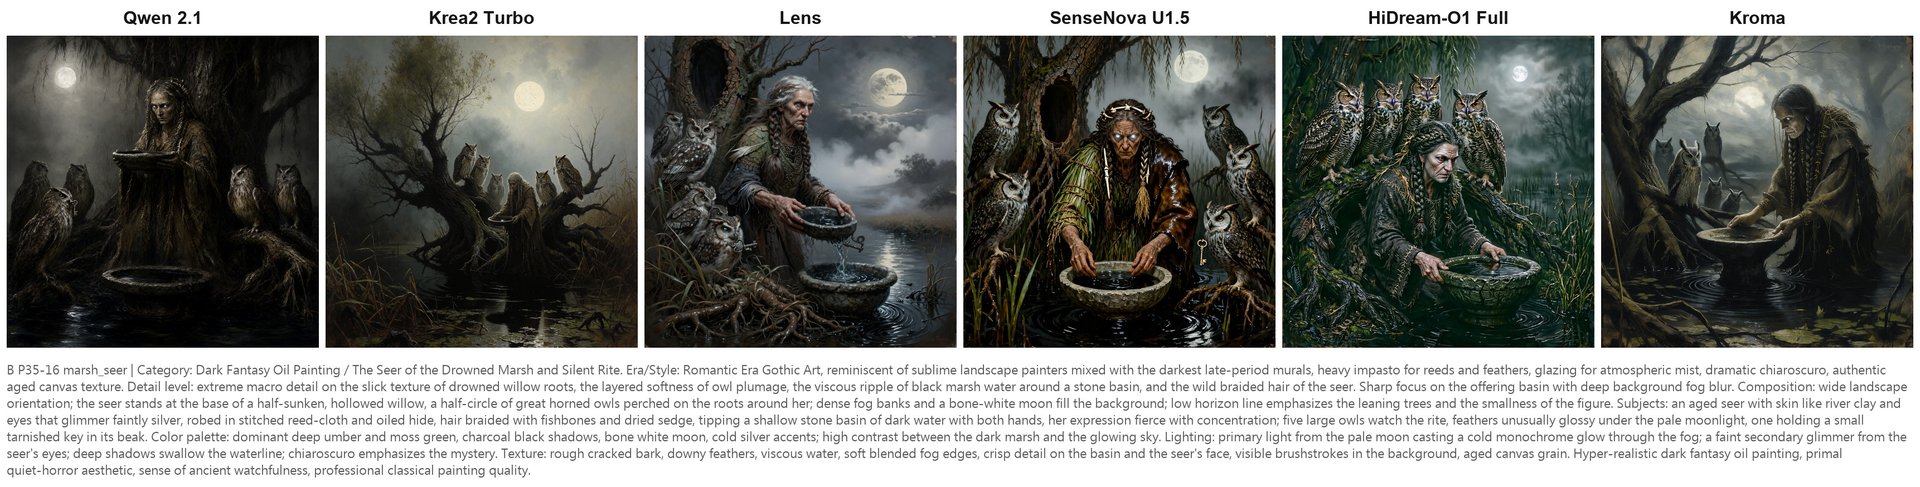
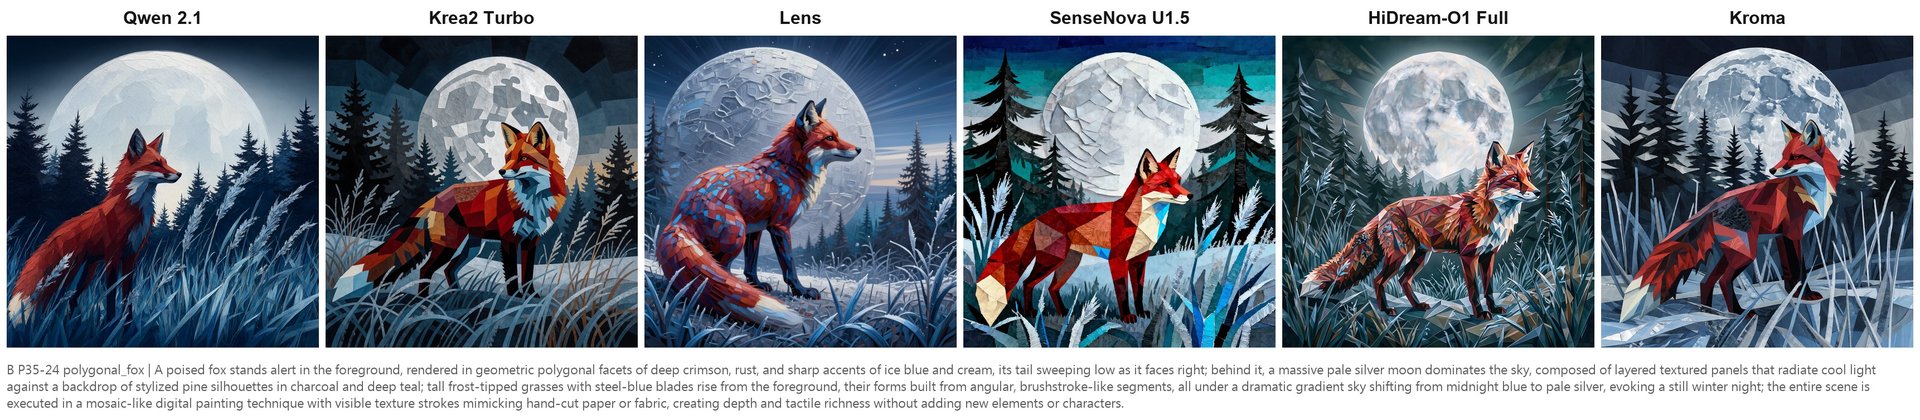
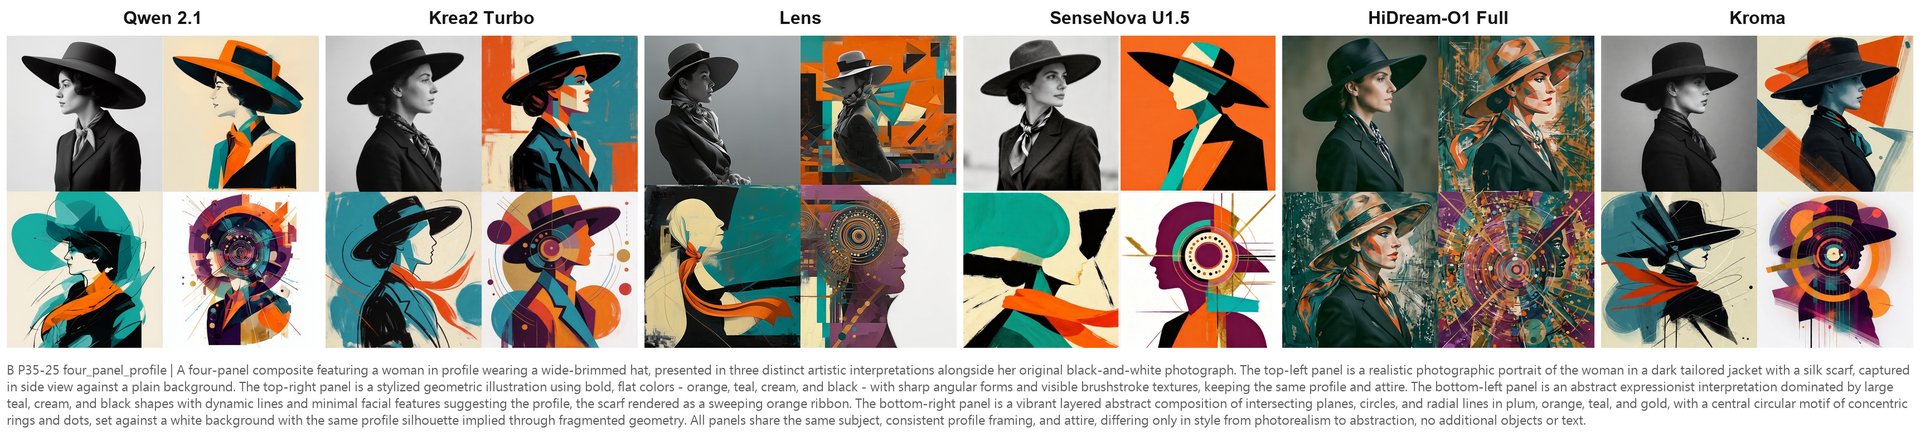
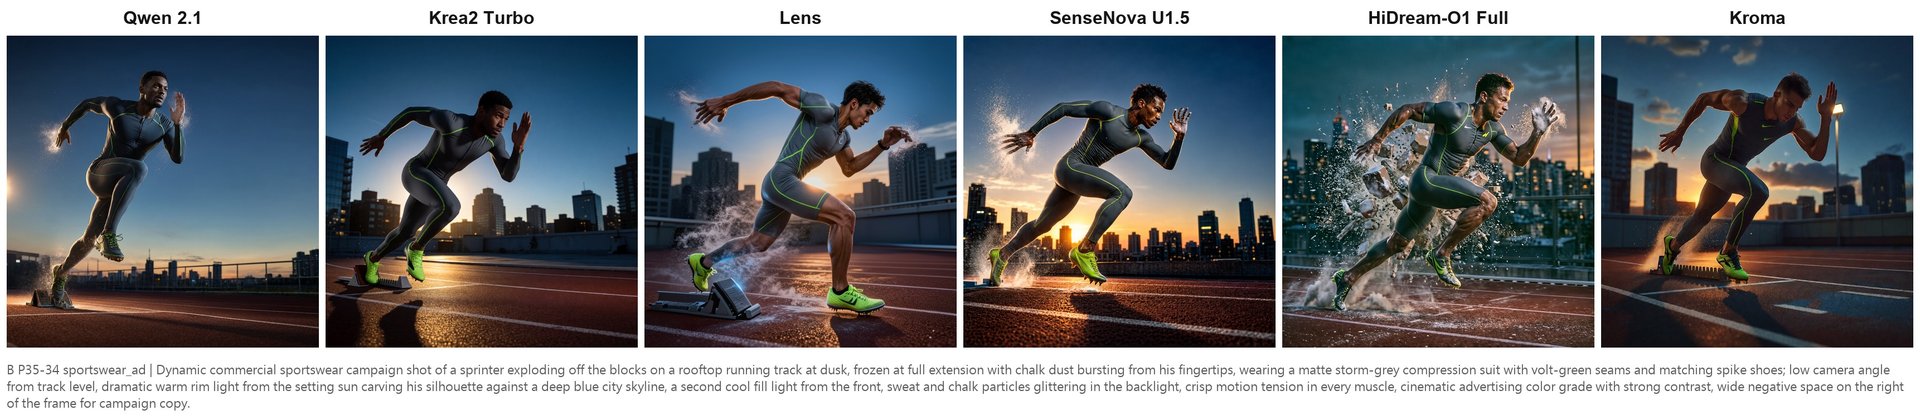
35 題常用題庫對上 Krea2 Turbo、Lens、SenseNova、HiDream-O1 Full、Kroma 五家,判定是 11 勝 22 平 2 輸。贏的題目集中在商業攝影與人像光影:美妝特寫的兩色濾光燈分割打光只有它與 Kroma 做出來;運動廣告要求畫面右側留白給文案,只有它做到;窗光人像的膚色與光影最自然。輸的兩題是黑白漁夫肖像沒做出龜裂畫布的質感,幾何多邊形狐狸偏寫實。
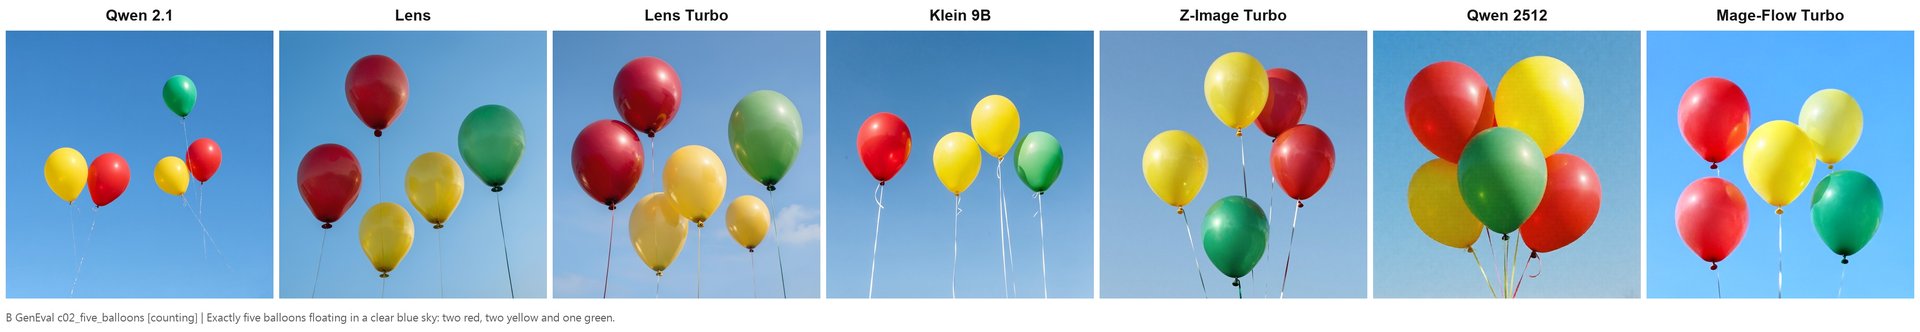
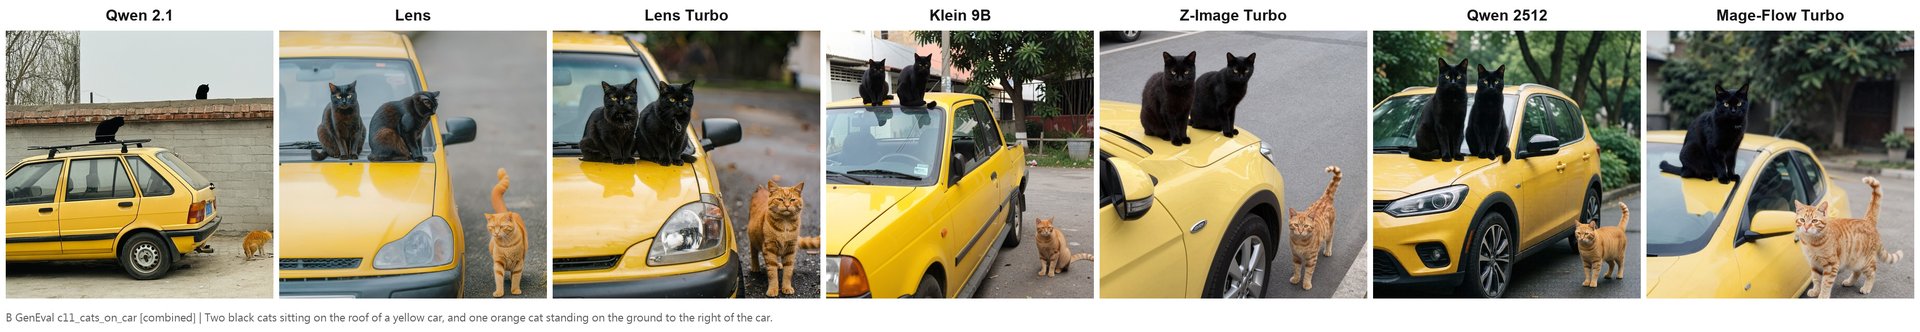
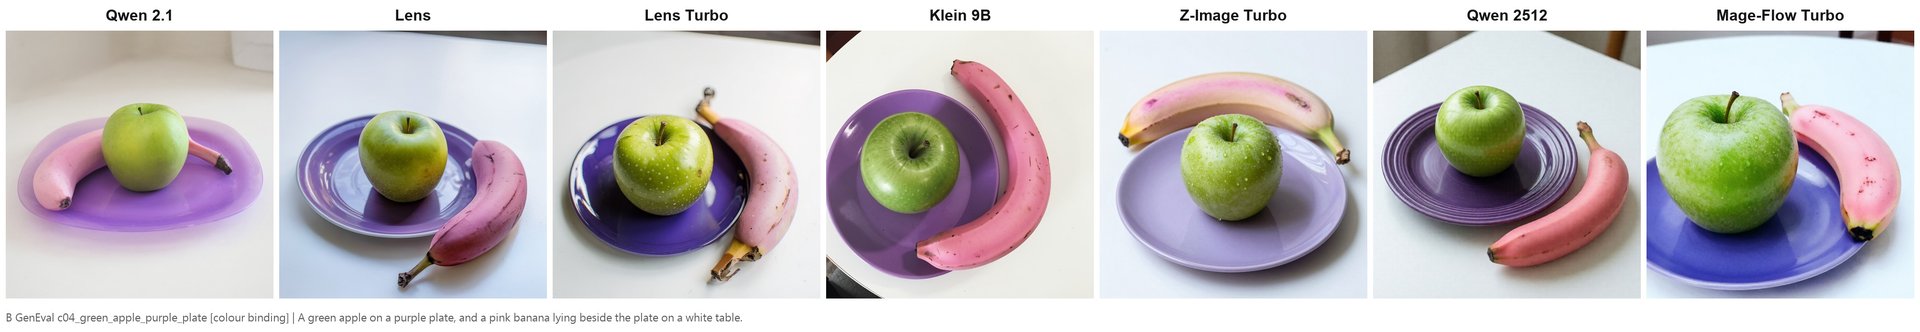
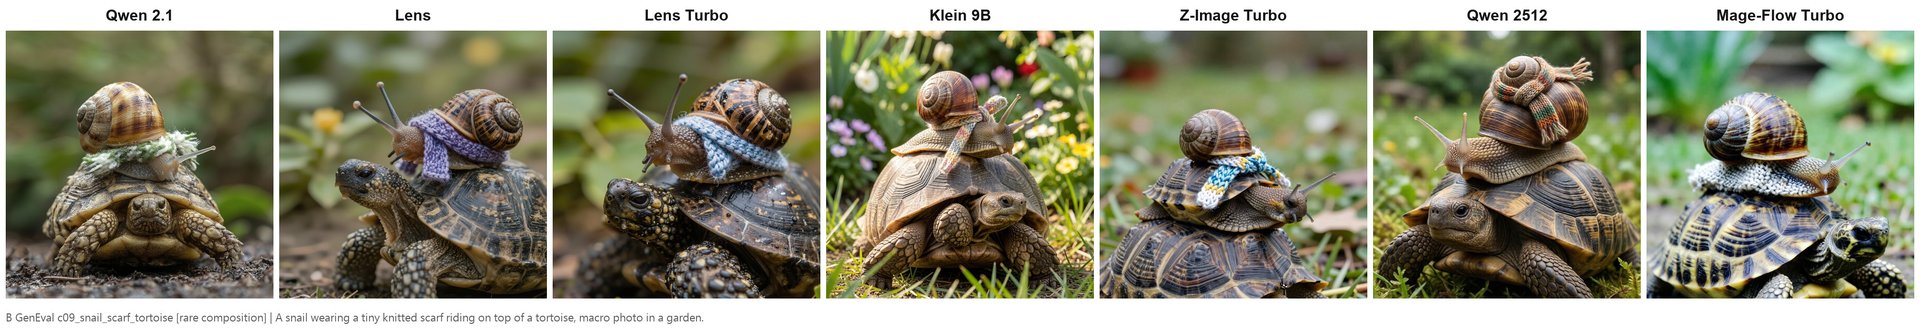
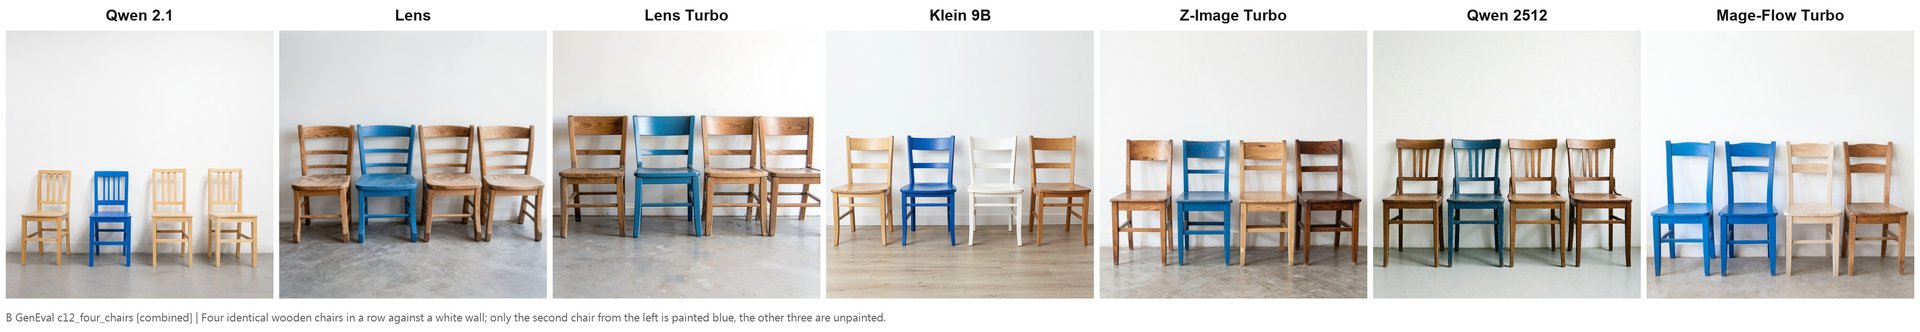
12 題數量、顏色、位置的考題(對上 Lens、Klein、Z-Image、Qwen 2512、Mage-Flow)是 8 平 3 輸,沒有贏的題目,遵循度只能算中等:粉紅香蕉應該在盤子旁邊,它放到盤子上;蝸牛的針織圍巾畫成一團毛線;車頂應該有兩隻黑貓,它只畫一隻。五顆氣球那題倒是數量顏色全對。
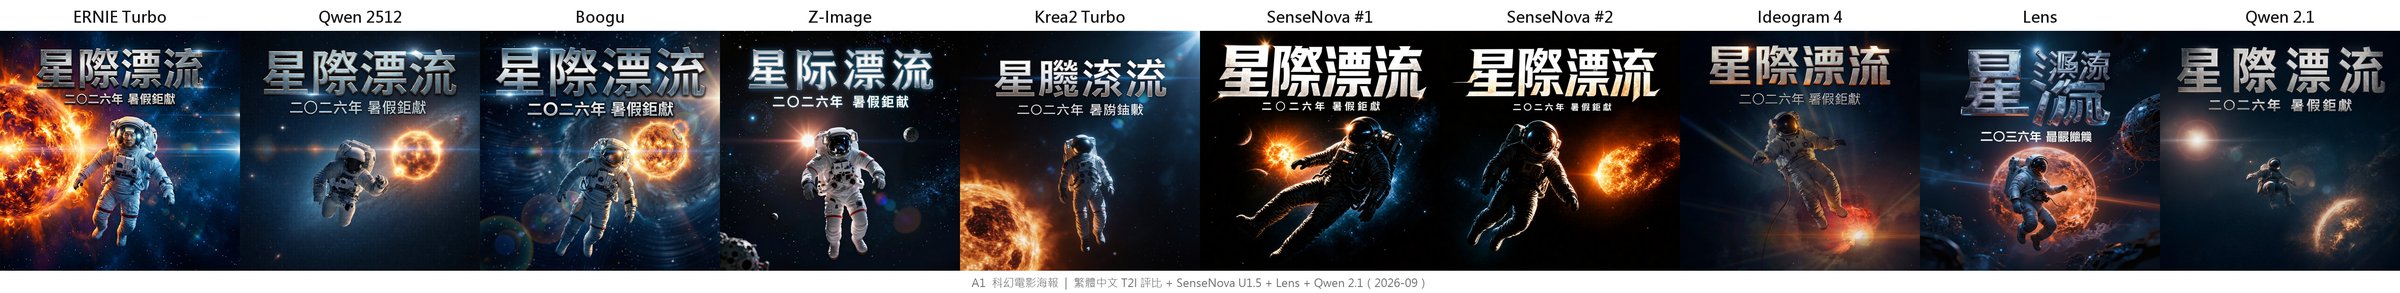
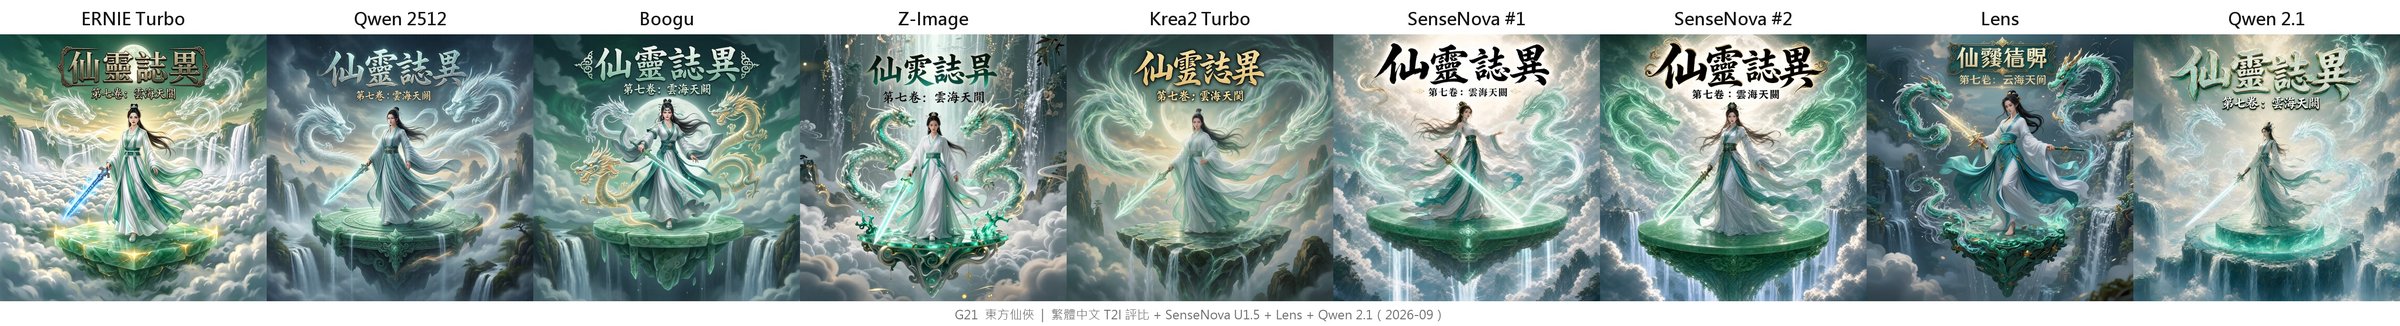
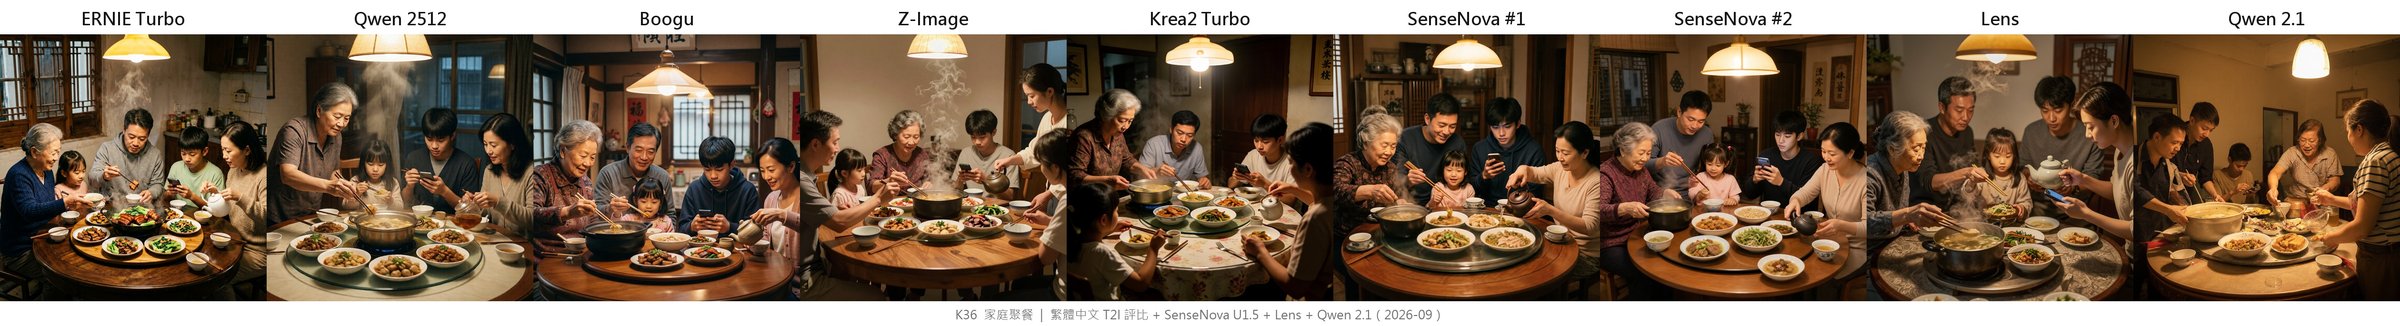
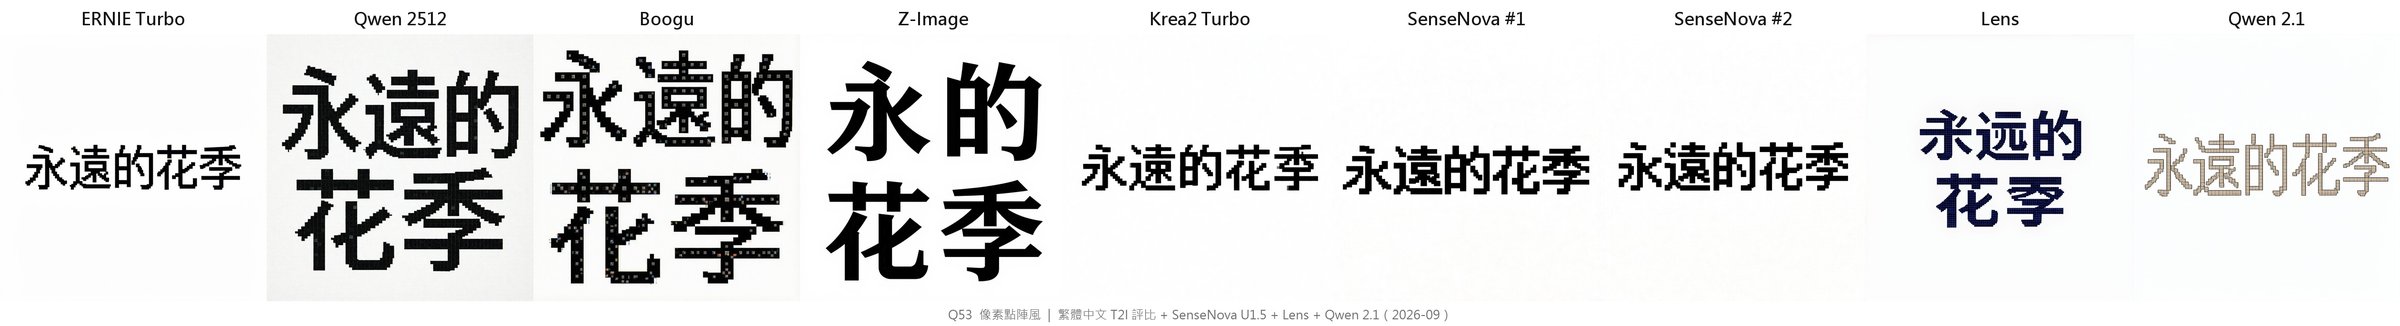
繁體中文 53 題是這次最大的驚喜。 判定是 30 勝 10 平 13 輸,跟 SenseNova U1.5 並列目前最穩,明顯優於同門的 Qwen 2512。海報標題、書法長句、藥品說明這種整段文字都能寫對;「永遠的花季」六種字體題 5 題全對且字體風格分得出來;一個很難的「闕」字,十個模型裡只有它的字形接近正確。
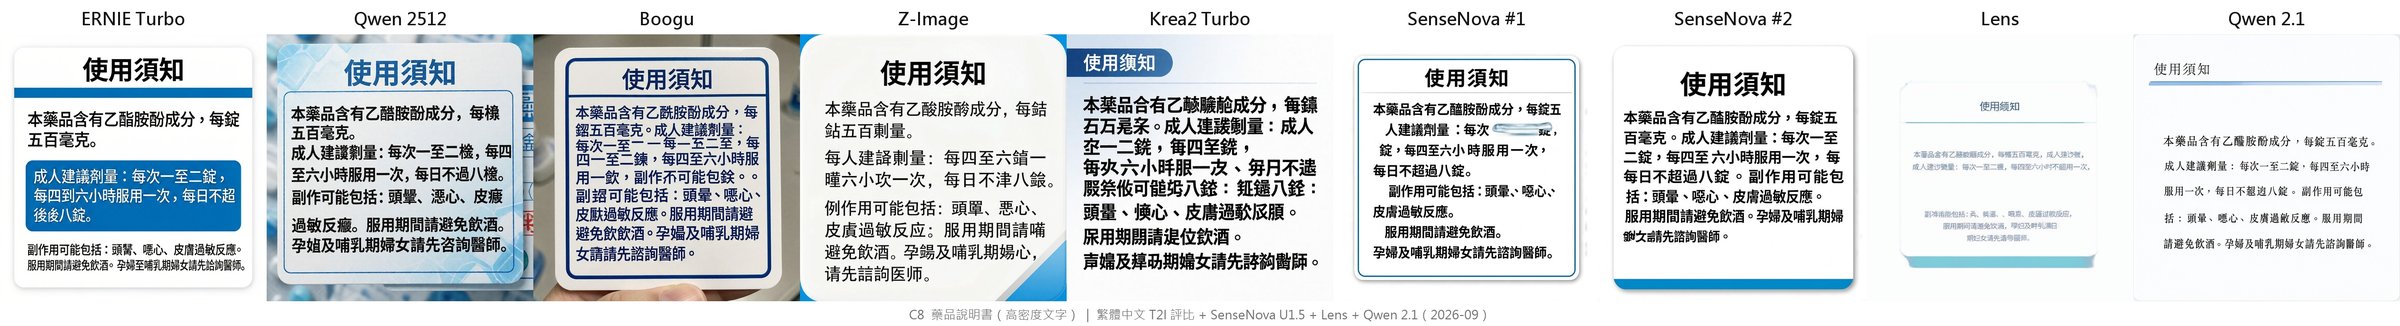
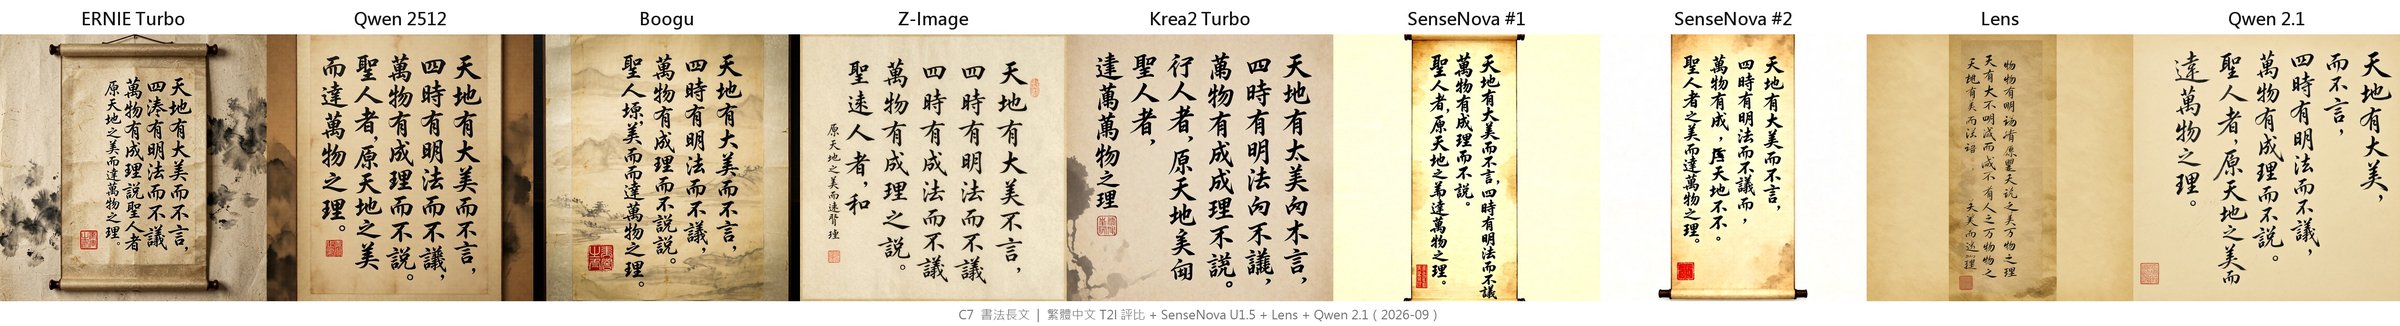
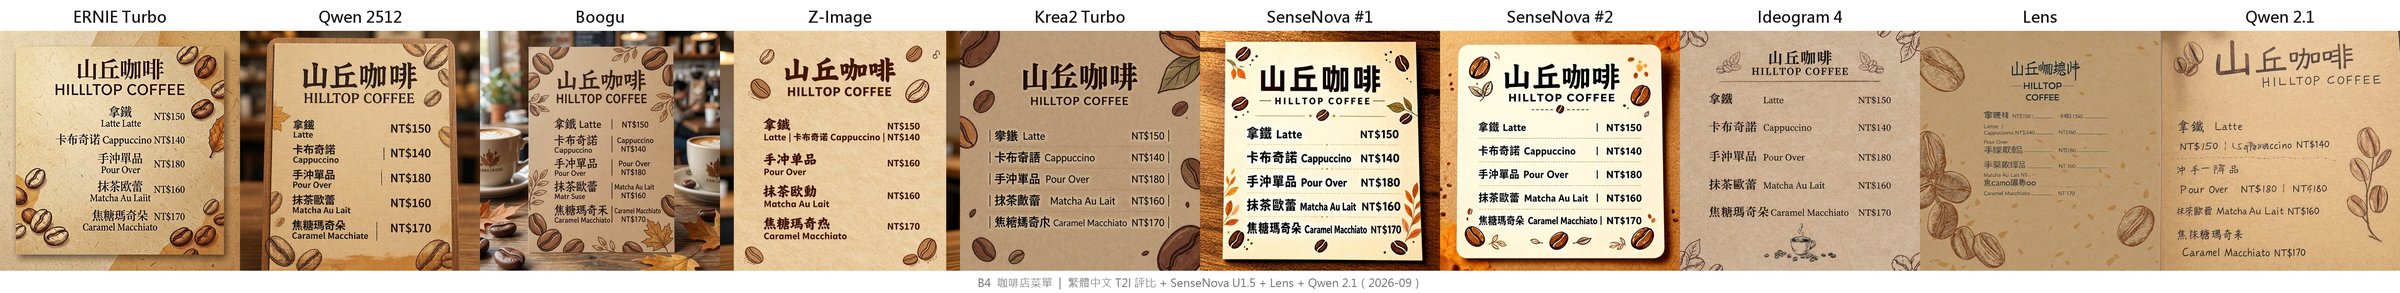
輸的 13 題有兩類。一類是小字密度高:咖啡店菜單、現代詩、夜市小吃標籤(還漏畫了臭豆腐);另一類其實不是文字問題,是人物:四代同堂那題少了女兒、街舞那題人物動作糊掉、機車載兩個小孩的坐法不對。
K. 原生 2K:十題全勝,不要 1K 再放大
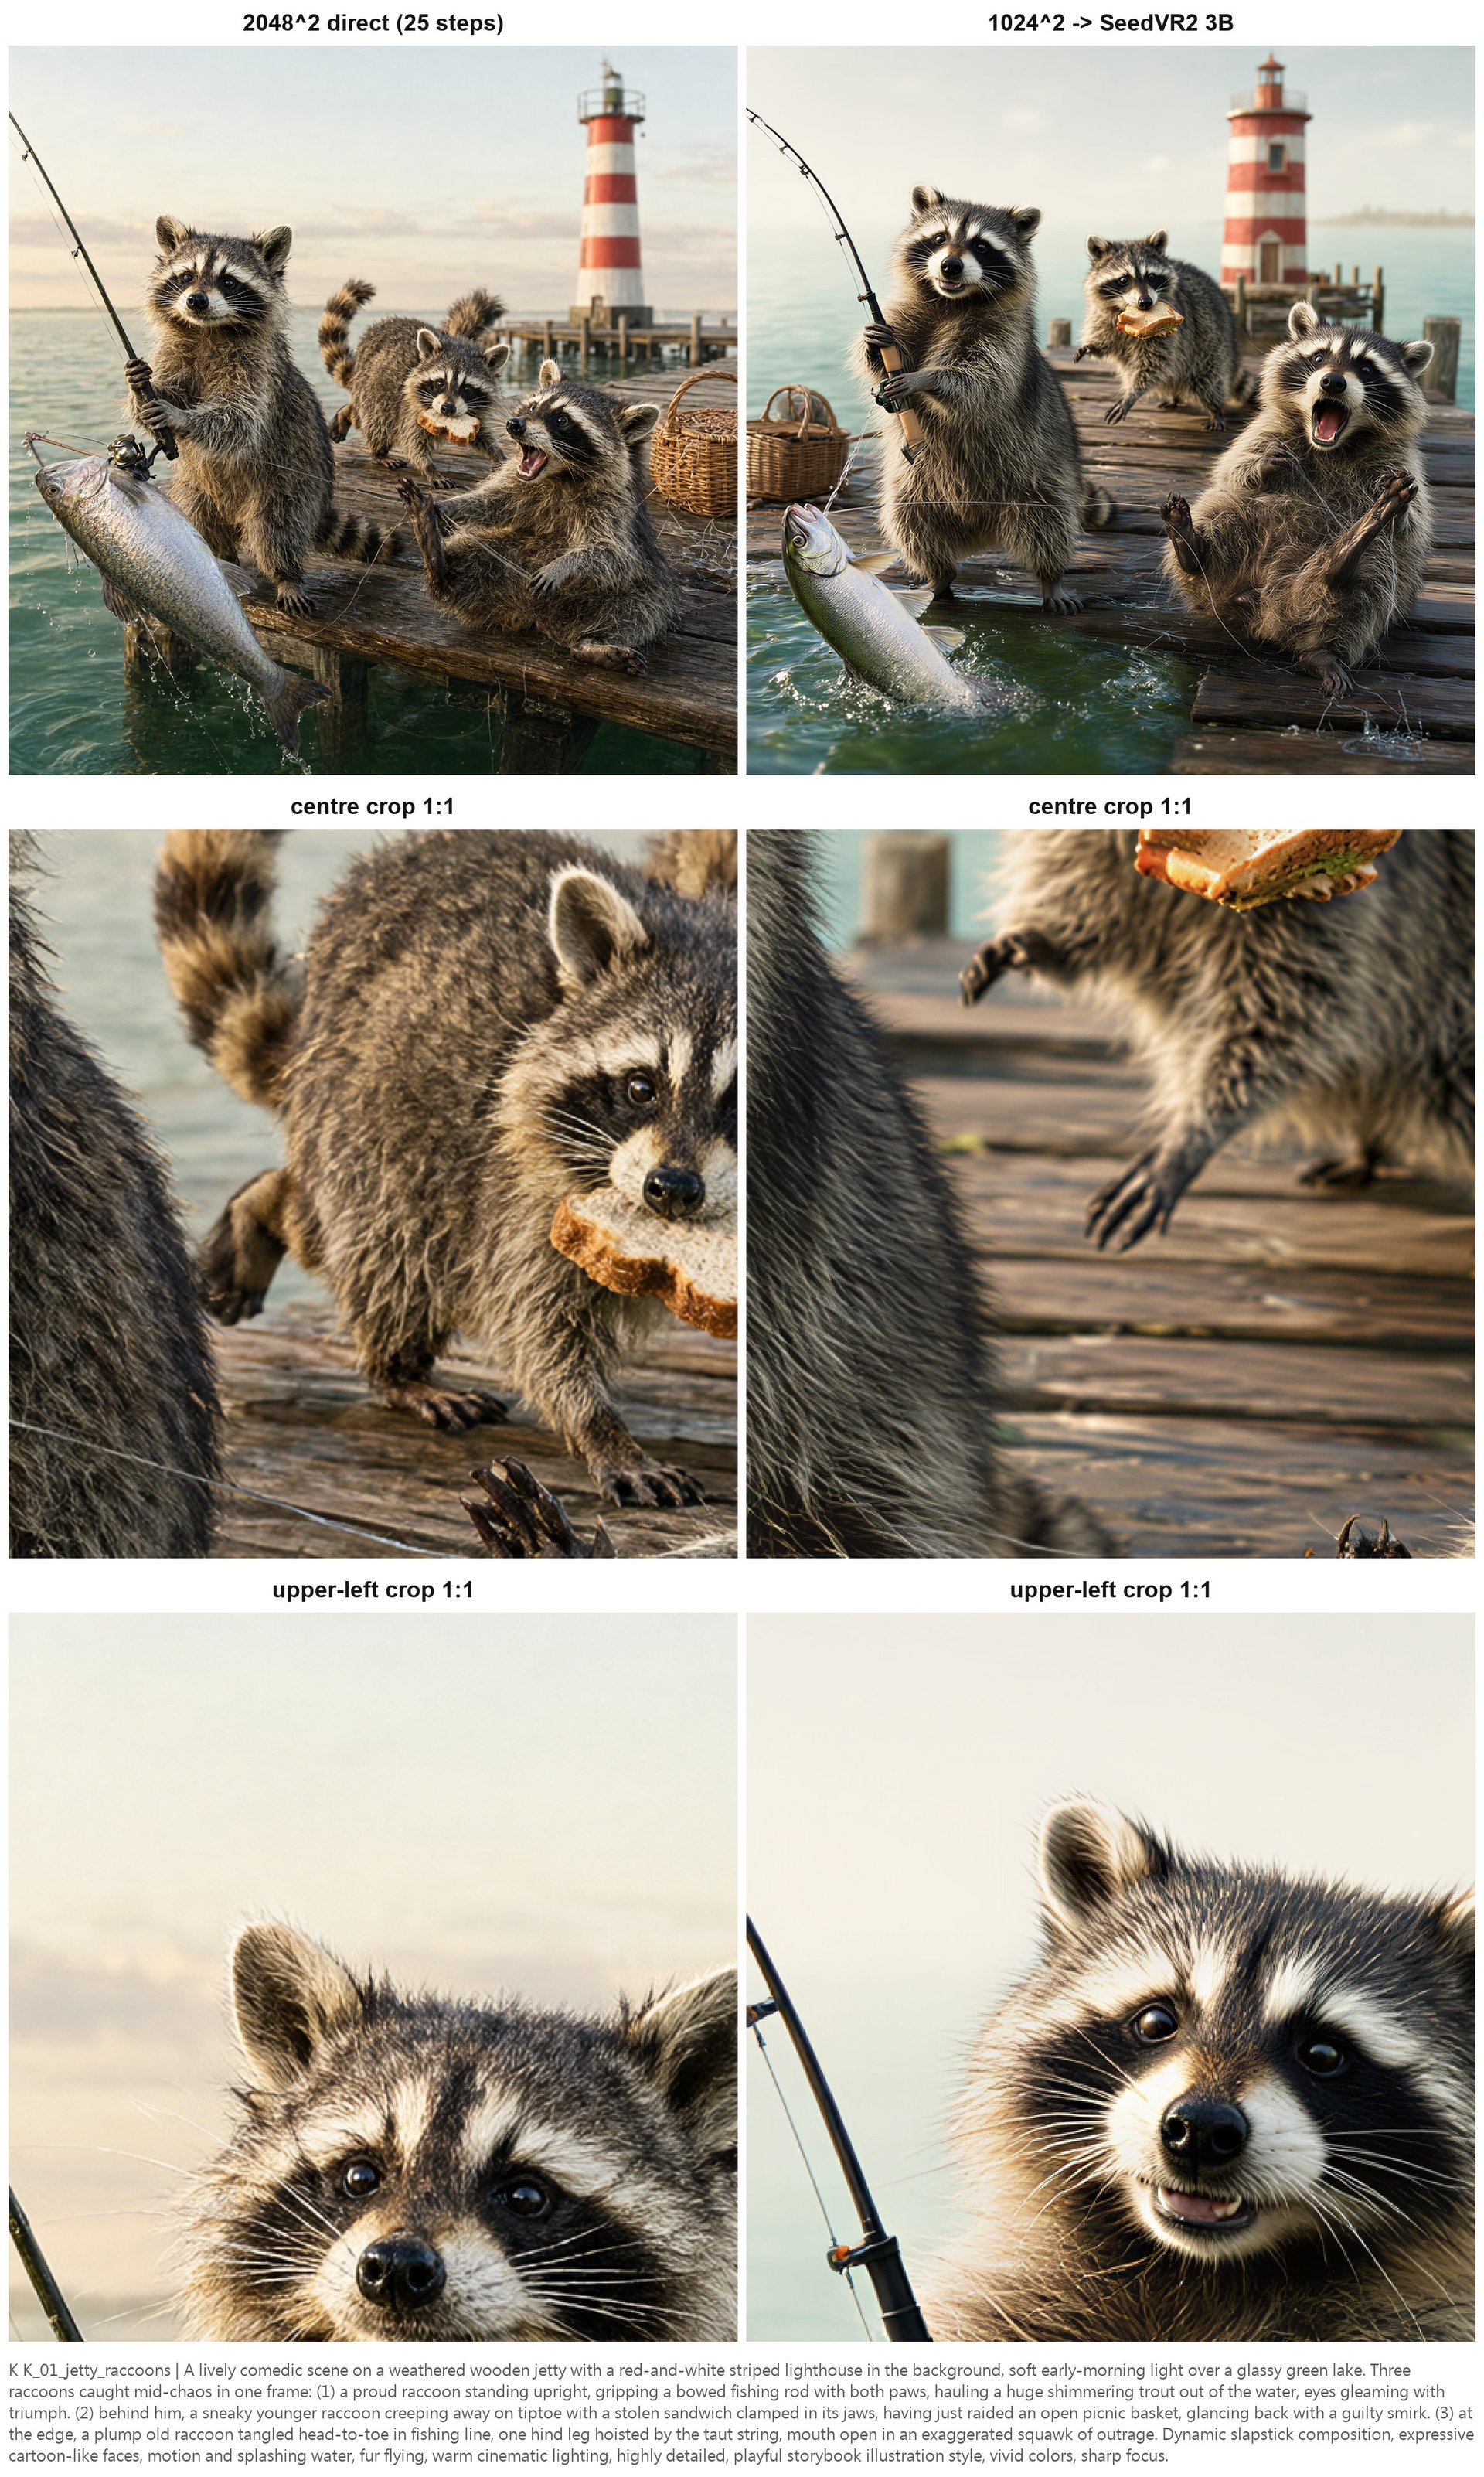
官方主打原生 2048×2048。同 seed 生 2K 直出,另一張生 1024 再用 SeedVR2 3B 放大到同樣尺寸,對照圖的第二、三列是 1:1 像素裁切。十題全部是 2K 直出贏:毛髮、水花、皮膚毛孔與鬍渣都是畫出來的細節,放大版是把小圖抹平後的銳化感。
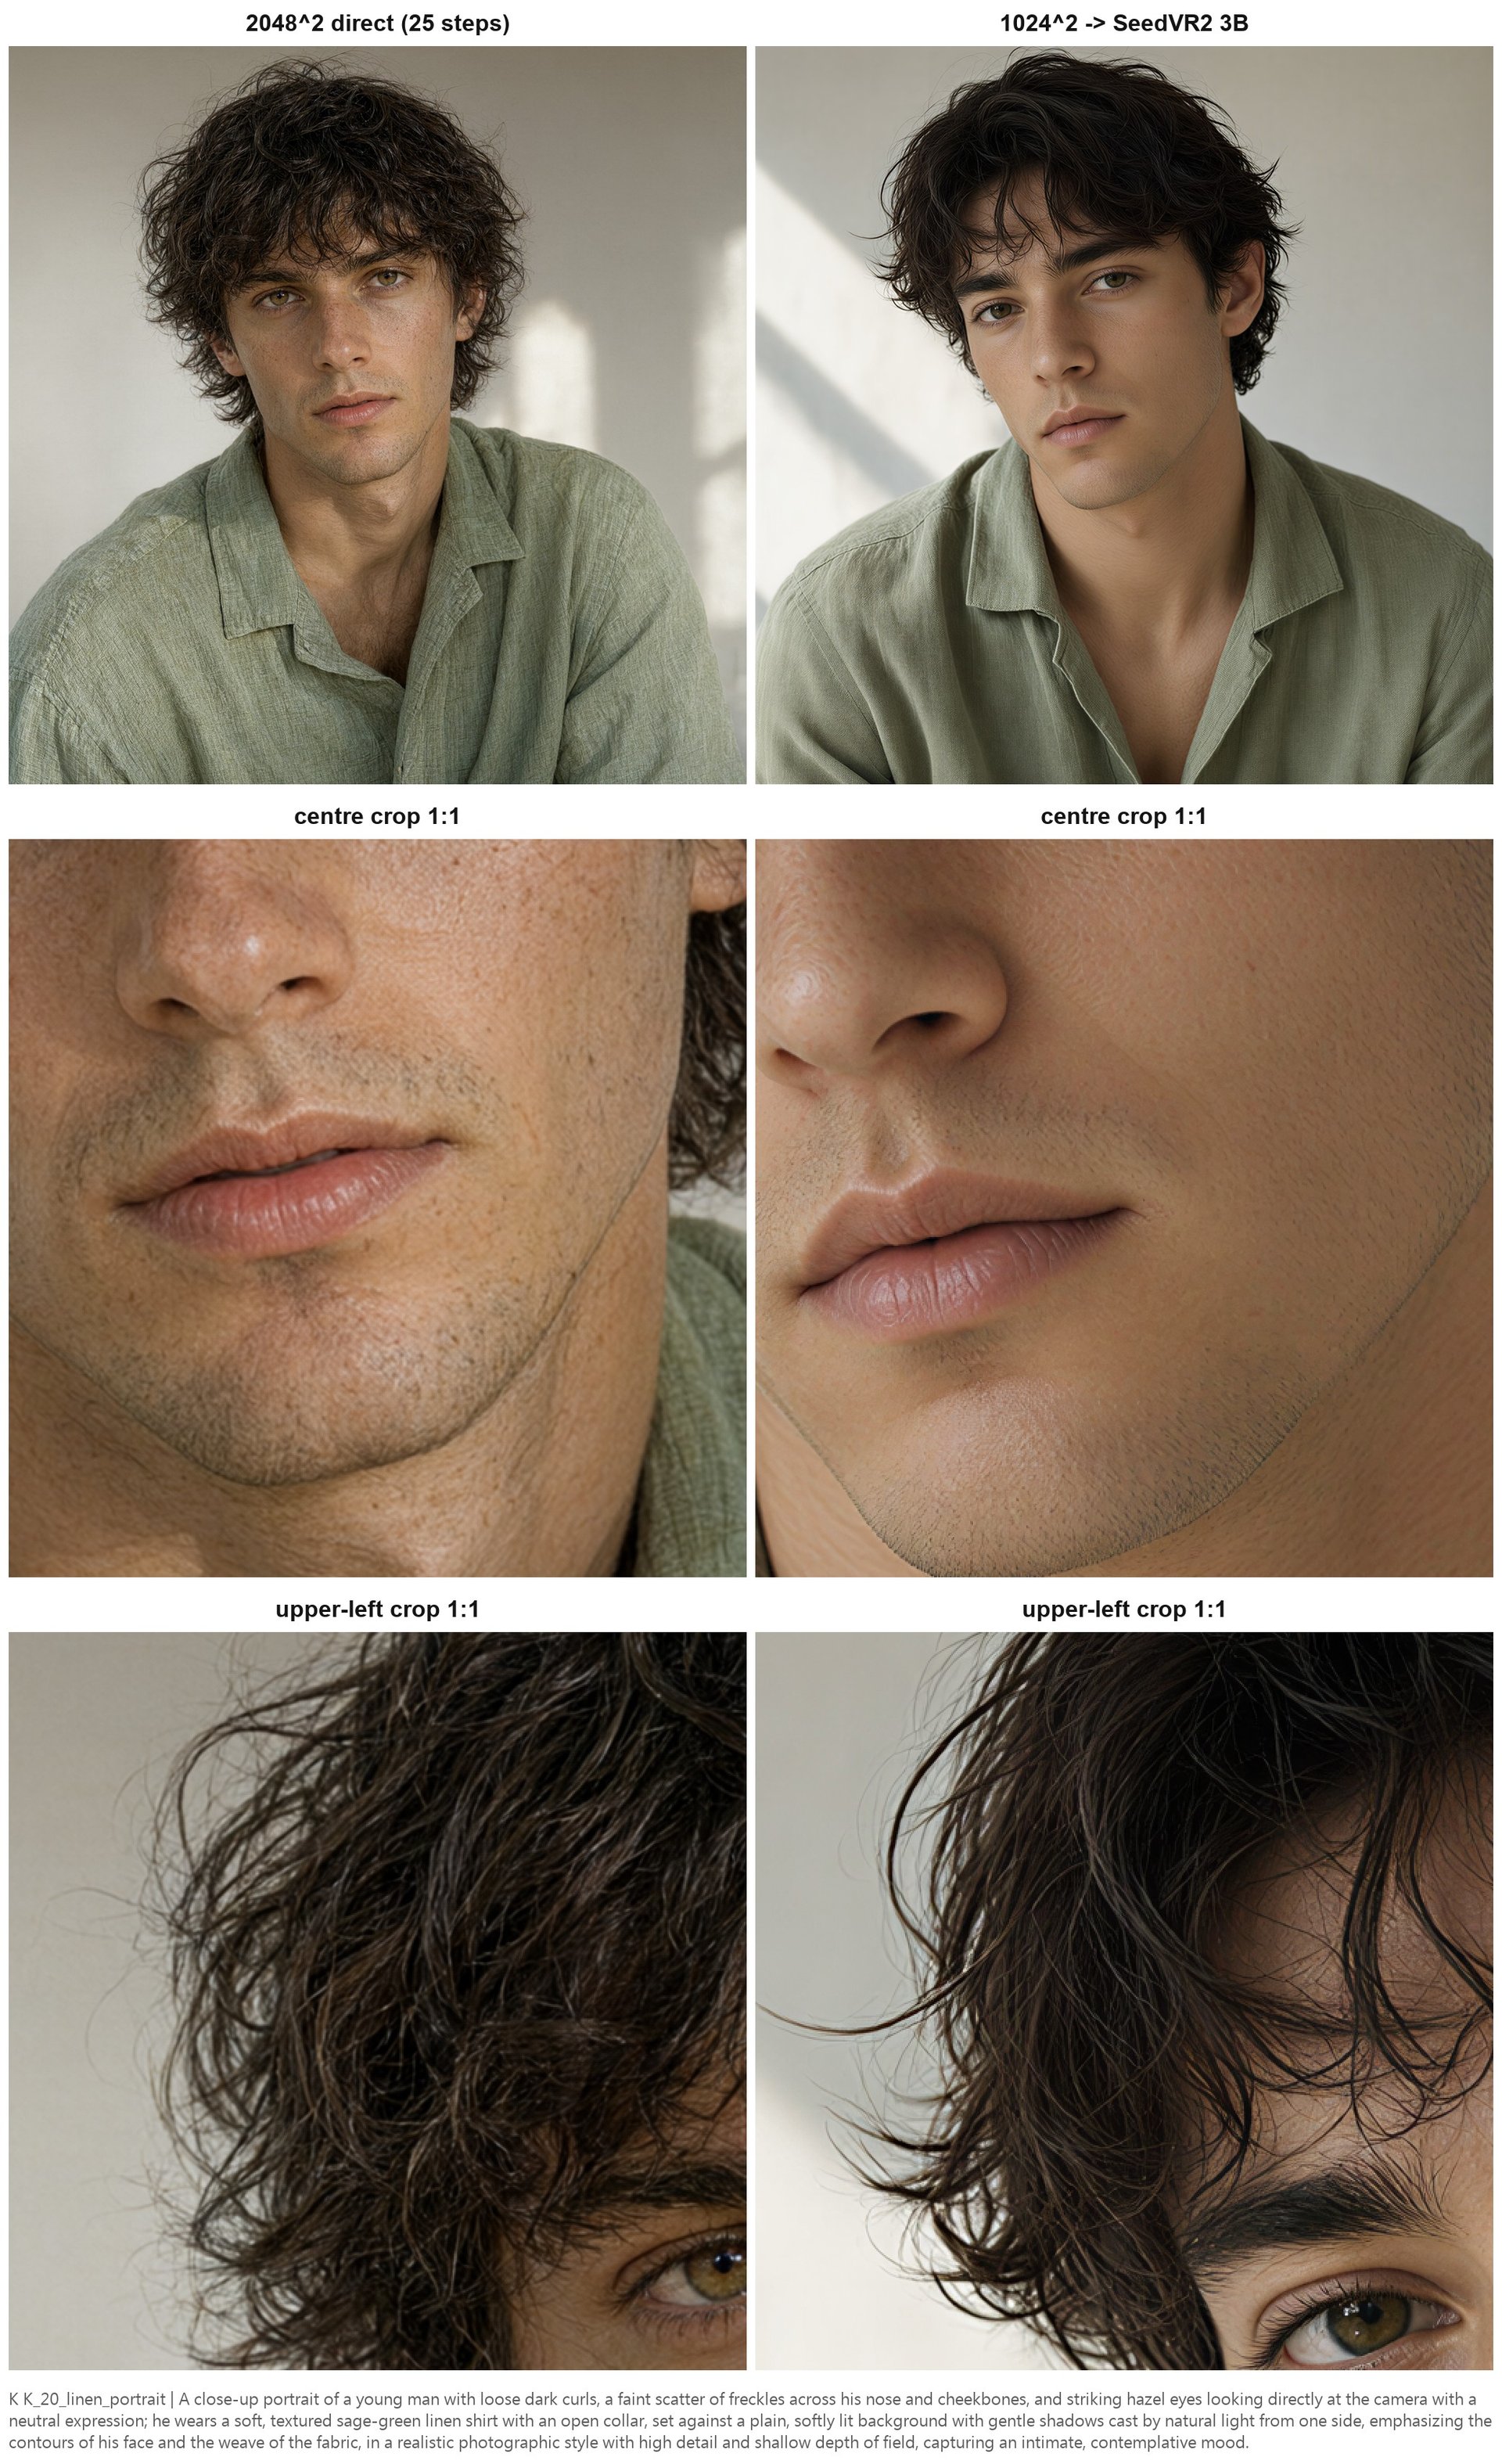
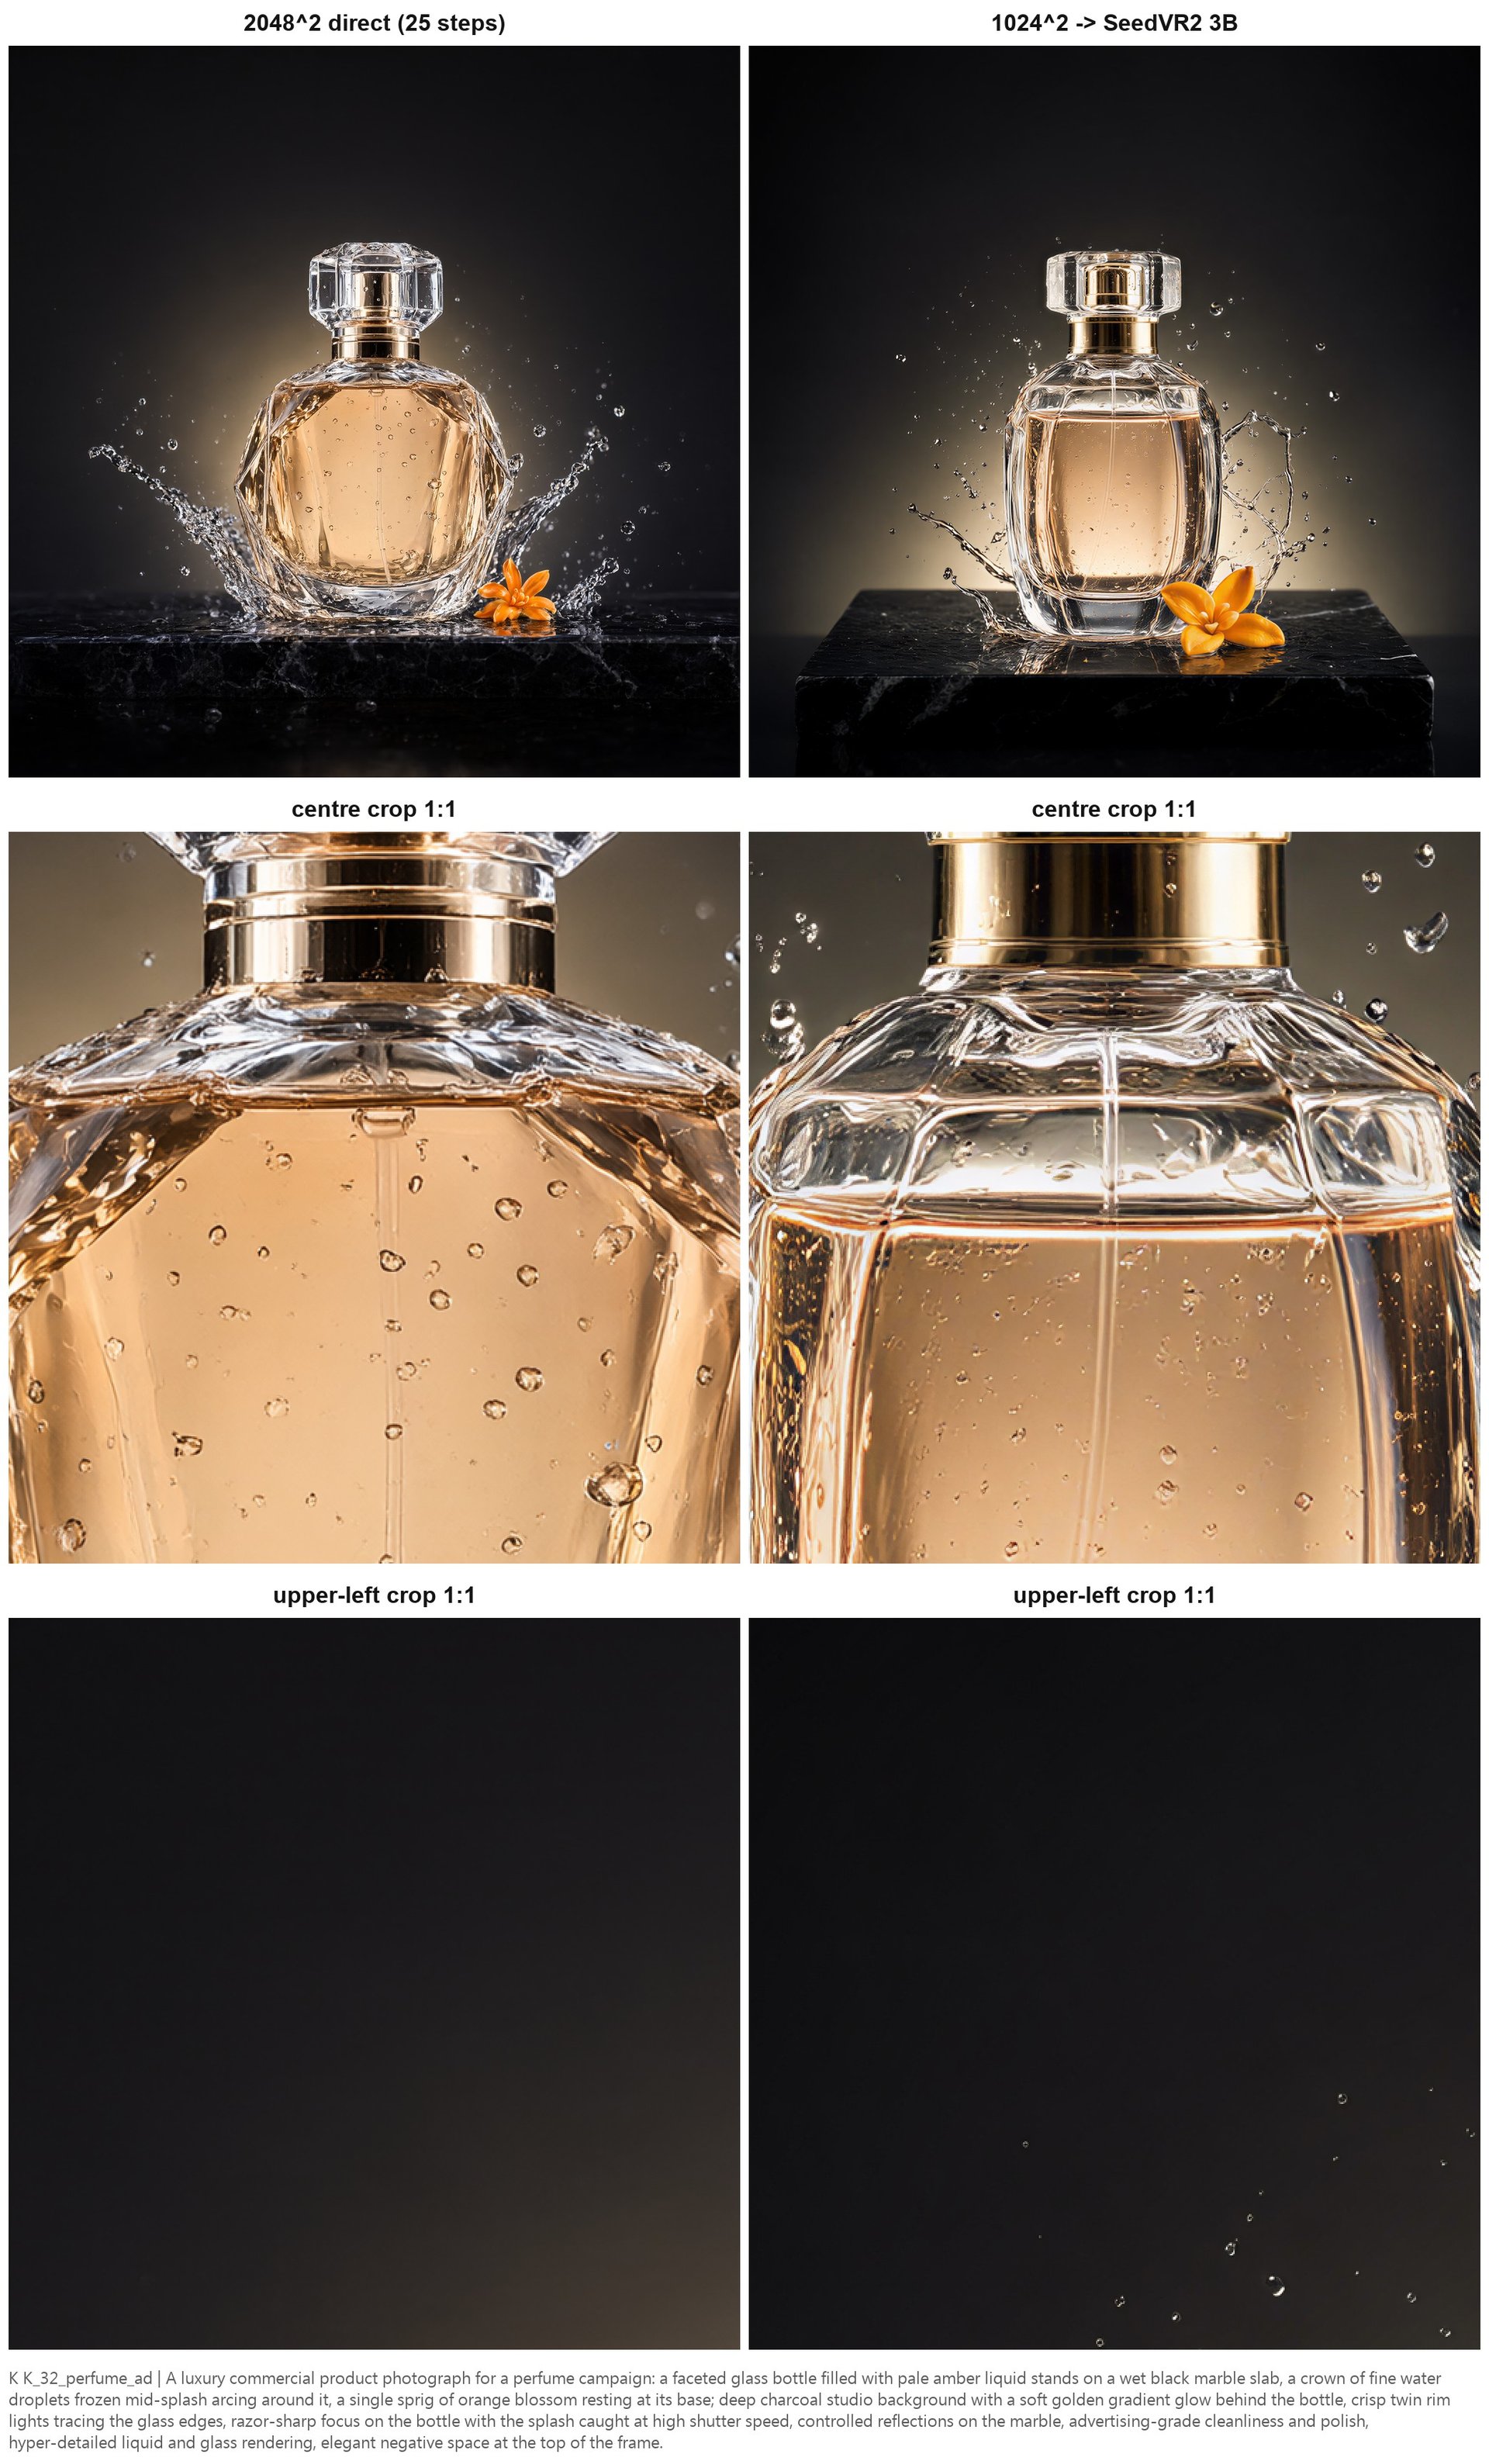
要注意的是同 seed 換解析度會換構圖,2K 不是 1K 的放大版,是另一張圖;時間大約是 1K 的四倍。
步數方面,25 步與 40 步構圖完全相同,6 題裡 4 題 40 步在金屬紋理、皮膚、布料、水花上多一點細節,另外 2 題看不出差別。日常 25 步,要精修再開 40。
該怎麼選
| 需求 | 建議 |
| 要透明背景的素材,主體有玻璃、煙、薄紗、髮絲 | Qwen-Image-2.1 原生透明,prompt 前後包上透明句型,存 PNG |
| 把一張既有的圖去背 | BiRefNet-HR,不要用 Qwen 2.1,雜亂背景的人像它會整個切掉 |
| 改一張圖的局部(換文字、換材質、改天氣),其他不能動 | Qwen-Image-2.1 單參考編輯,比 HiDream-O1 穩 |
| 多張參考圖合成人、物、場景 | HiDream-O1 Full,融合較自然;Qwen 2.1 要多抽幾張,會出分身 |
| 繁體中文海報、標題、整段文字 | Qwen-Image-2.1 或 SenseNova U1.5,兩家並列;小字密度高的版面兩家都會錯 |
| 數量、顏色、位置要精確 | Lens 或 Z-Image Turbo,Qwen 2.1 在這種考題只是中等 |
| 要 2K 輸出 | 直接生 2048,不要 1K 再放大 |
| 商業用途 | 授權是非商用,要先向阿里取得授權;上一代 Qwen 2512 是 Apache-2.0 |
想自己跑:ComfyUI 設定
| 檔案 | 下載 | 放置位置 |
| qwen_image_2.1_bf16.safetensors(約 14GB;另有 int8_convrot 版約 7GB,官方範本預設) | Hugging Face Comfy-Org/Qwen-Image-2.1 | models/diffusion_models/ |
| qwen3vl_8b_int8_convrot.safetensors(文字編碼器,約 9GB;另有 bf16 約 17GB、w4a8 約 6GB) | 同上 | models/text_encoders/ |
| qwen_image_2.1_vae_bf16.safetensors(RGBA VAE,約 700MB,跟上一代的 VAE 不通用) | 同上 | models/vae/ |
ComfyUI 0.37.0 以上原生支援,範本庫搜「Qwen Image 2.1」有文生圖、編輯、去背三個工作流。幾個實測的備註:
- 官方設定 25 步、CFG 1、euler simple,沒有 shift 節點。CFG 1 表示負向提示無效,留空就好
- 透明圖的寫法是把描述包在固定句型裡:
This is an RGBA format image with transparency. [描述]. The image has an alpha channel and a transparent background.存 PNG 才保得住 alpha - 輸出永遠是四通道圖片。不透明圖的 alpha 幾乎全不透明但不是純 255,要純 RGB 再轉一次;透明圖的透明區域顏色填的是洋紅,直接看原檔會是紫底,合成後才是真正結果
- 編輯時參考圖接到 TextEncodeQwenImage21 節點,取樣器的 latent 也從這個節點拿,畫布會跟著第一張參考圖;resolution 是參考圖的像素預算,1024 最穩,設 0 保留原尺寸但大圖會不穩
- 多張參考圖在節點上拖線會自動長出新的槽,prompt 用
<image1>、<image2>指涉 - 文字編碼器與模型加起來二十多 GB,VRAM 有限的電腦選 int8 版;GGUF 社群版也已經有了
授權是 Qwen Research License,非商用,商用要向阿里巴巴取得授權;產品文件要標示「Built with Qwen」。
更多對照圖(節錄)
四章共 148 張對照圖,這裡只節錄正文沒放到、但判定時有代表性的題目(贏的、輸的都有)。判定的欄位順序印在圖的標題列,prompt 在圖的底部。
T. 透明輸出
R. 參考圖編輯(對 HiDream-O1 Full)
B. 35 題常用題庫(Qwen 2.1|Krea2 Turbo|Lens|SenseNova|HiDream-O1 Full|Kroma)
B. 12 題數量顏色位置考題(Qwen 2.1|Lens|Lens Turbo|Klein 9B|Z-Image Turbo|Qwen 2512|Mage-Flow Turbo)
B. 繁體中文(Qwen 2.1 在最右欄)
K. 原生 2K 對 1K 放大(第二、三列為 1:1 裁切)
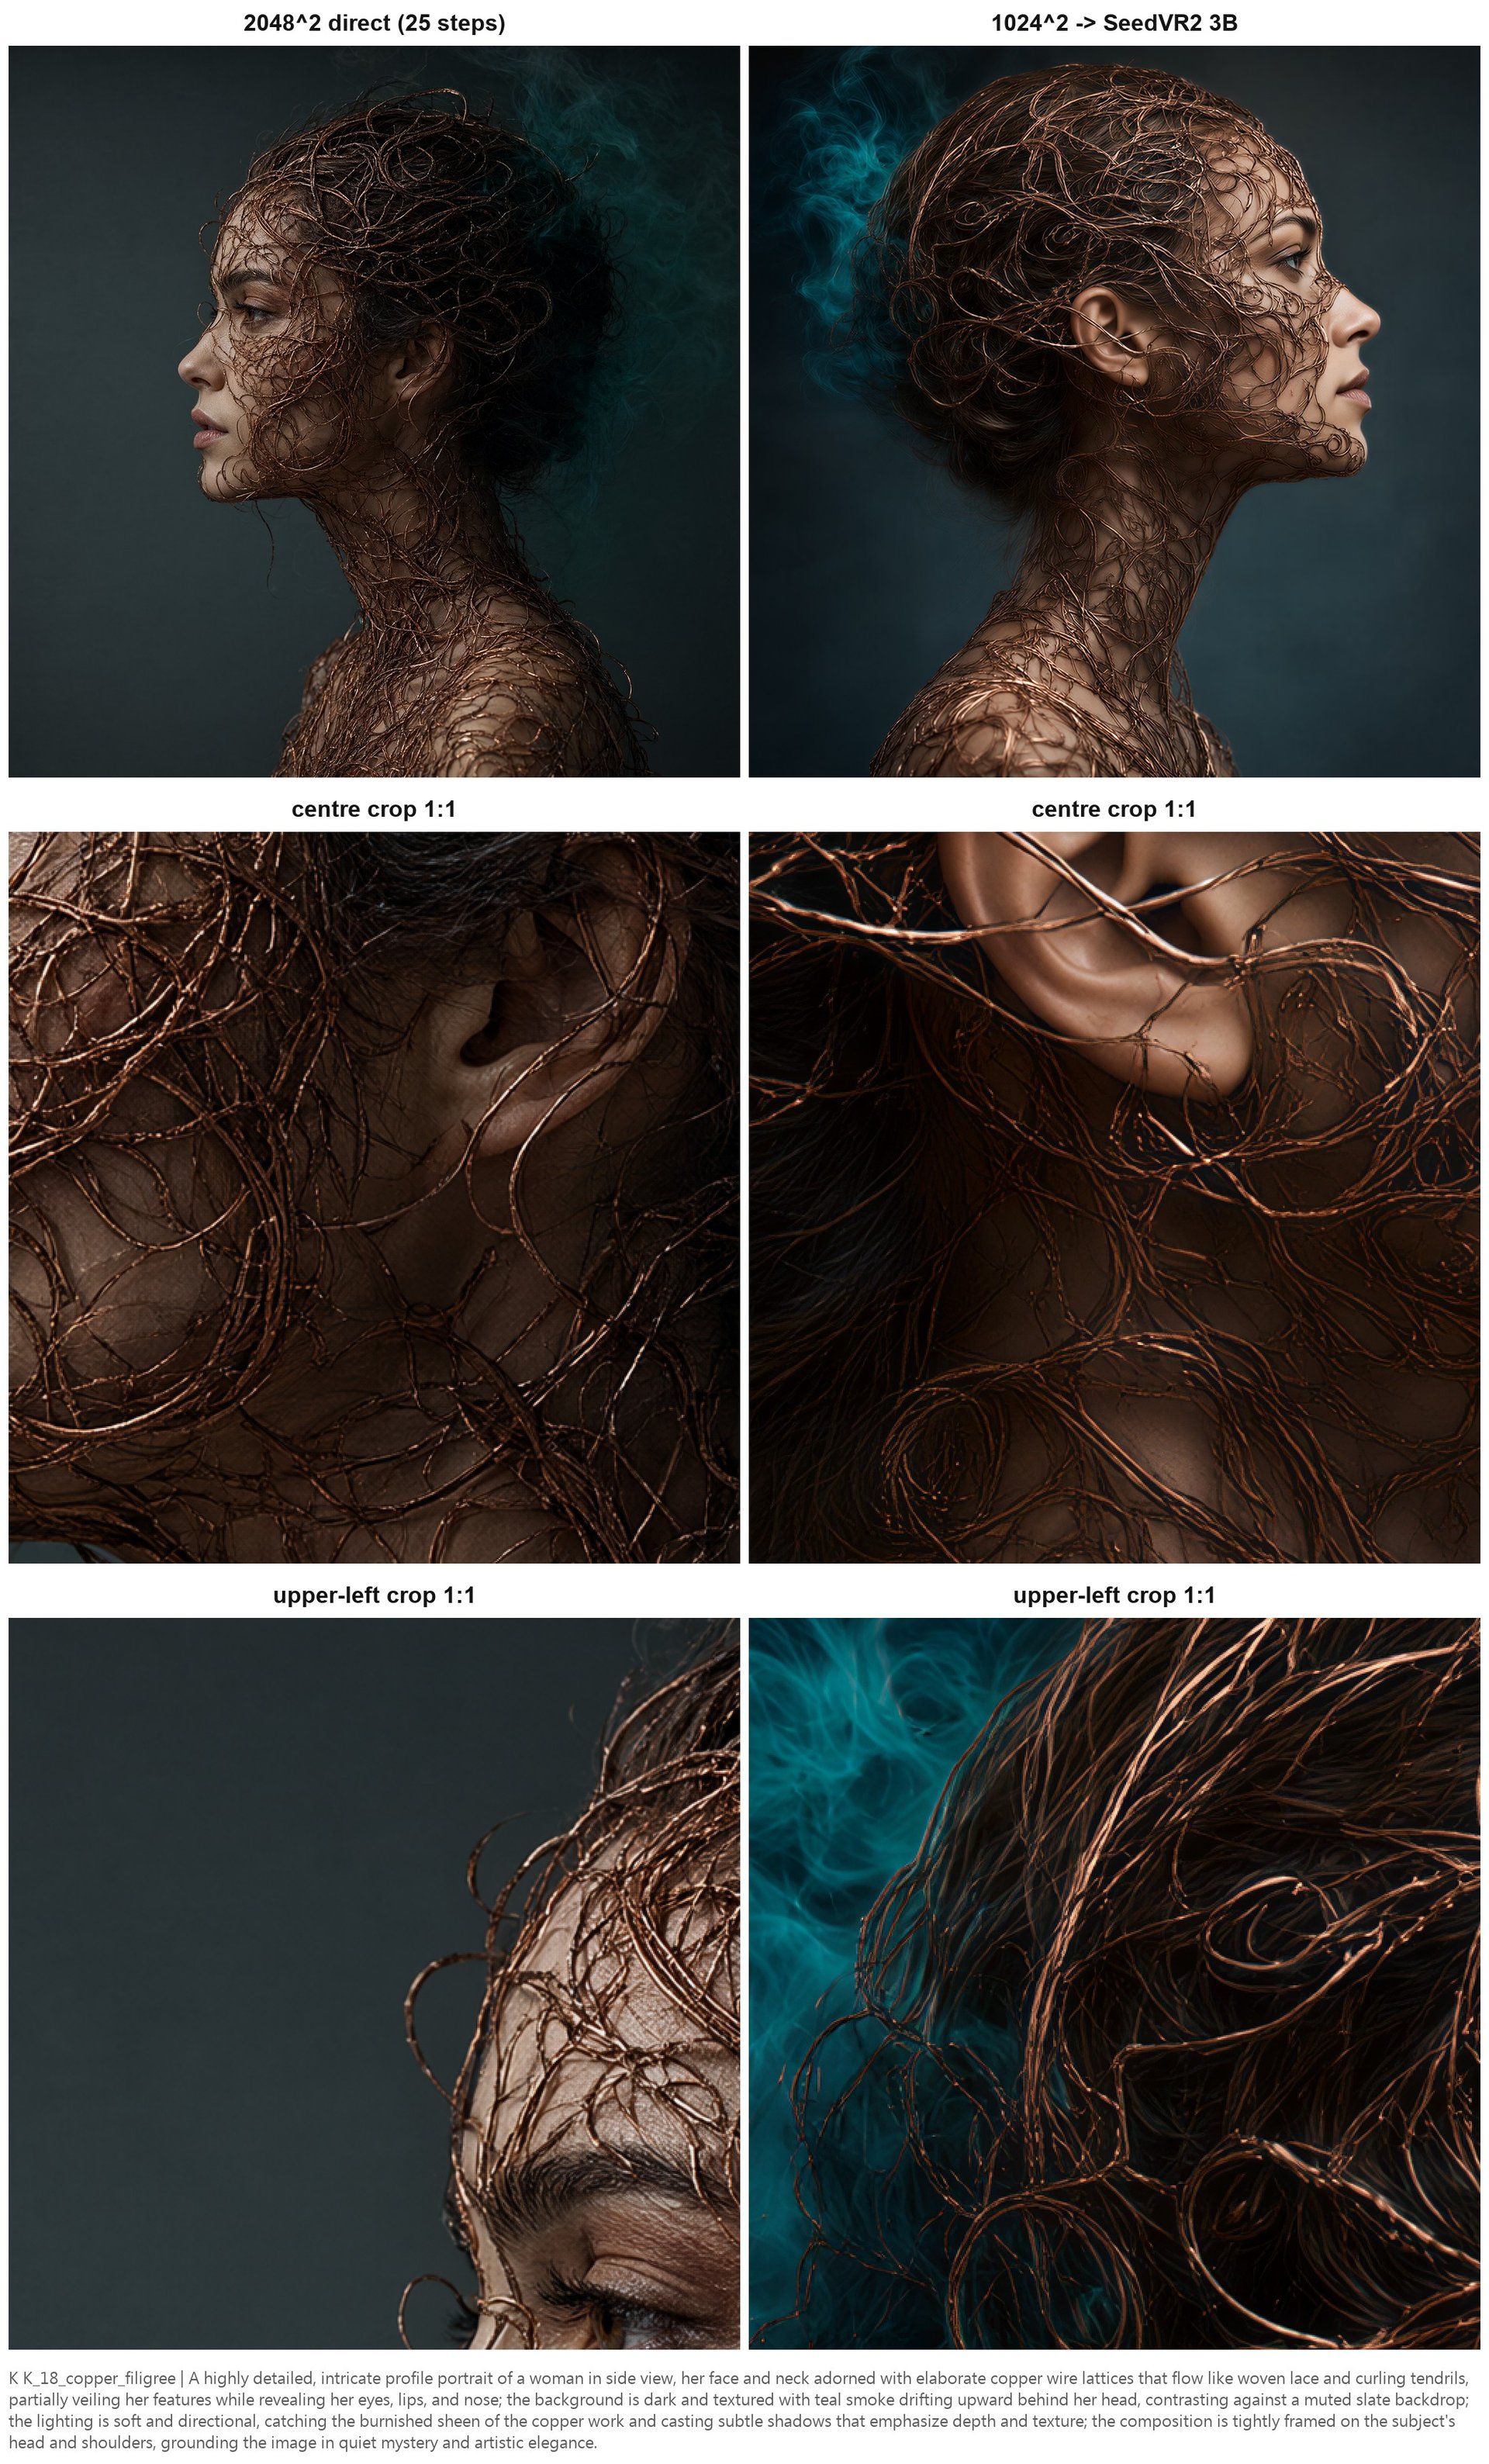
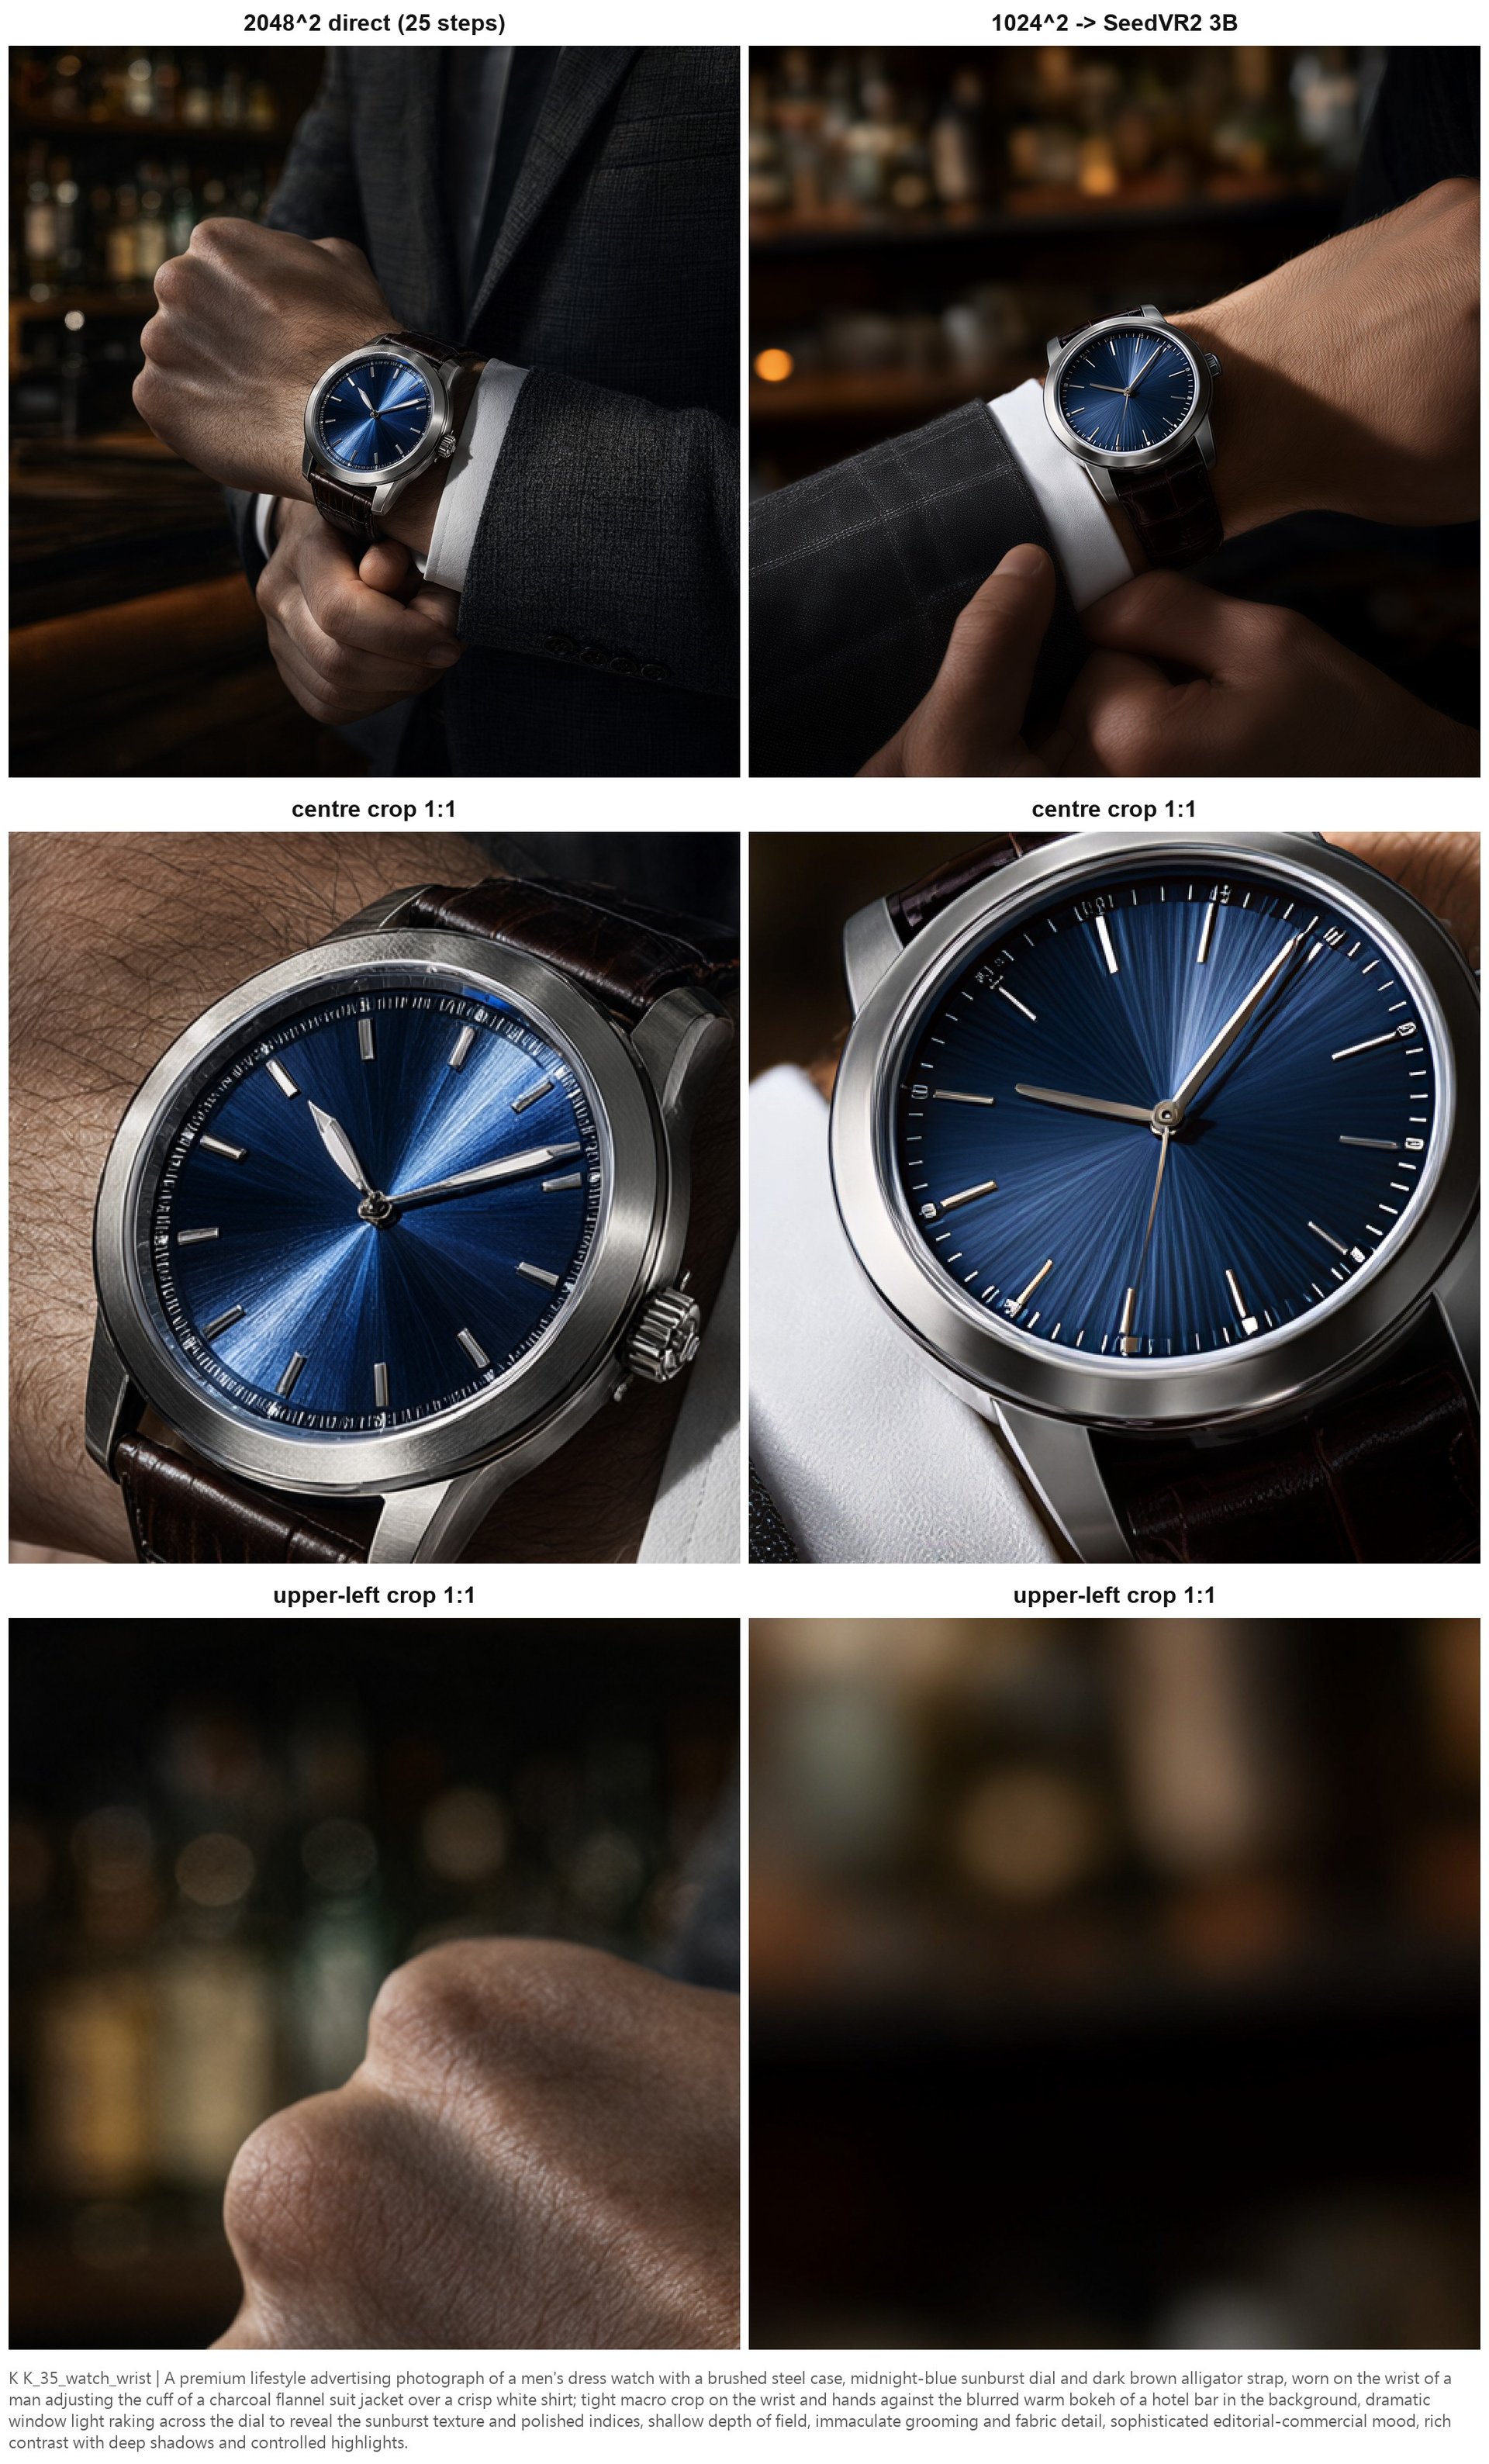
相關文章
- HiDream-O1 實測:官方說的六件事,本機驗證對了幾件 — 本文 R 章的對照組與參考圖來源
- Microsoft Lens 實測:3.8B 小模型的官方宣稱,本機驗證對了幾件 — 本文 12 題考題的對照組
- ComfyUI 去背怎麼選 — 本文 T 章對照的去背模型與 15 張測試圖來源
- SenseNova U1.5 繁體中文實測 — 繁體中文與本文並列最穩的另一家
- 繁體中文 AI 生圖測試 Prompt:53 組全公開 — 本文繁體中文章節用的題庫
- ComfyUI 放大與臉部修復 37 路線實測 — 本文 K 章用的 SeedVR2 放大路線來歷