上一篇把 Qwen-Image-2.1 官方列出的能力逐條驗證過一輪,透明背景輸出、用一張參考圖編輯、原生 2K 都成立。之後看了官方部落格與社群整理,發現它還有幾種用法我沒測:在已經是透明背景的圖上直接編輯、用彩色圓圈標出要改的區域、把很多張參考圖合成角色設定圖或整個房間,還有官方另外釋出的 Prompt Enhancer,也就是幫你把 prompt 改寫得更完整的模型。這篇一次補齊,做法照舊:每一種用法出題、生圖、逐張看,好壞由我自己判斷。
快速結論
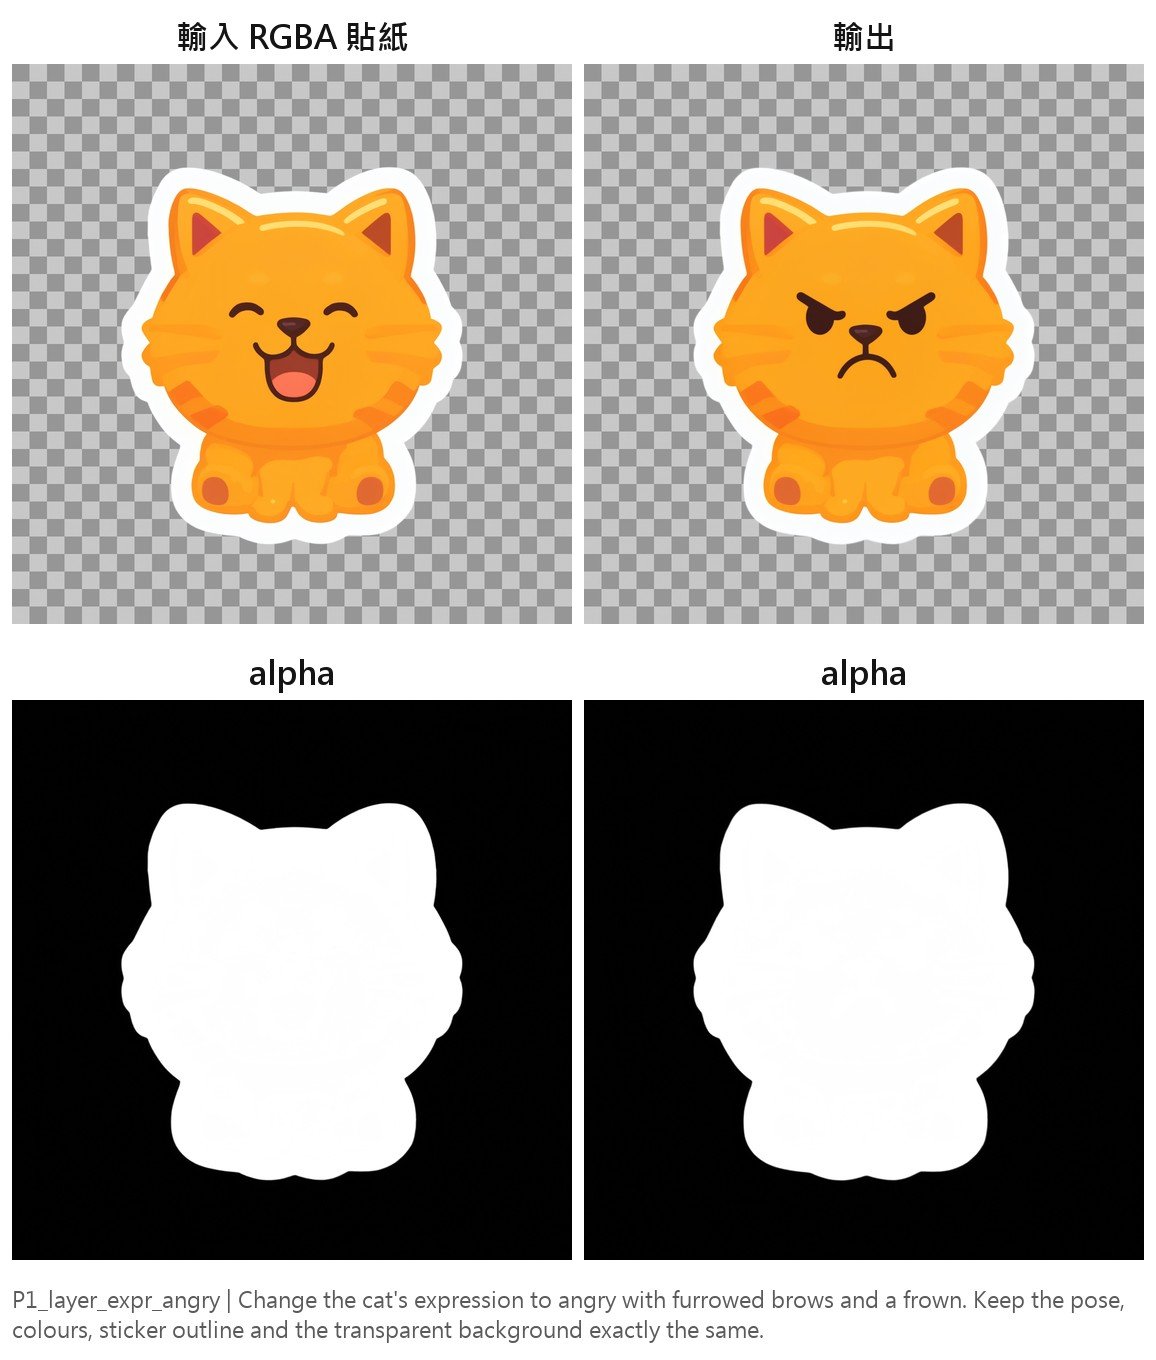
- 透明貼紙直接編輯全部成功。給它一張透明背景的貼紙,說「把 OPEN 改成營業中」或「改成生氣的表情」,出來還是透明背景,貼紙的紅色圓形與白色描邊完全沒有變
- 在圖上畫圈圈沒有必要。用文字說「拿掉手錶、頭髮改成黑色短髮、襯衫換成睡衣」,三個地方一次改對;畫圈或另外給遮罩,結果一樣。拿同一張畫了圈的圖給 Qwen-Image-Edit-2511 試,它反而把圓圈原樣畫進輸出裡
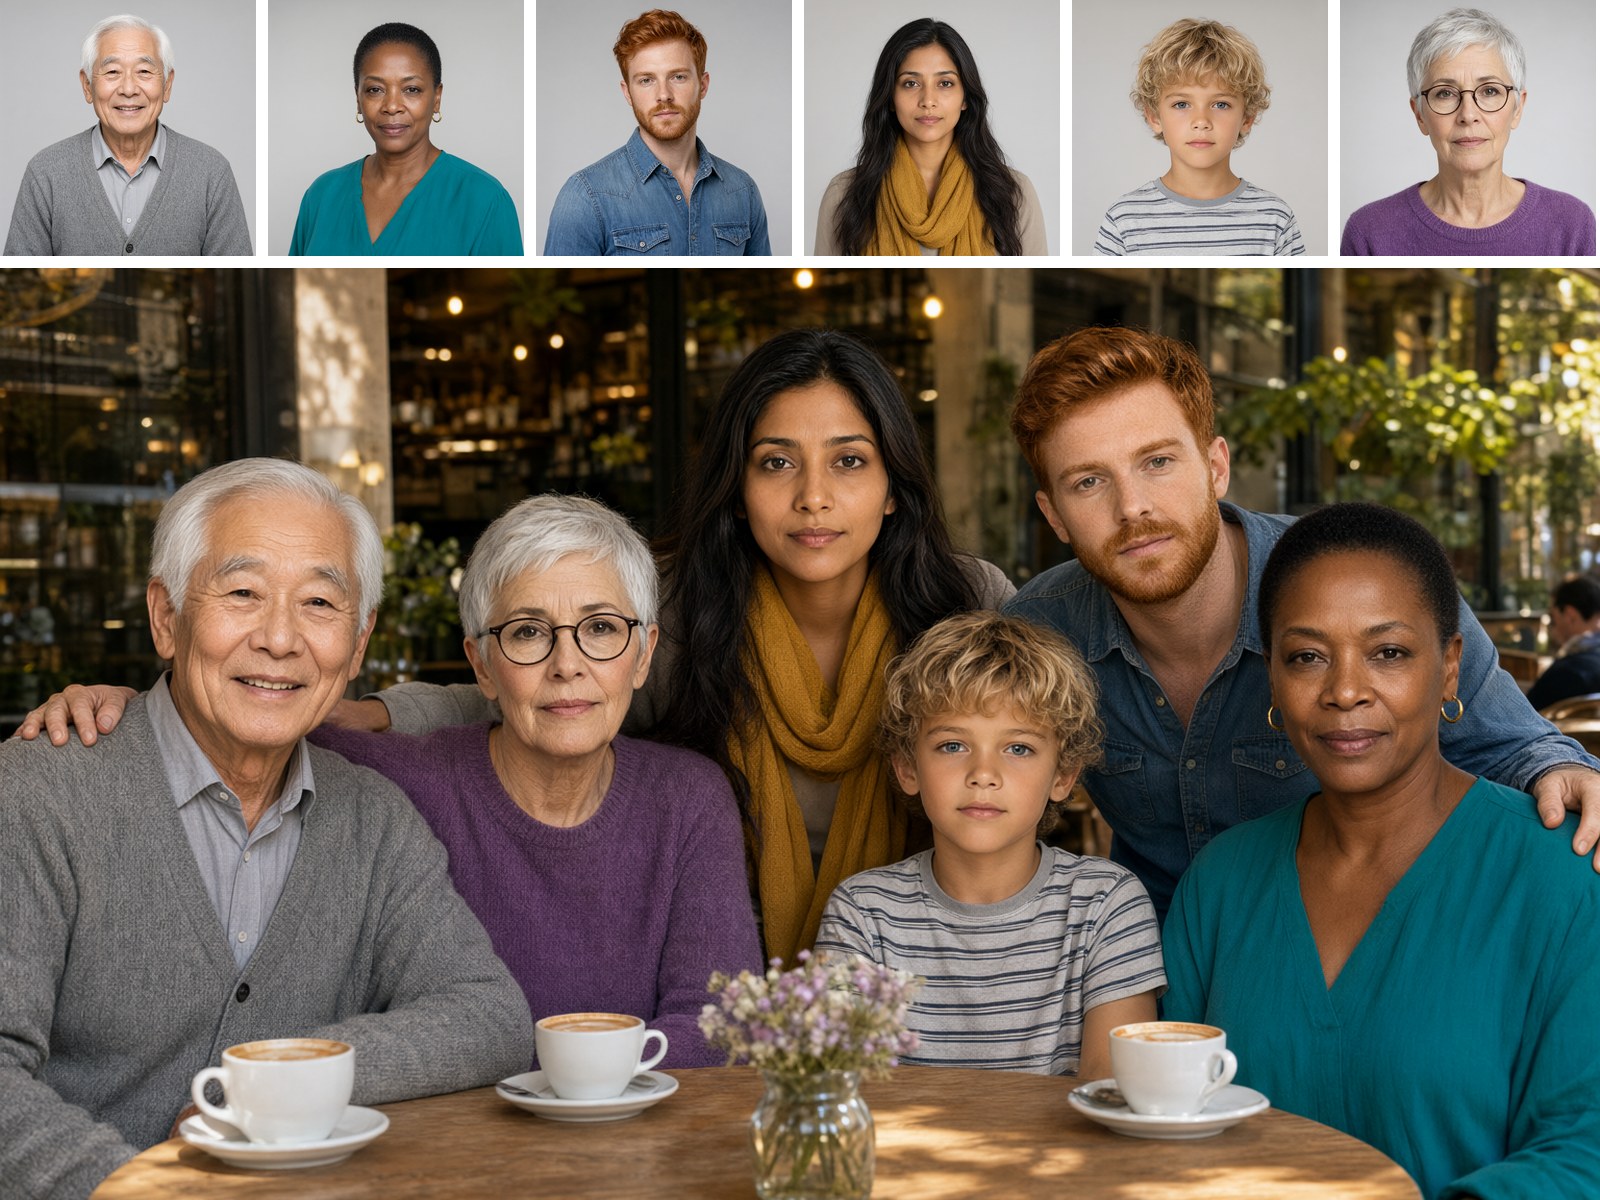
- 多張參考圖合成這次沒有出現重複人物。三張角色視圖做設定圖與四格分鏡、五件衣物配件穿到模特兒身上、六個人合照、十件家具擺成一間房,全部到齊
- 官方 Prompt Enhancer 18 題全勝,構圖、美感、細節、小字的正確率都贏,人像也贏。這跟之前測 SenseNova 的結果不同,那次人像是不改寫比較好
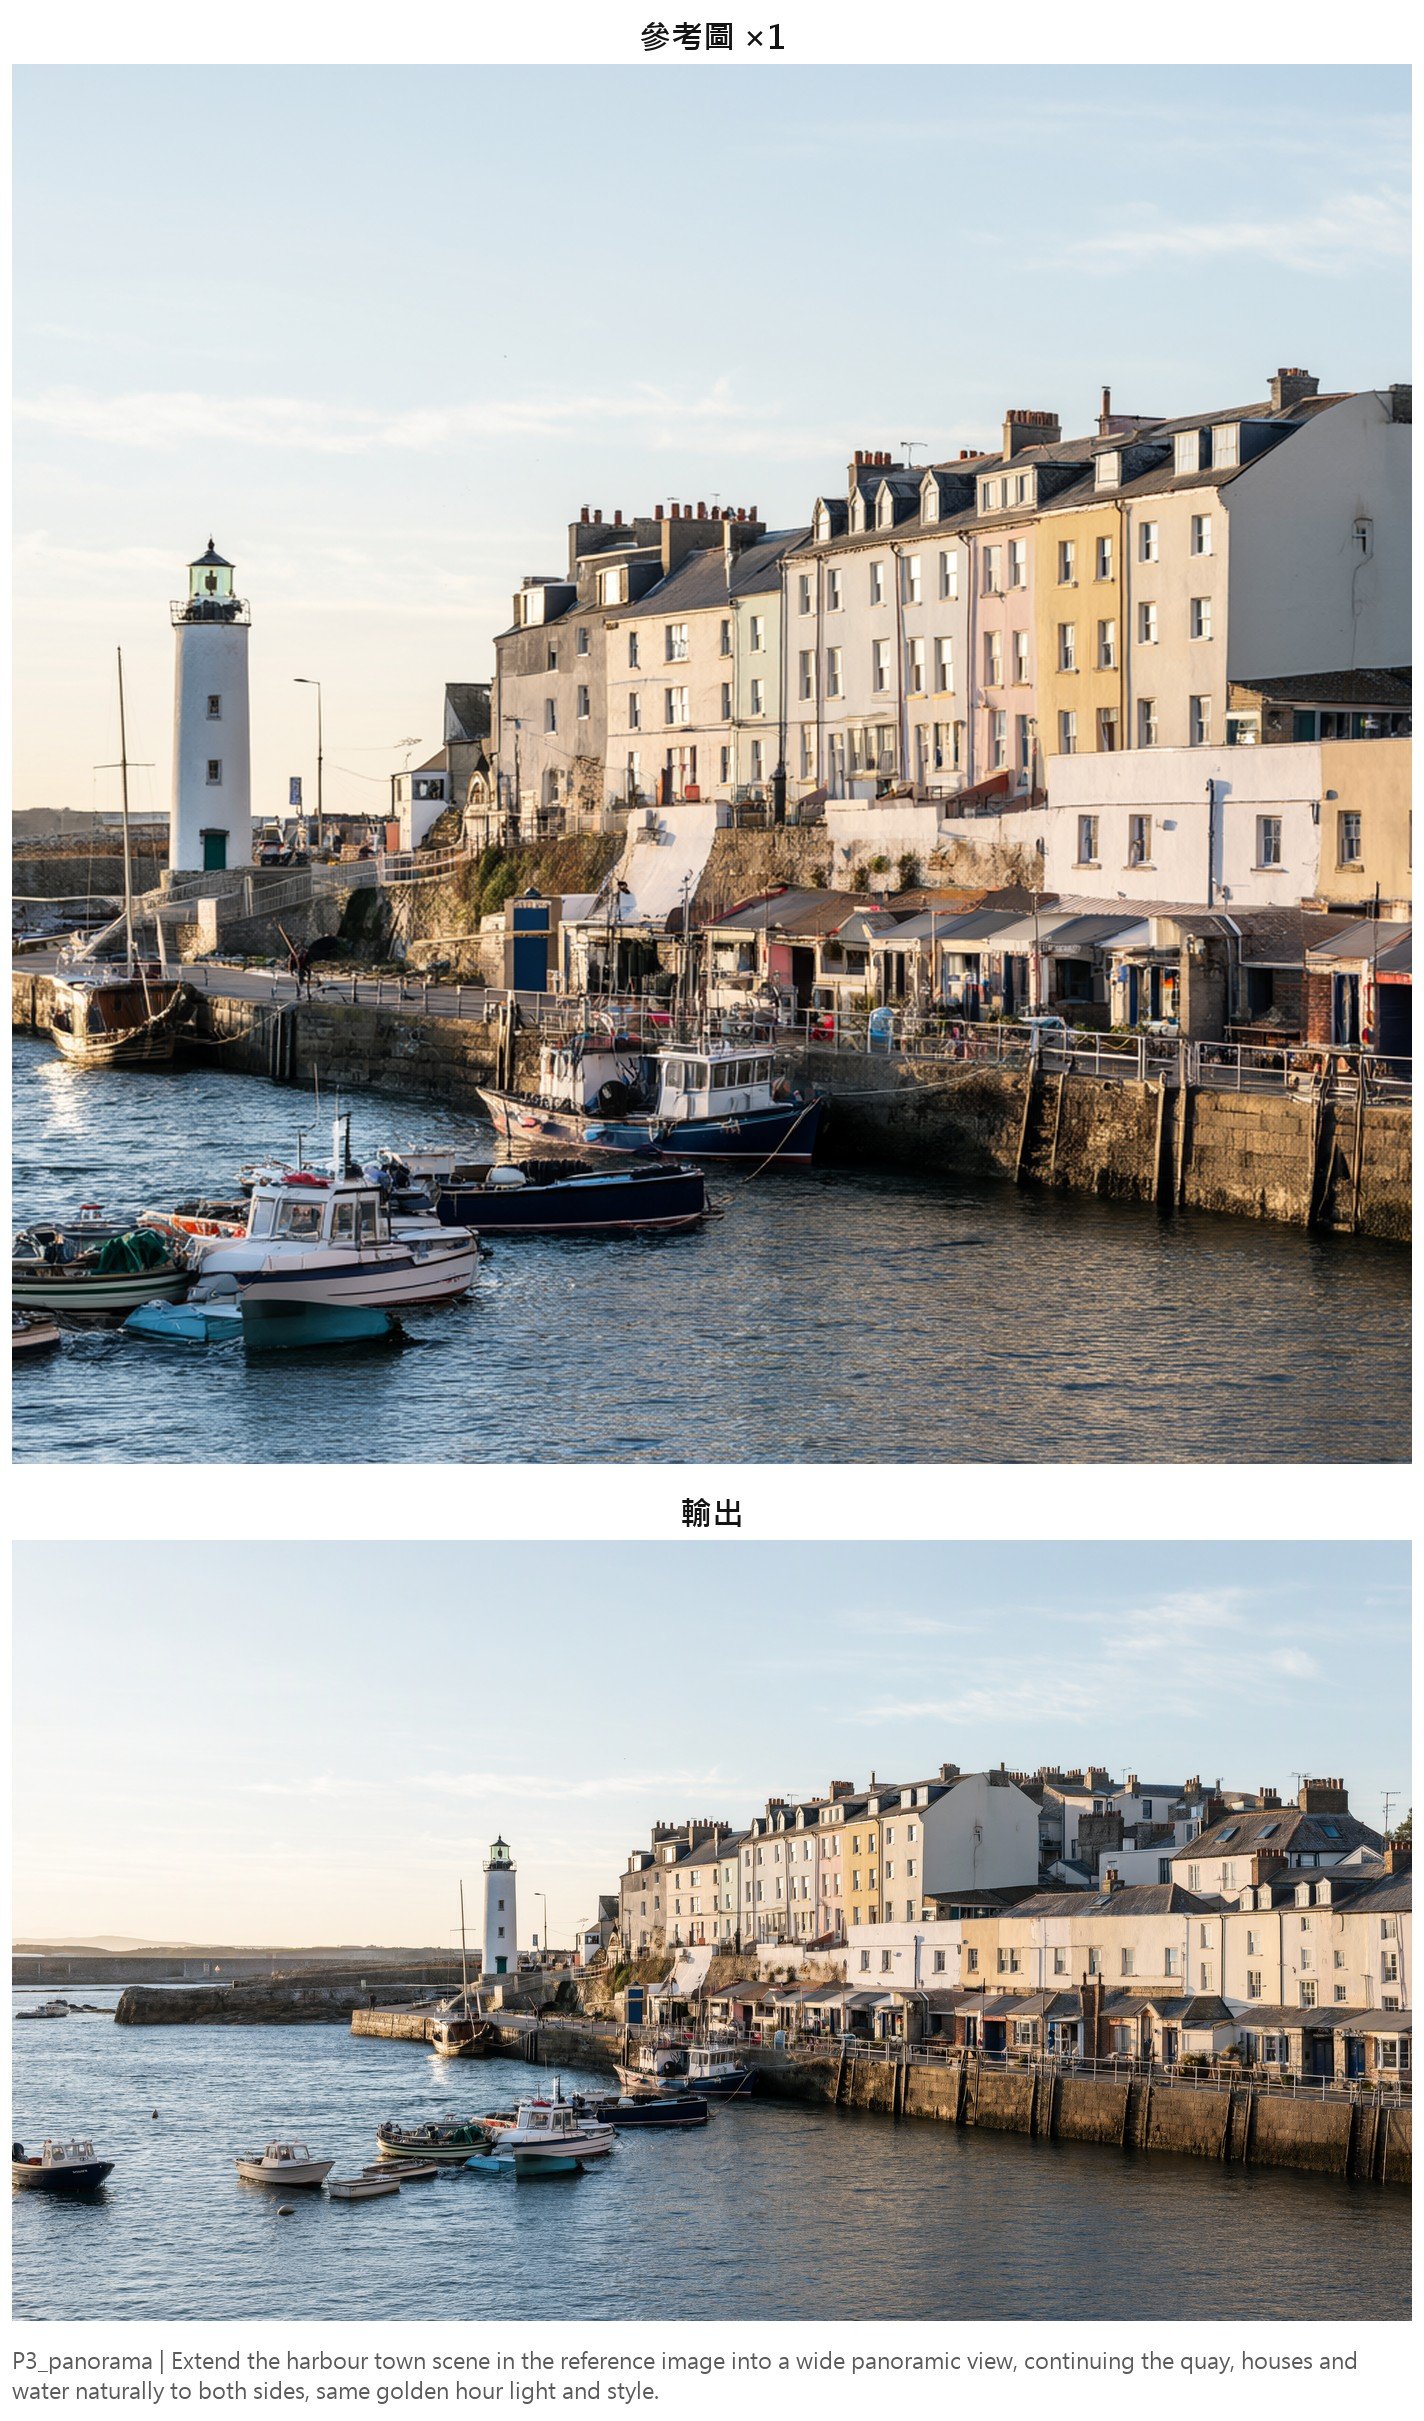
- 不成立的一項:把一張圖「延伸成寬幅全景」,出來的是同風格的重新構圖,不是把原圖往左右兩邊接
- 授權提醒:Qwen Research License,非商用;Prompt Enhancer 的模型也是
這次怎麼測
| 章節 | 題目 | 怎麼判 |
| 透明圖層的用法 | 照片去背成透明圖層 3 題、透明貼紙改字 2 題、改表情 2 題、去背後的圖層放進新背景 2 題 | 成功/部分/失敗 |
| 在圖上畫圈指定要改哪裡 | 兩張圖各三個區域,同一句指令用三種方式給它:只有文字、在圖上畫彩色圓圈、原圖加一張黑白遮罩;畫了圓圈的那張另外拿給 Qwen-Image-Edit-2511 與 HiDream-O1 兩個模型試 | 同上 |
| 多張參考圖合成 | 角色設定圖、四格分鏡、五件衣物配件穿搭、六人合照、十件家具擺房、單張圖延伸成全景 | 同上 |
| Prompt Enhancer | 16 題文生圖(8 題繁體中文的資訊版面、8 題仿單、漫畫、人像),同一個 seed、同一個尺寸,比「照原句生」與「先改寫再生」;另外 2 題多張參考圖合成,比原指令與改寫後的指令 | 改寫勝/平/原句勝 |
參考圖與測試用的底圖全部是用 Qwen-Image-2.1 生成的,不是真實照片,這點先講明。所有生圖 25 步、CFG 1,跟上一篇相同。
一、透明圖層:去背、改字、放進新背景
上一篇證明它能直接生成透明背景的圖,這次試的是已經是透明背景的圖,能不能再拿來編輯。給它一張紅色 OPEN 貼紙,指令是「把 OPEN 改成營業中,貼紙的樣式、顏色與透明背景保持不變」。
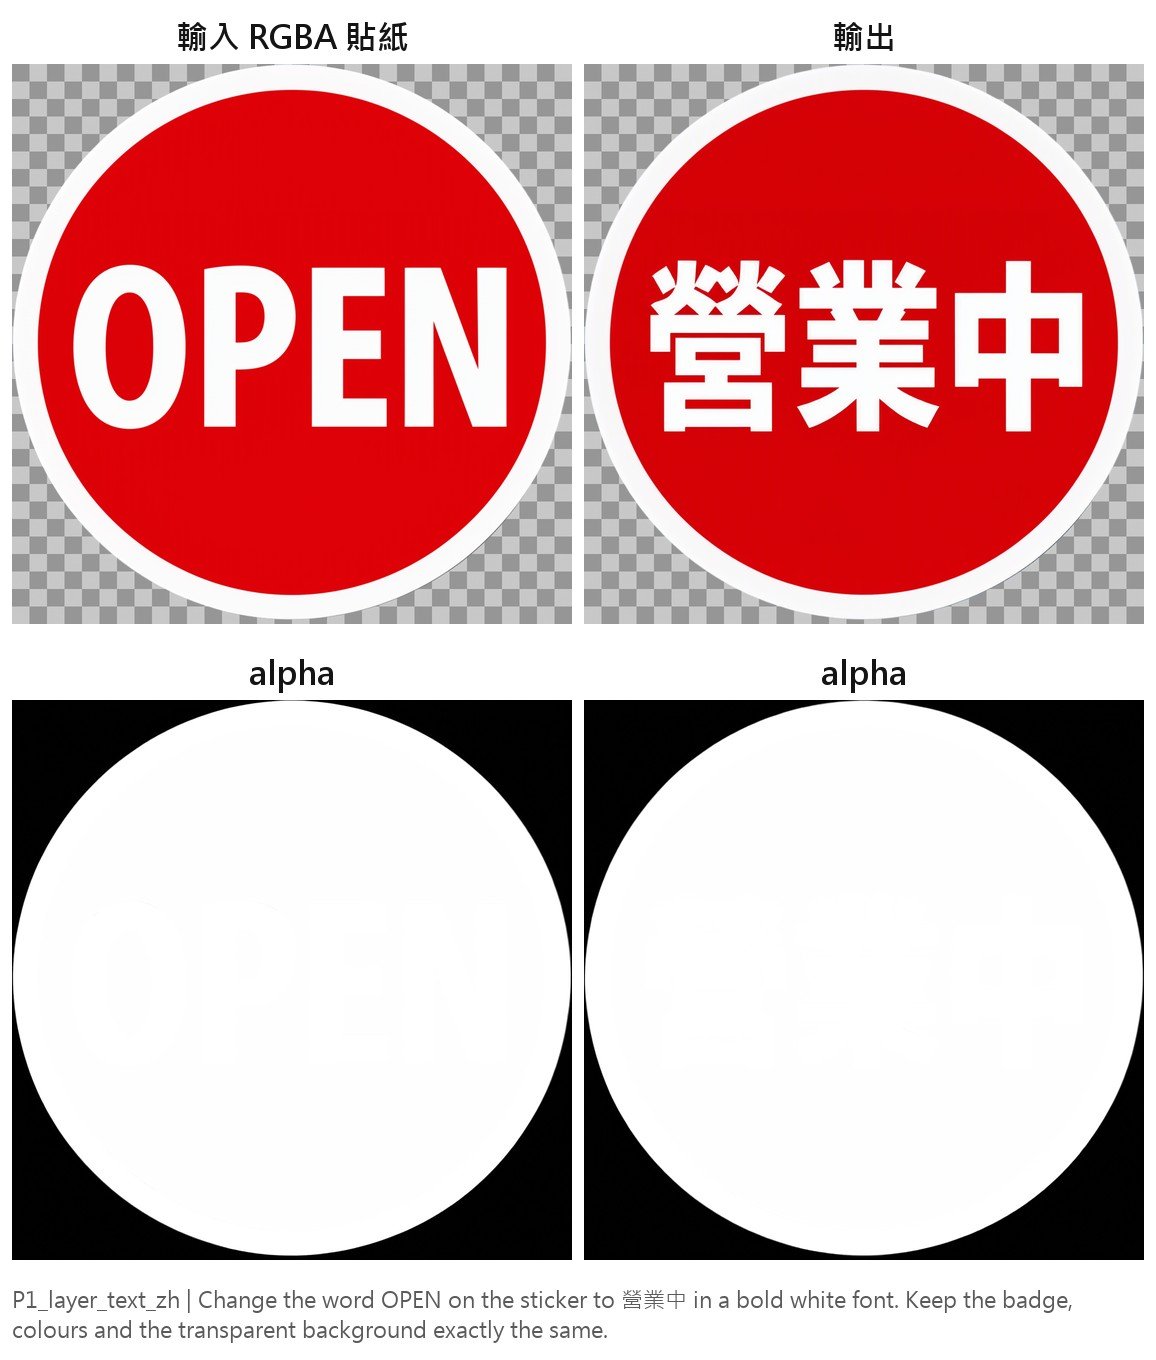
字改對了,貼紙的紅色圓形與白色描邊完全沒有變,透明的範圍也跟輸入幾乎一樣。改成英文 CLOSED、把貓貼紙改成生氣或想睡的表情,四題全部成功。做貼圖、圖示的人會很有感:改一個字不用整張重生,也不用重新去背。
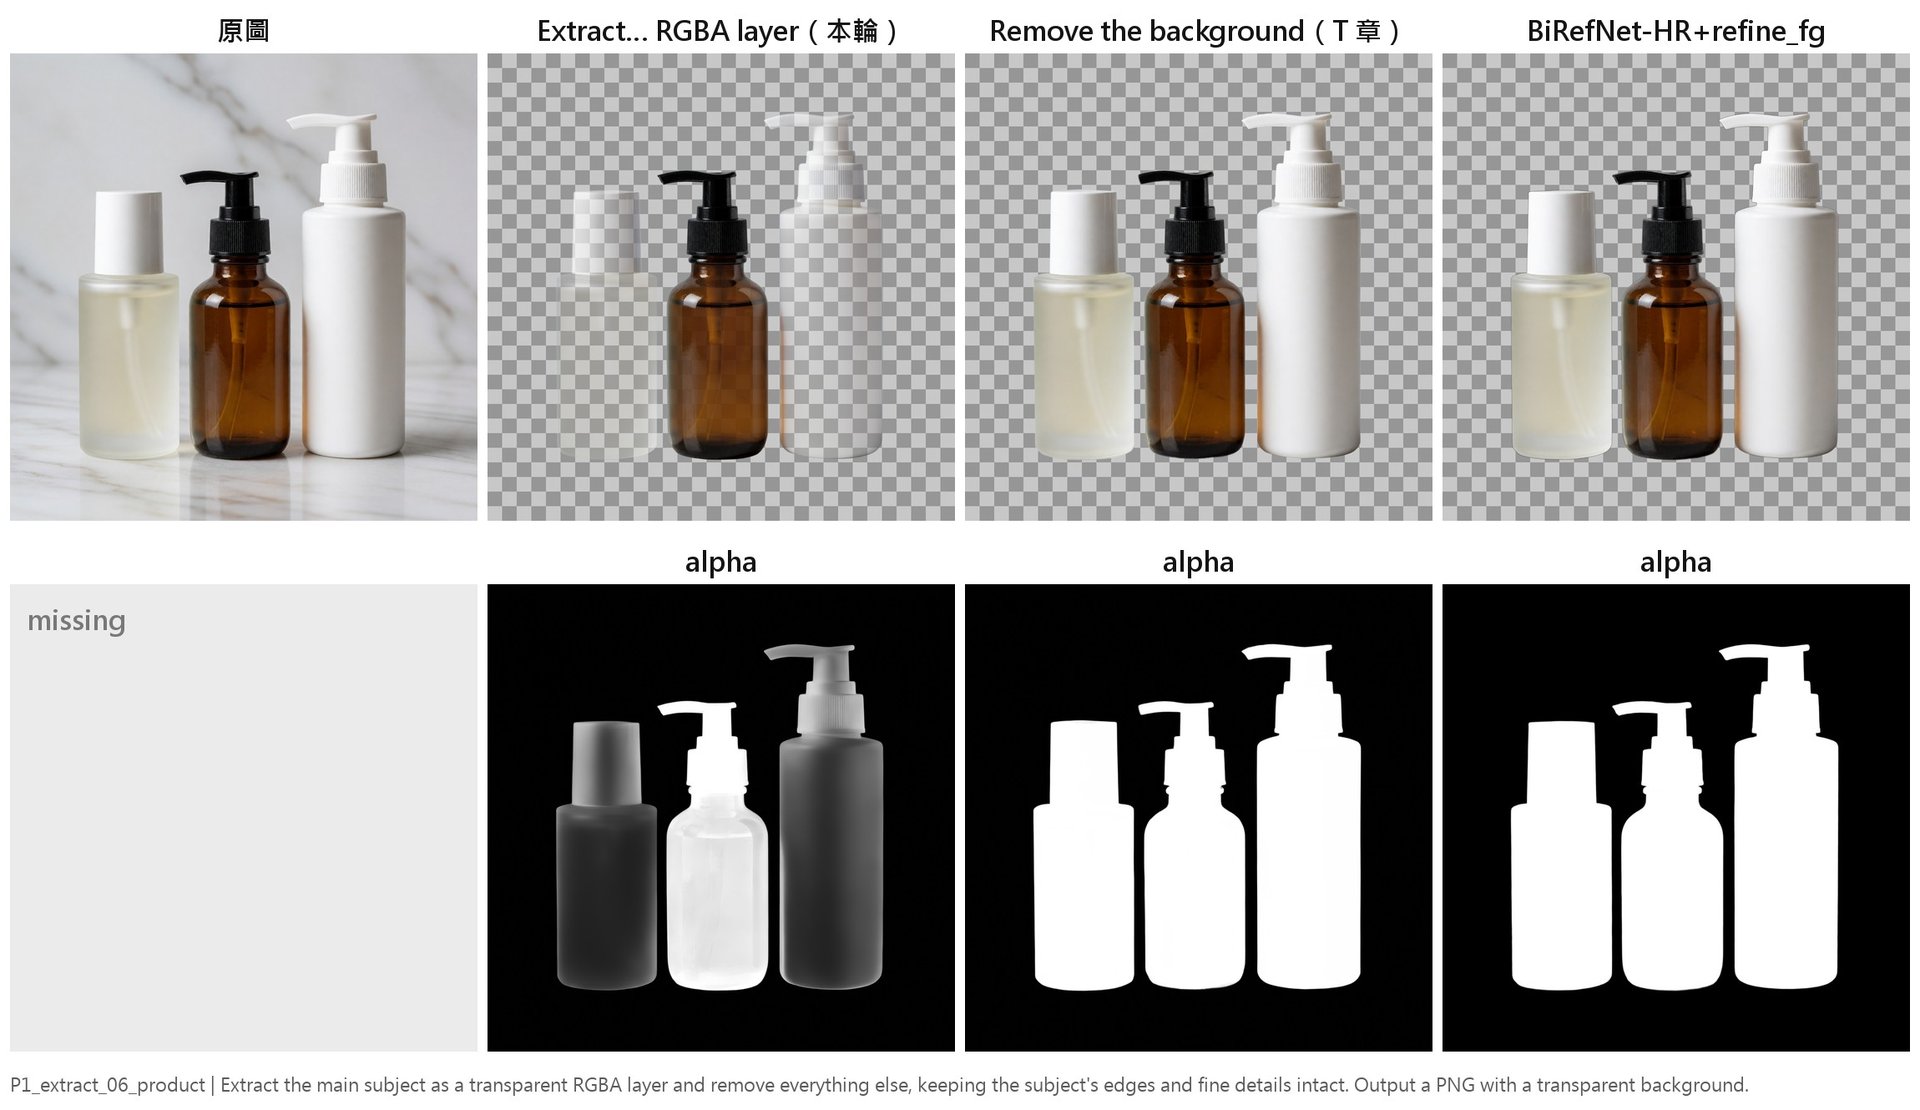
把照片裡的人物去背成透明圖層這件事,上一篇用官方範本的那句「Remove the background」測過,結論是輸給專門的去背模型。這次換一句話:「Extract the main subject as a transparent RGBA layer」,意思是把主體抽出來做成透明圖層。髮絲那題就沒有再把背景的光點誤留下來。
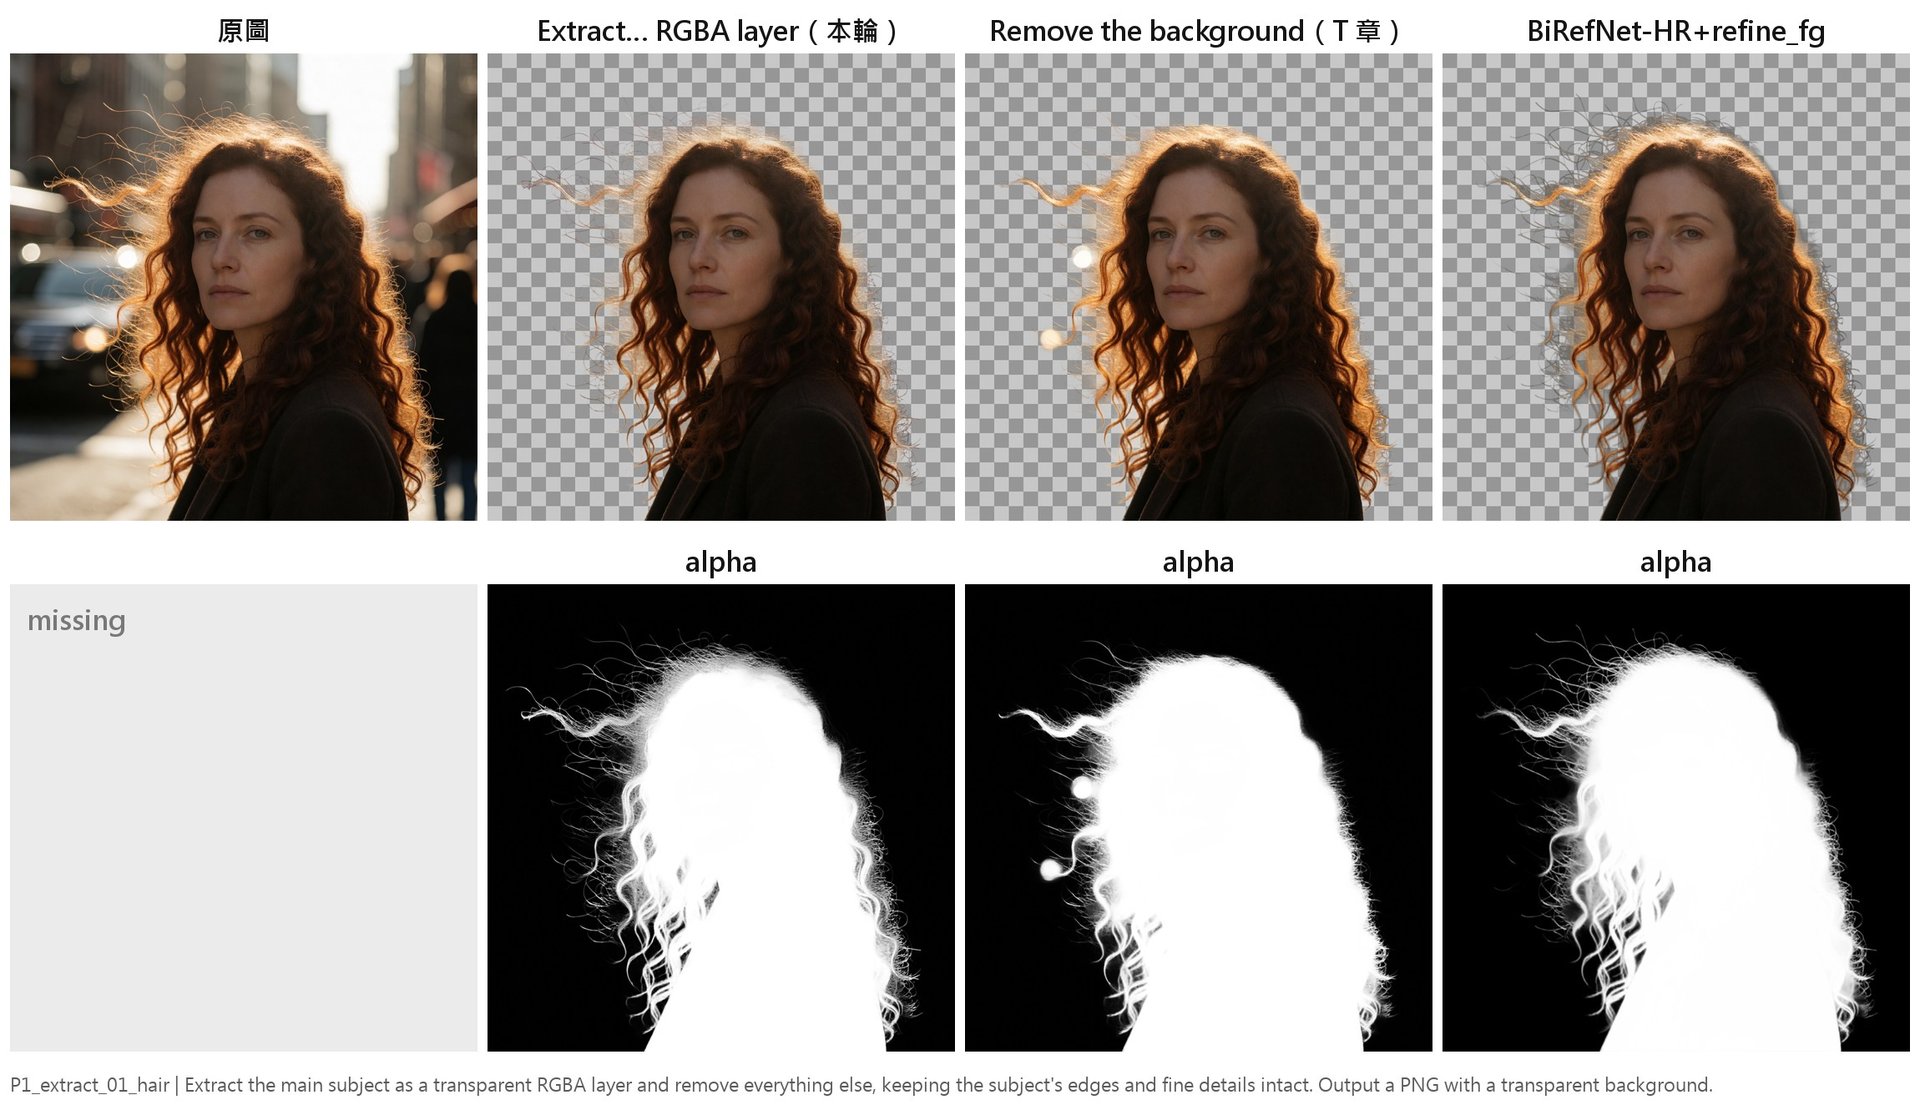
三題裡髮絲與動漫成功,商品照算部分成功:瓶子有去背出來,但磨砂材質的瓶蓋也被做成半透明。
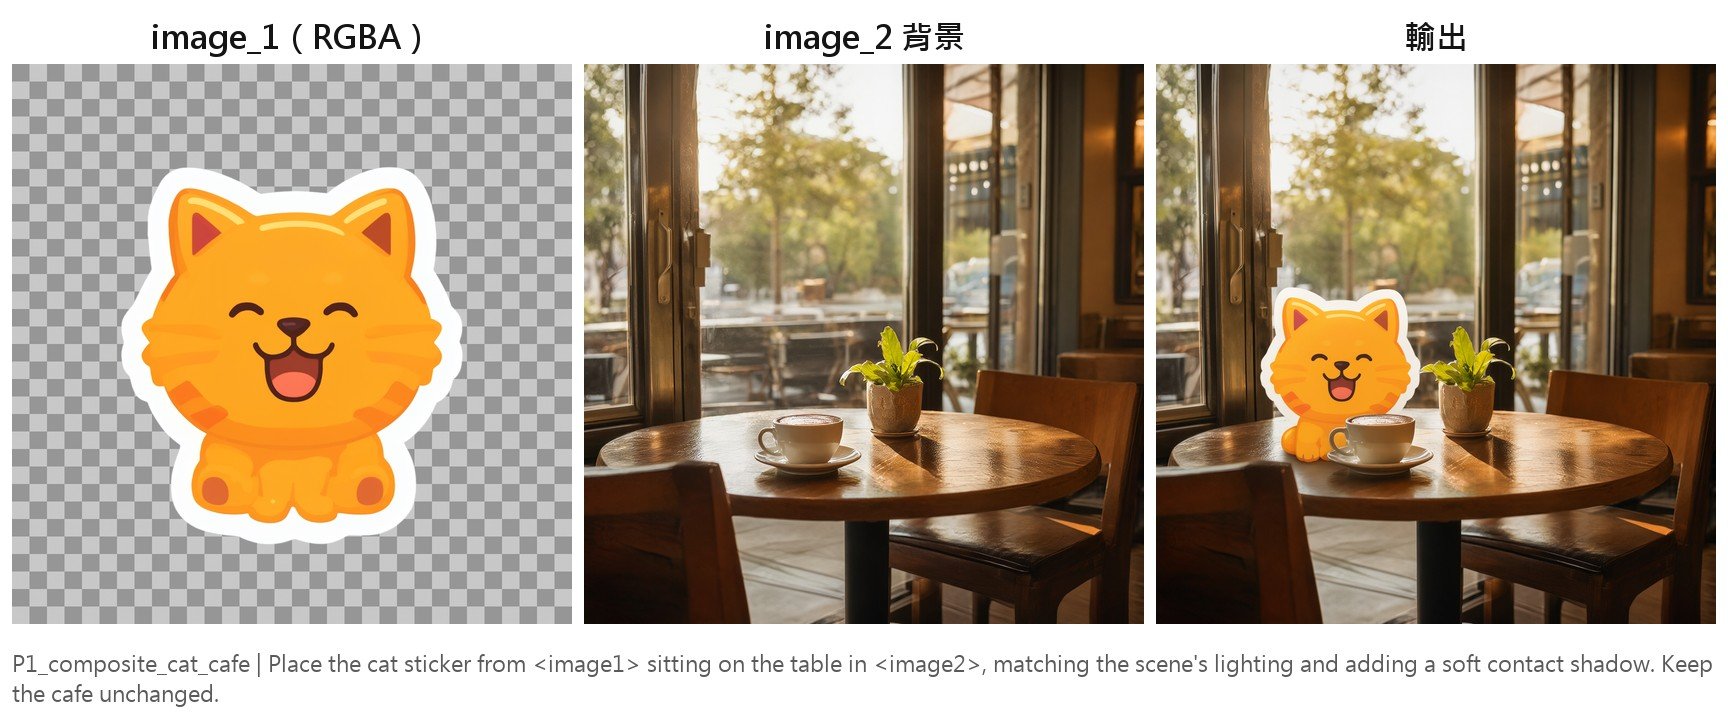
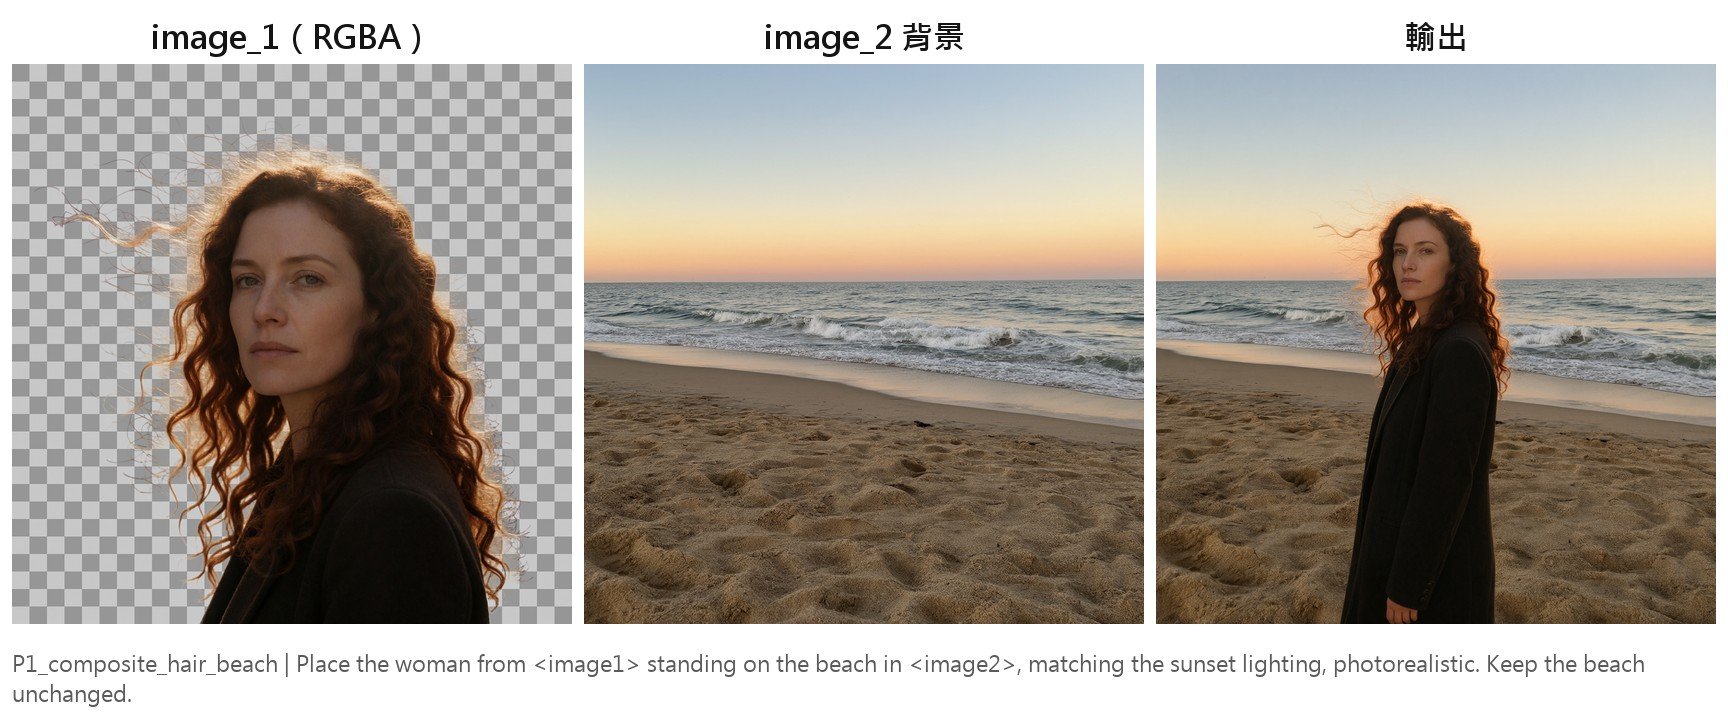
去背出來的透明圖層可以直接當參考圖,放進另一張背景裡。貓貼紙放到咖啡桌上有接觸桌面的影子;去背出來的女子放到沙灘上,夕陽的逆光方向對得上,髮絲邊緣也乾淨。
二、在圖上畫圈指定要改哪裡:畫圈沒有必要
官方展示過一種用法:在原圖上用不同顏色的圓圈標出多個區域,一句指令同時改。我照做:藍圈拿掉手錶、紅圈頭髮改成黑色短髮、綠圈襯衫換成灰色亞麻睡衣。同一張圖再做兩個版本比較:一個只用文字不畫圈,一個給原圖加一張黑白遮罩標出要改的區域。
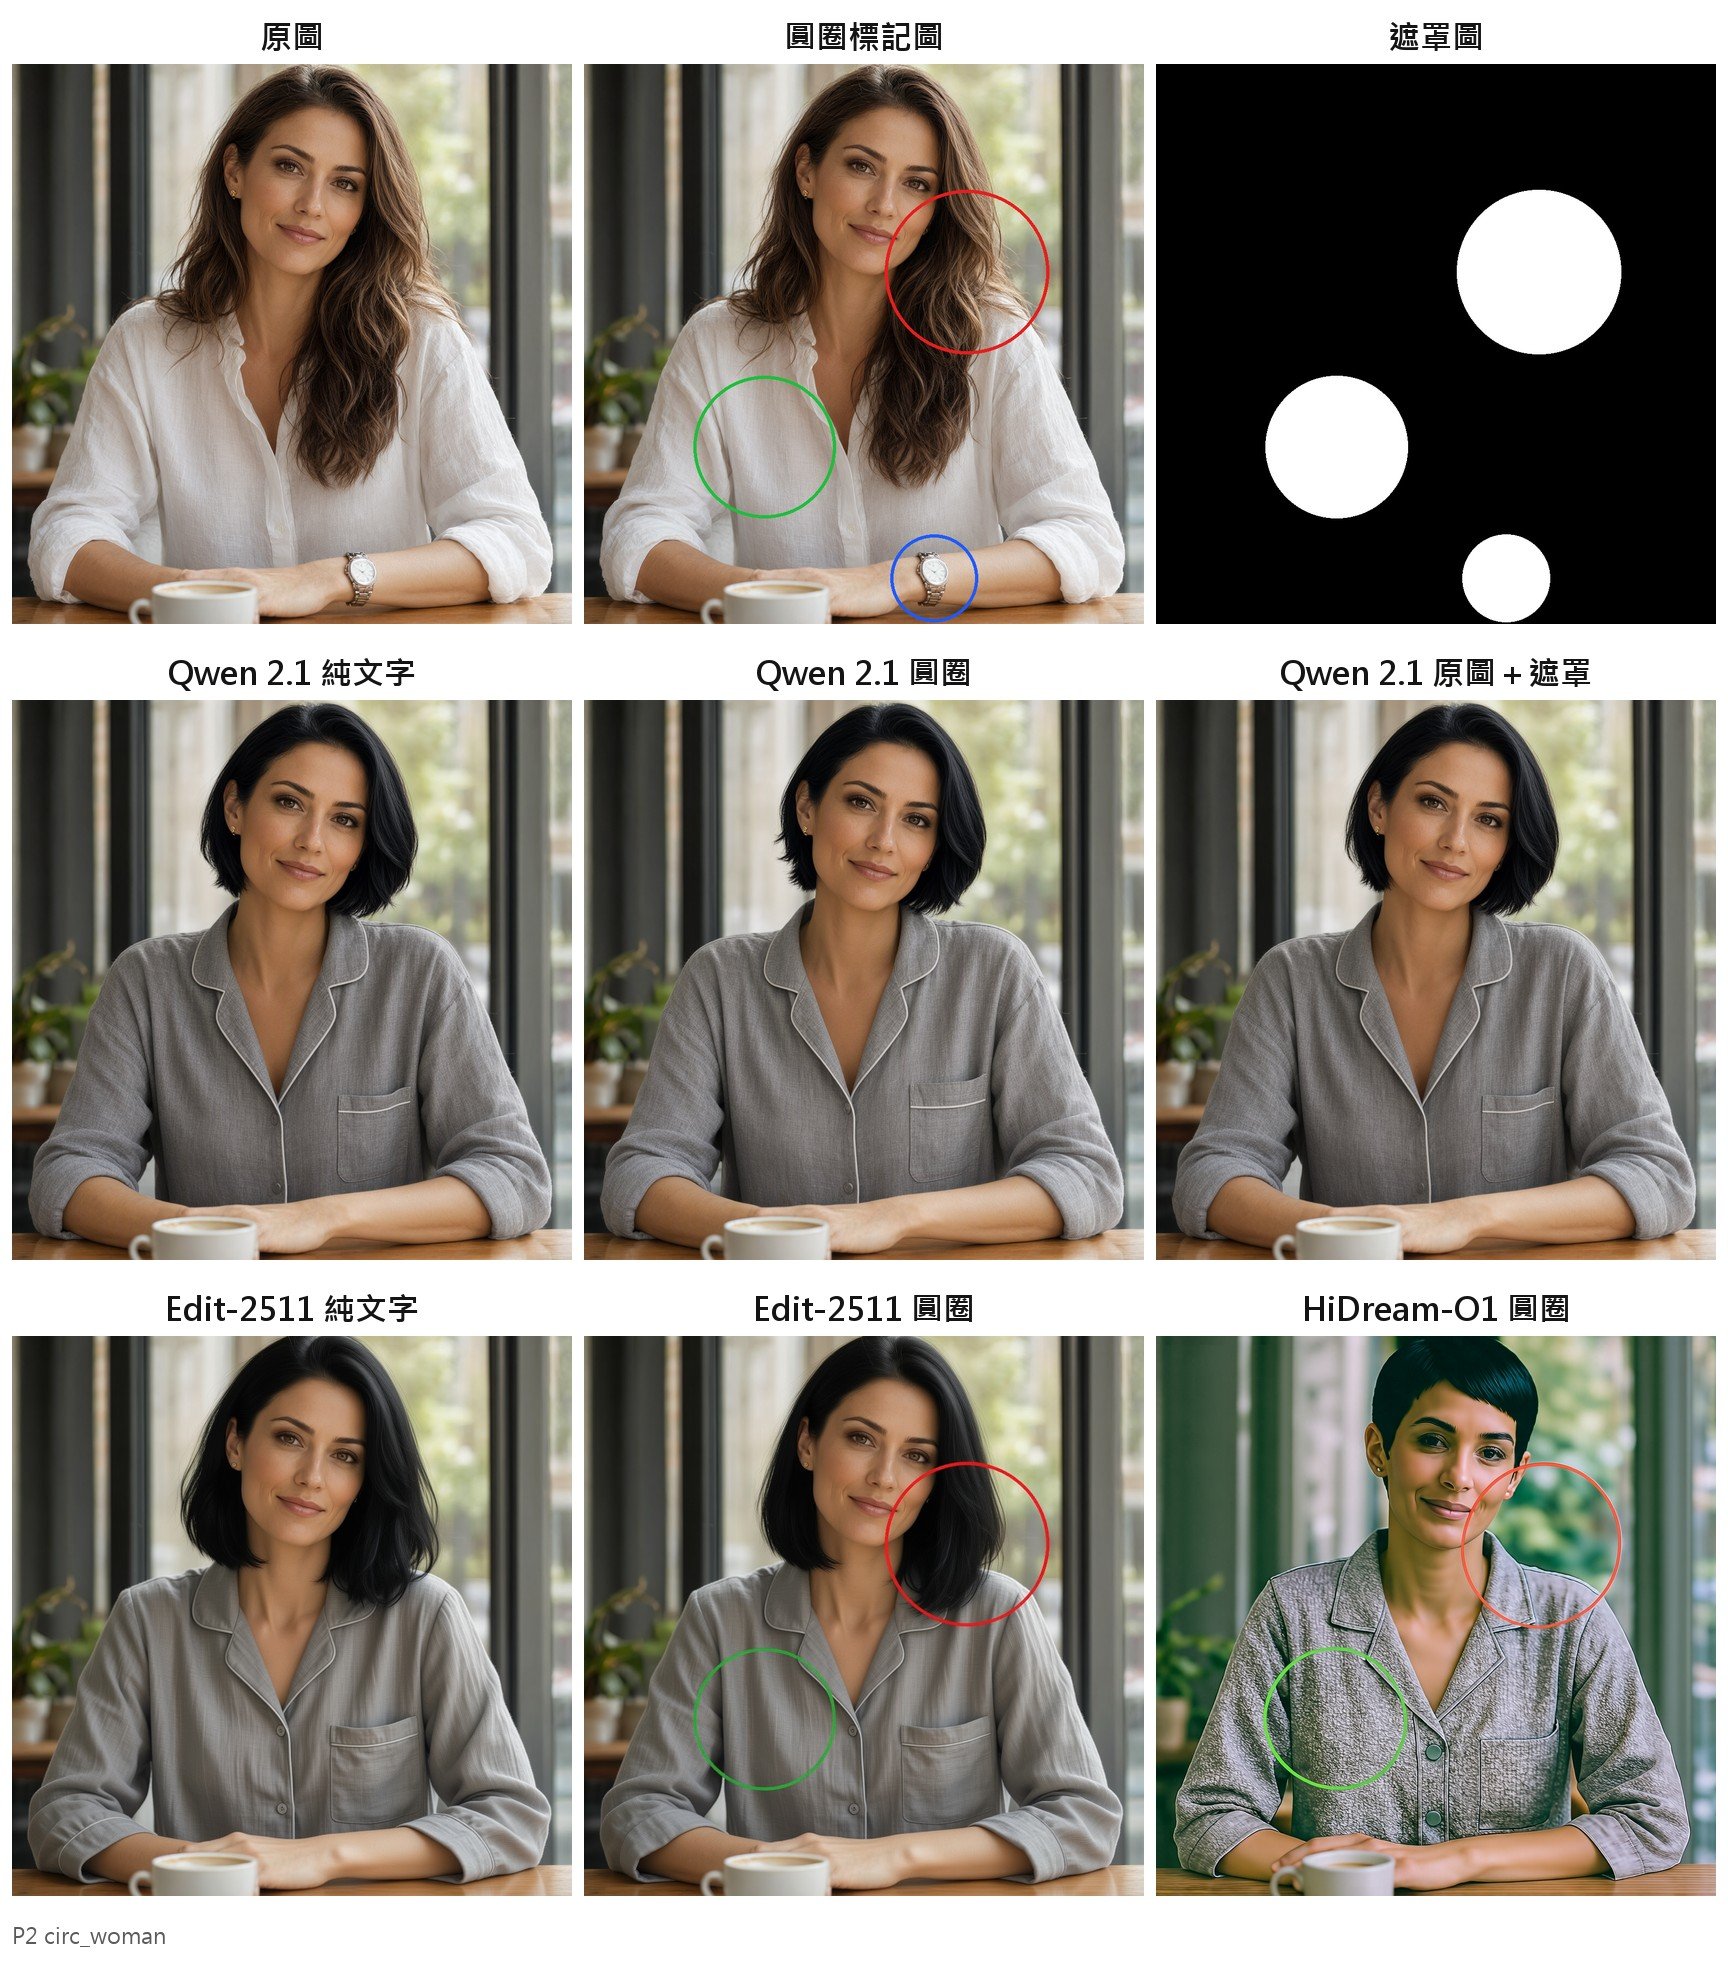
Qwen 2.1 三種方式的結果幾乎一樣:三個地方都改對,輸出裡沒有殘留圓圈。也就是說畫圈對它沒有額外幫助,但也沒有壞處,用文字說清楚就夠了。另外兩個模型就不一樣:Qwen-Image-Edit-2511 只用文字時也全對,但給它畫了圈的圖,它把三個圓圈原樣畫回輸出裡,把圓圈當成畫面的一部分;HiDream-O1 拿到畫了圈的圖,整張色調跑掉,圓圈也殘留。
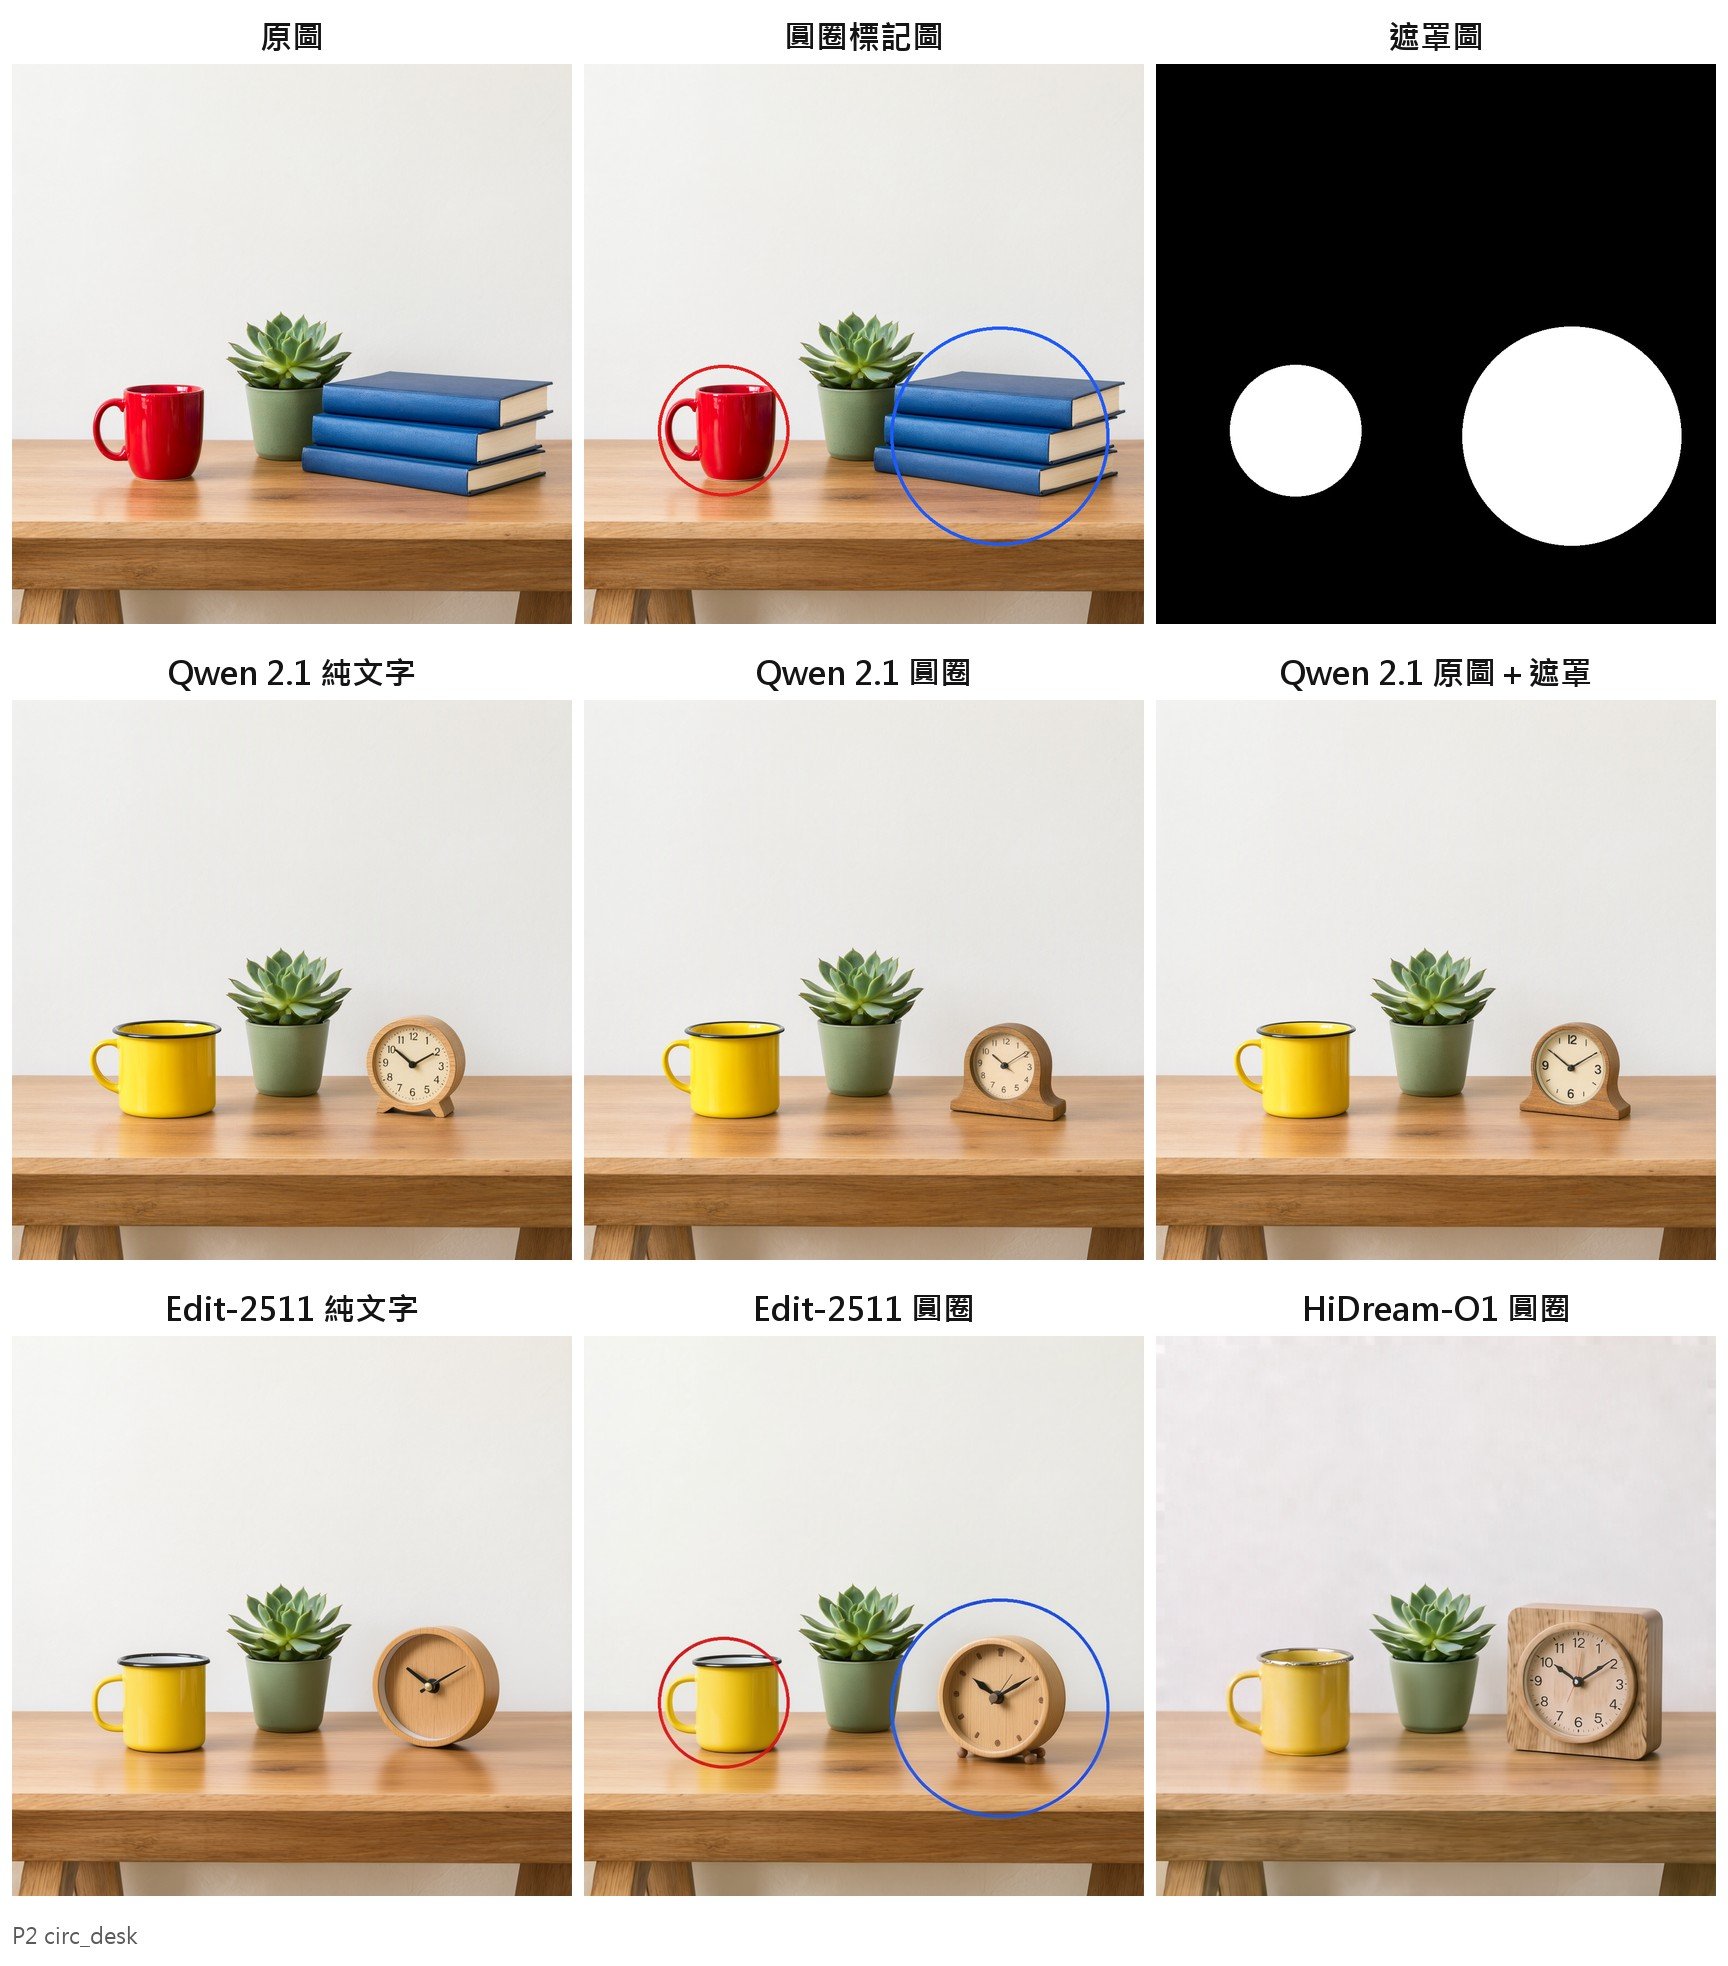
桌面題同樣,Qwen 2.1 三張全對,Qwen-Image-Edit-2511 又把圓圈畫回去。
三、多張參考圖合成:這次沒有重複人物
上一篇多張參考圖合成有兩個問題:女孩夜市那題畫出兩個一模一樣的女孩,柯基與馬克杯那題杯子比例不對。這次照官方與社群整理的用法再試一輪,參考圖從三張到十張。
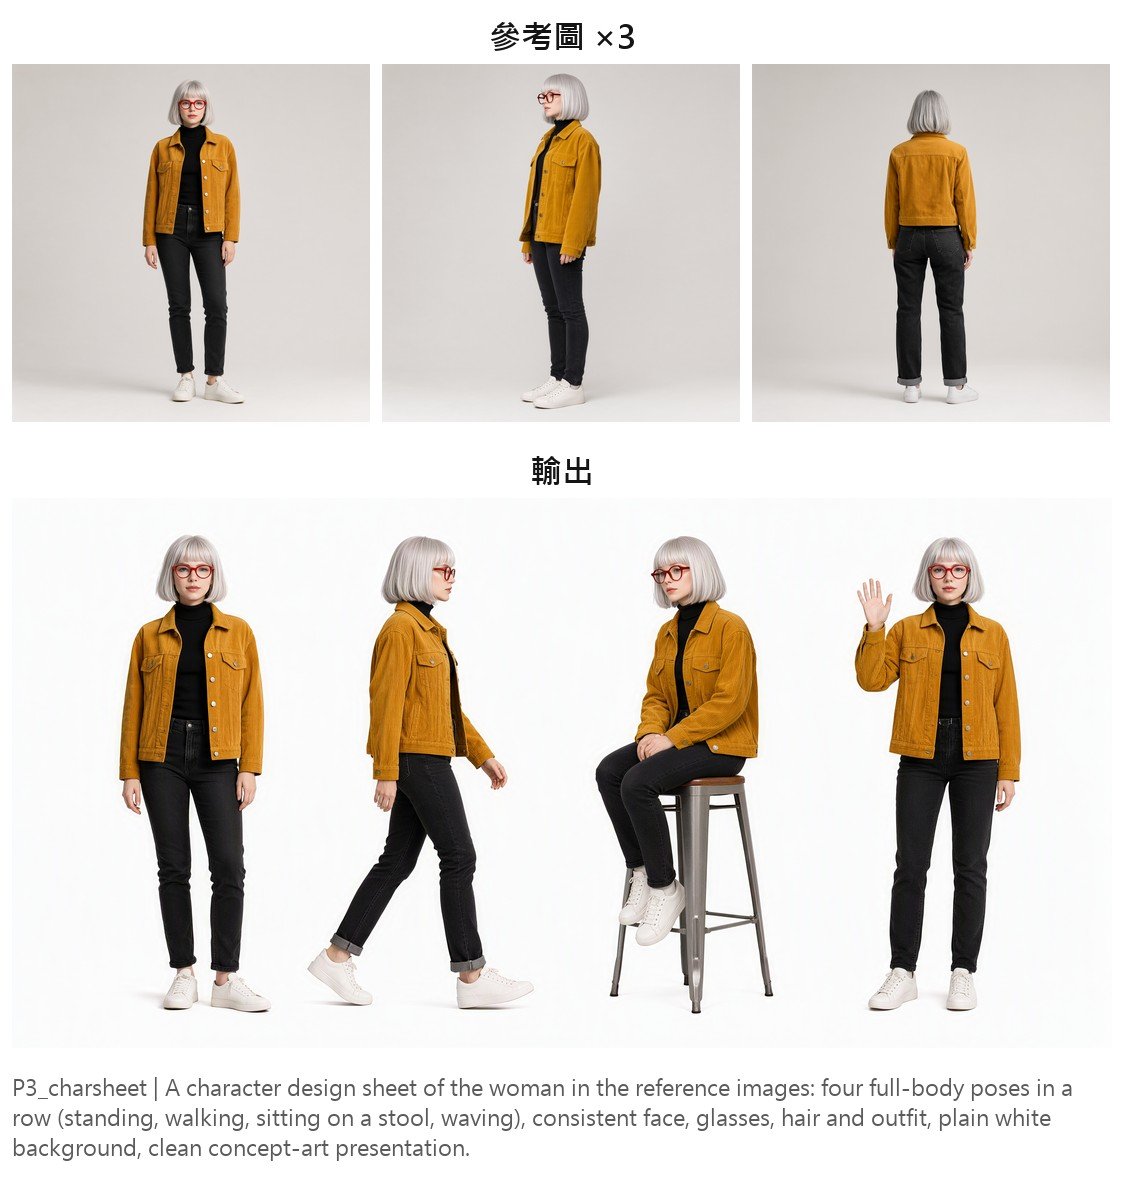
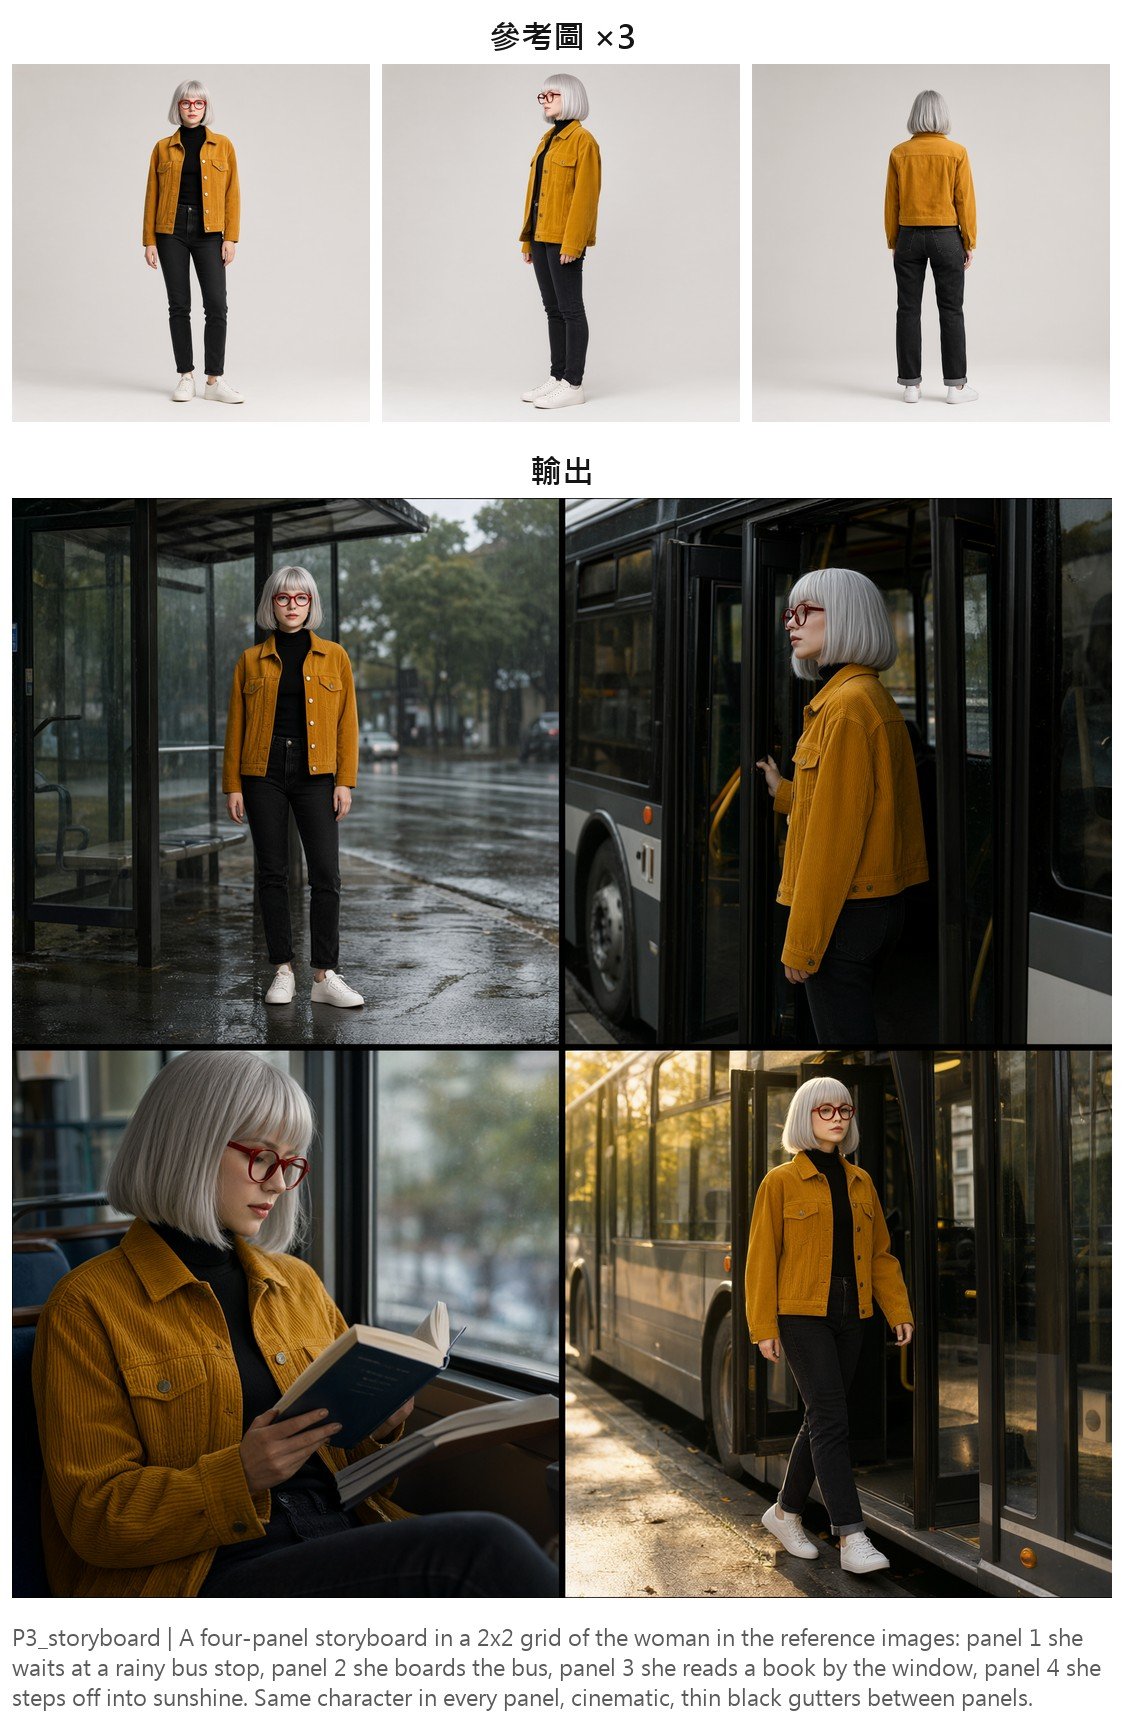
三張角色視圖做設定圖與分鏡:給正面、側面、背面三張圖,要求同一個角色以四種姿勢排成一排。四個都是同一人,銀髮、紅框眼鏡、芥黃色外套、白鞋全對,沒有多餘的人物。四格分鏡也是同一角色,情節從雨中等公車到陽光下下車。
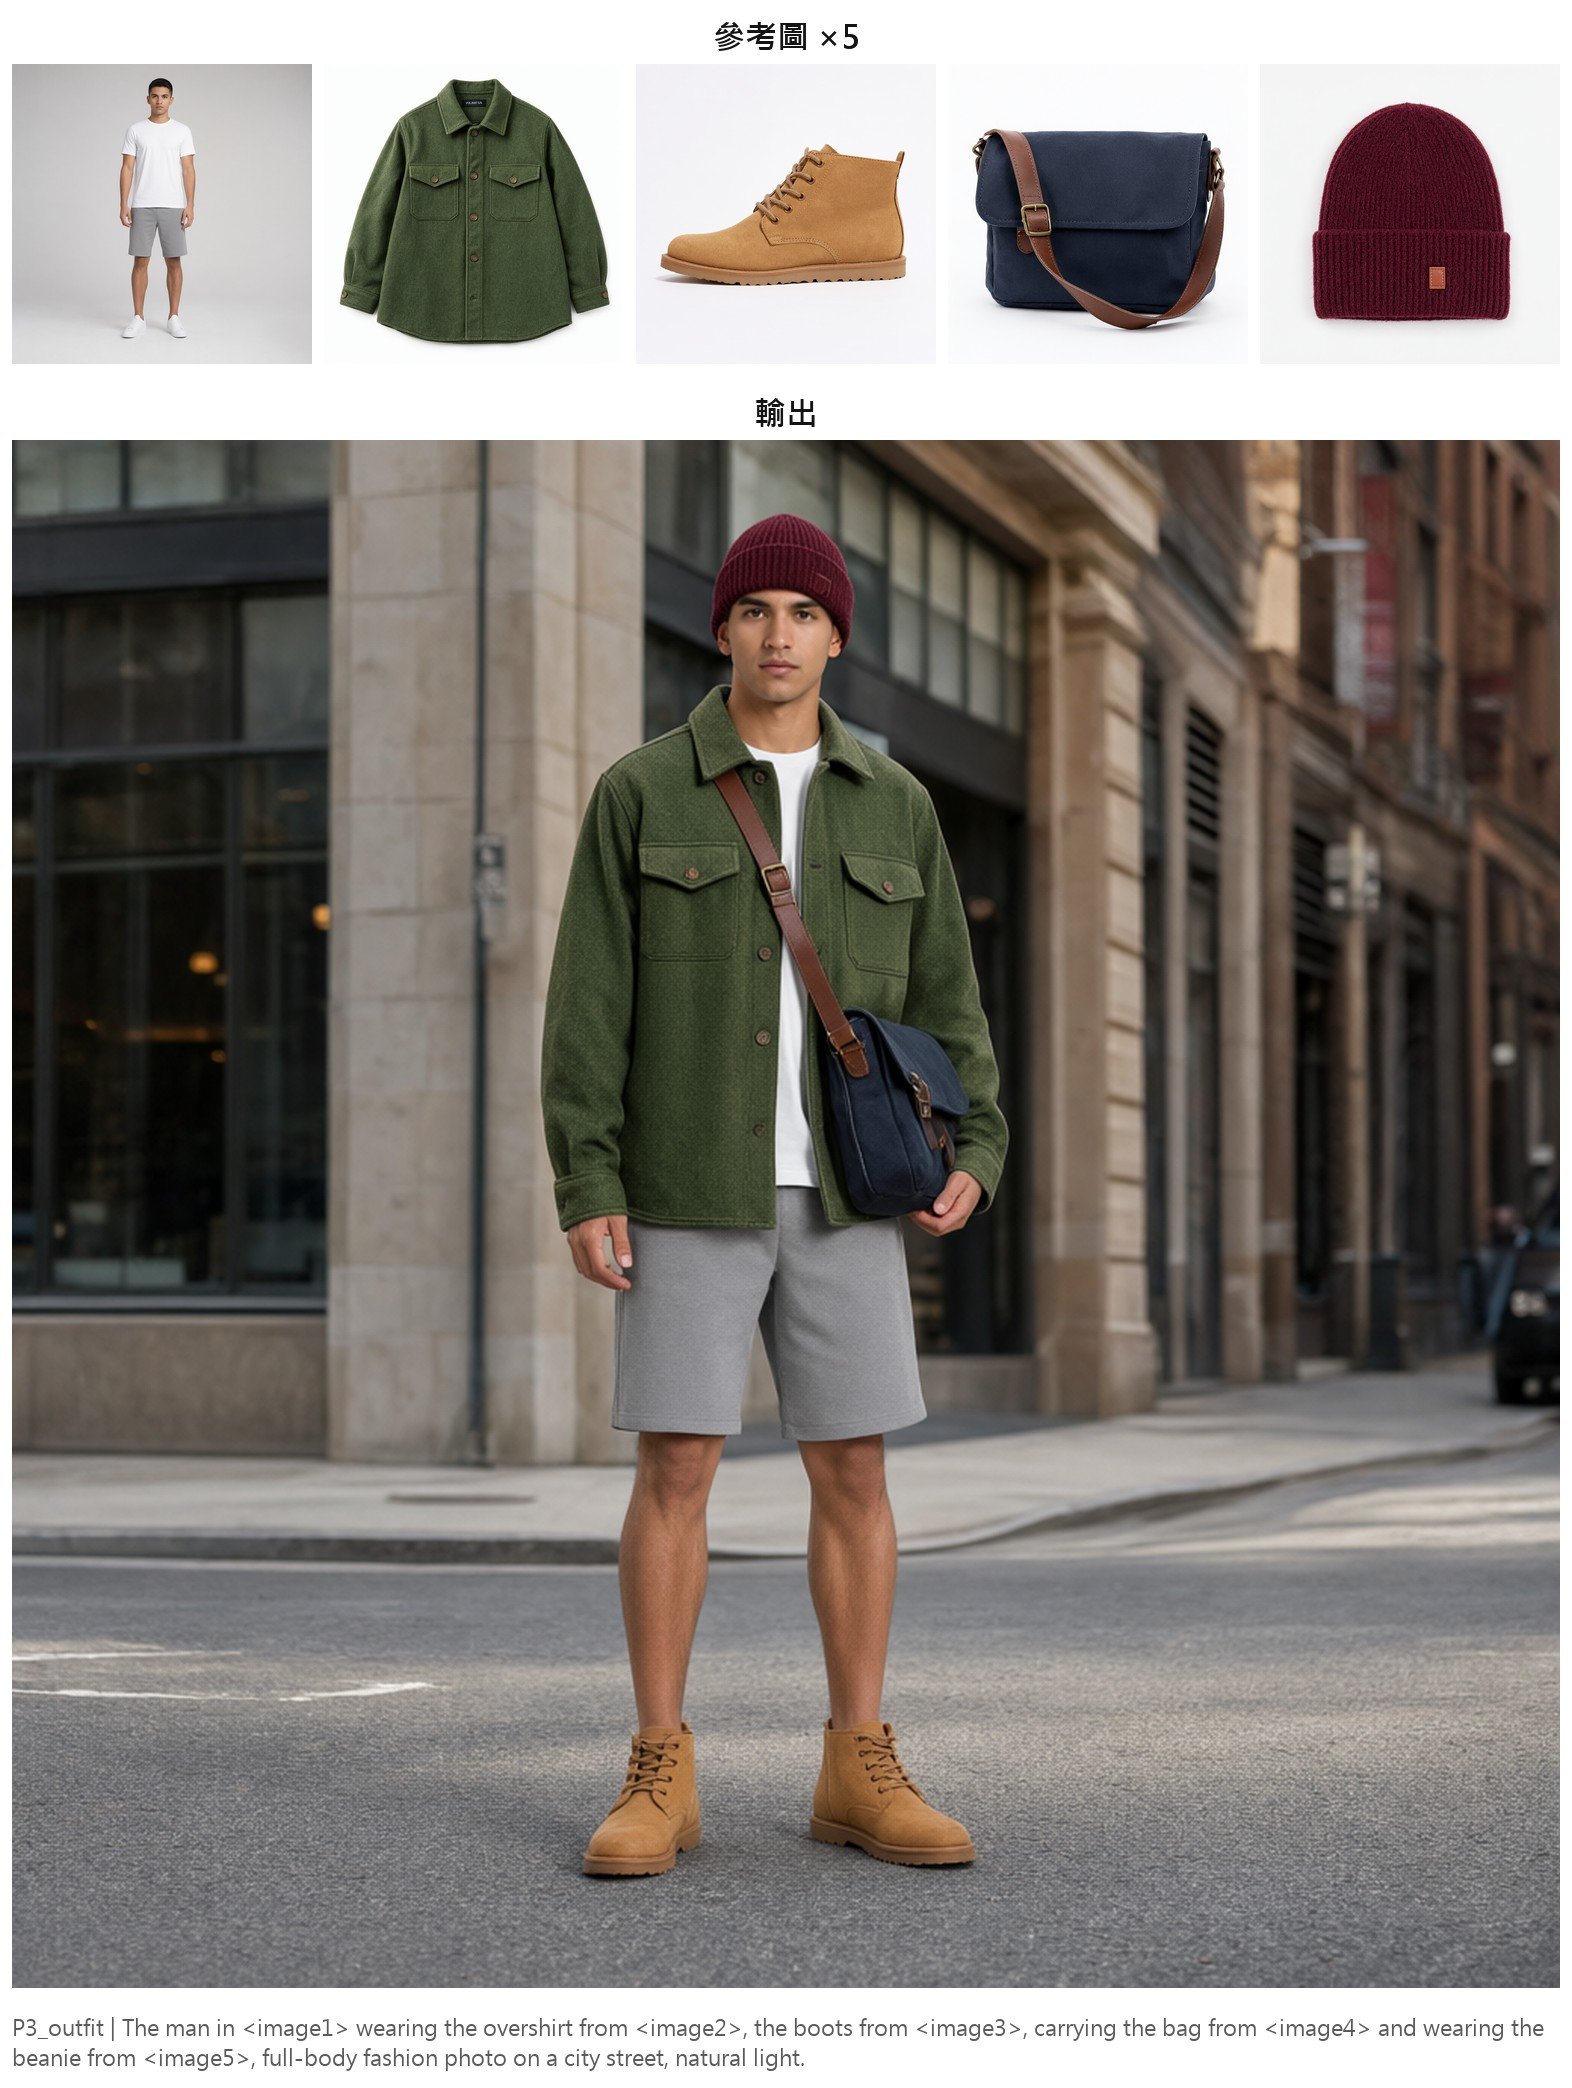
五件衣物配件穿到模特兒身上:模特兒、綠色羊毛外套、沙漠靴、郵差包、毛帽五張參考圖,全部穿戴上身,款式與顏色正確。
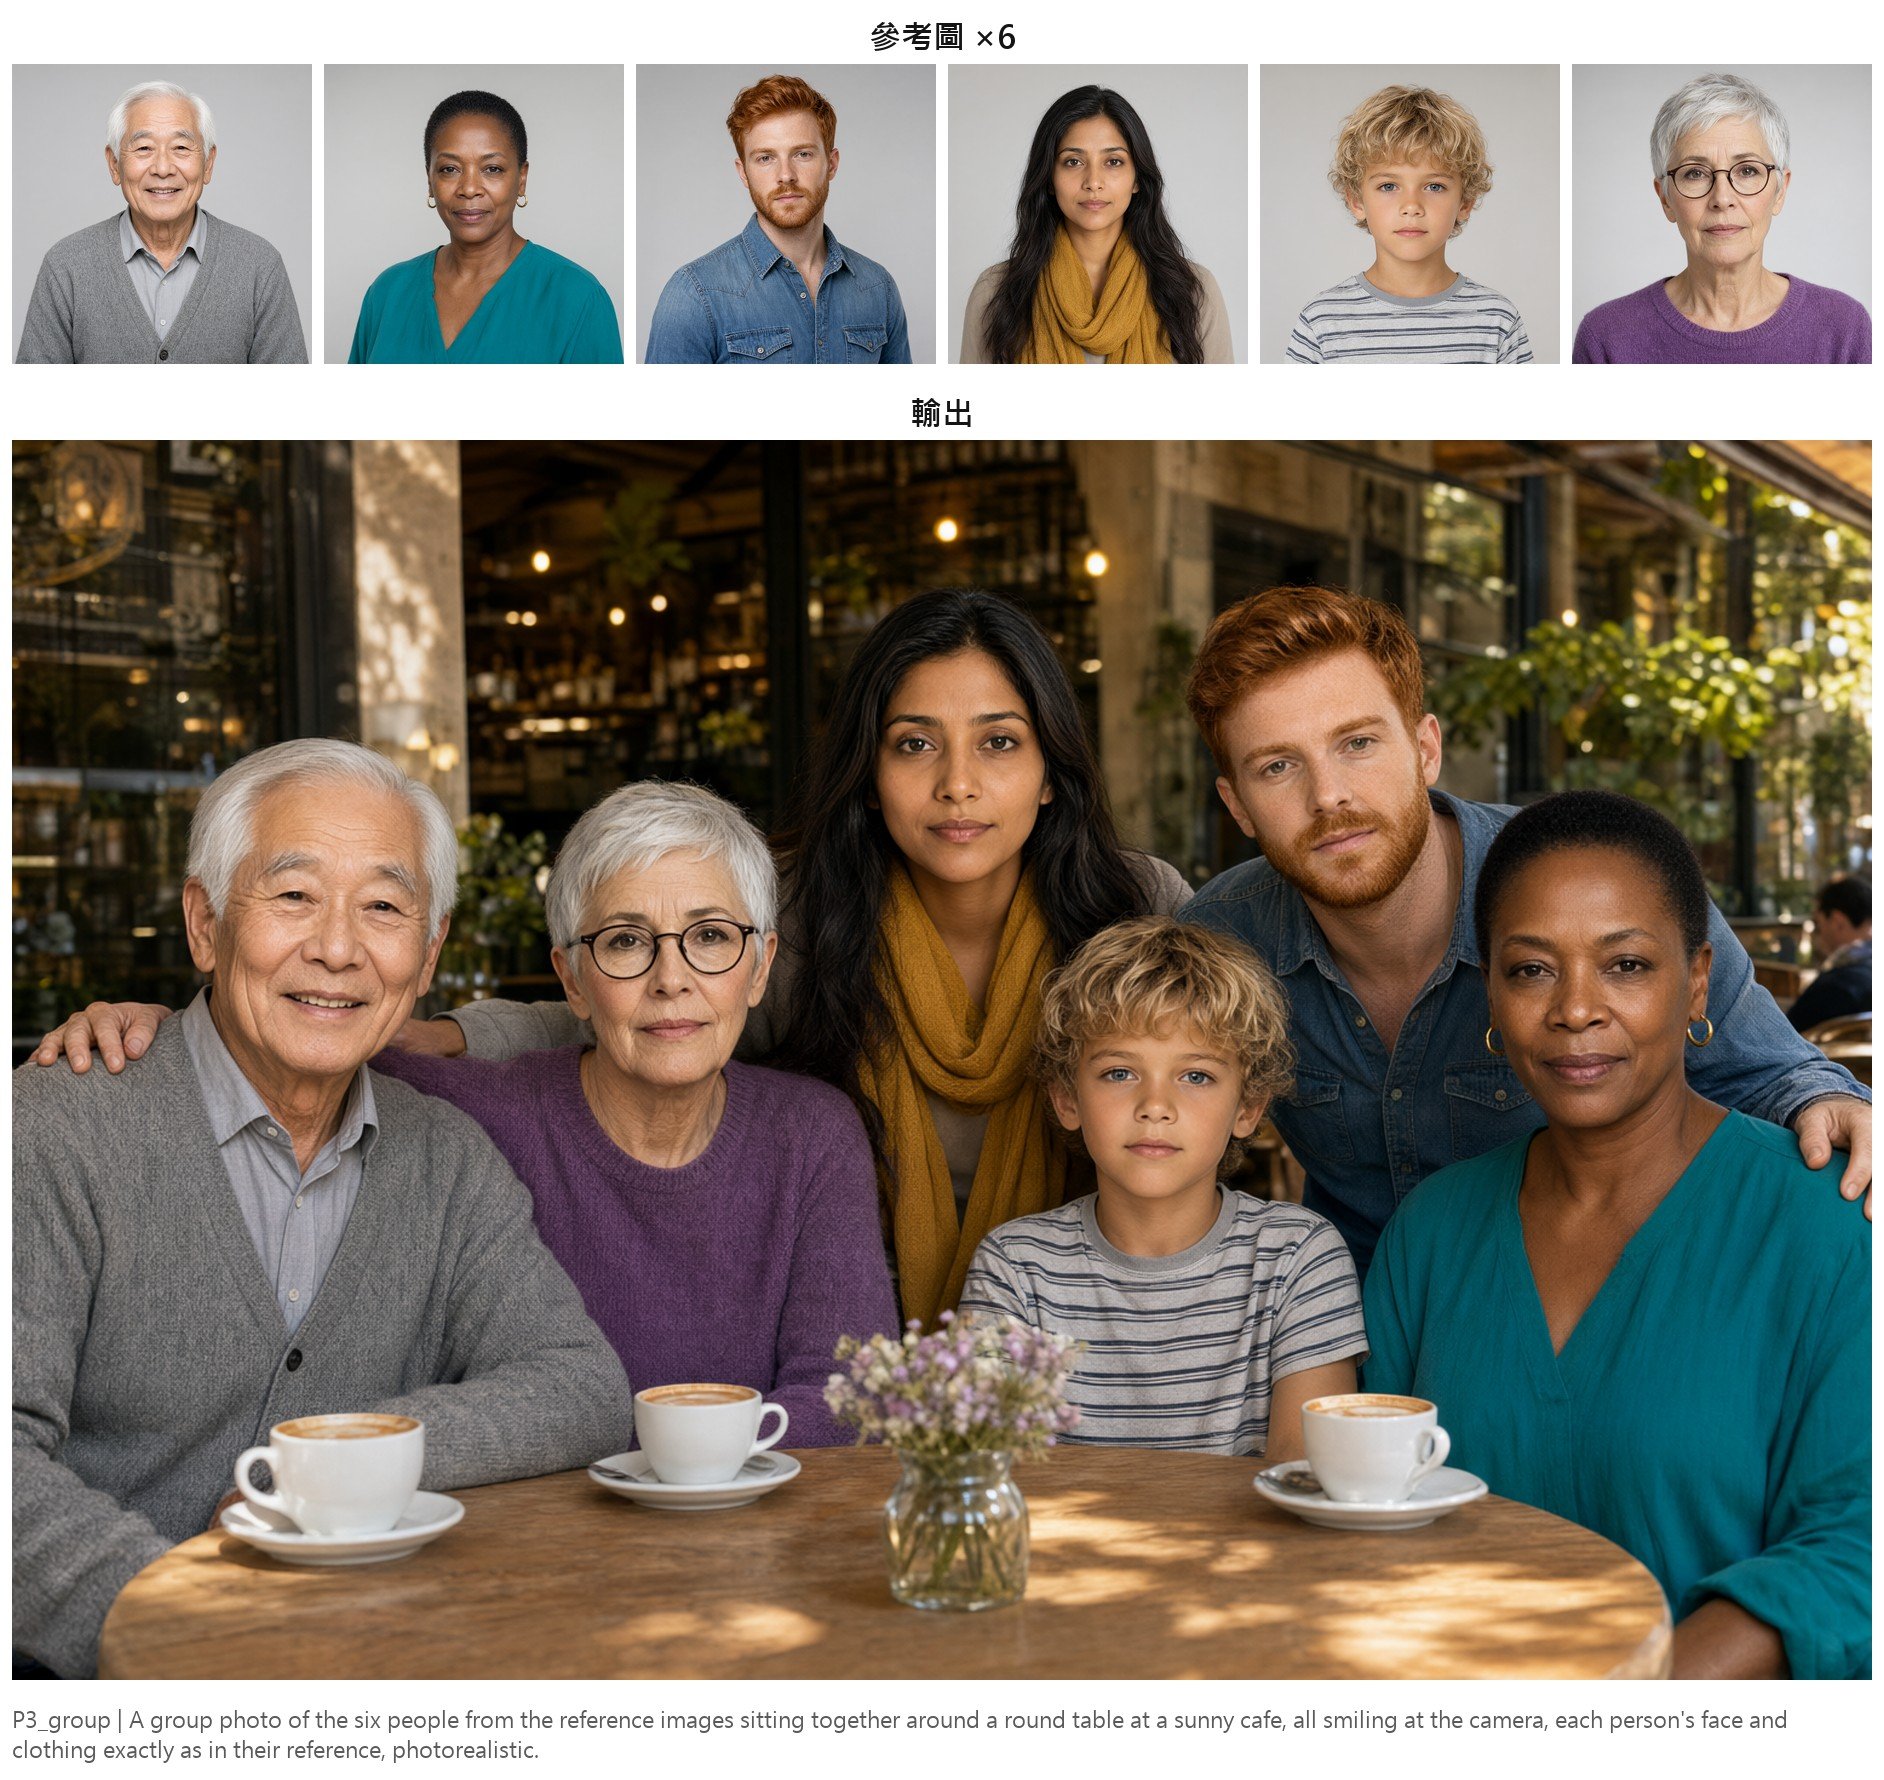
六個人合照:六張個別的肖像合成一張咖啡館合照,六張臉各自對得上、服裝正確,沒有重複的人,也沒有多出來的人。這是針對上一篇重複人物問題特別出的題,通過了。
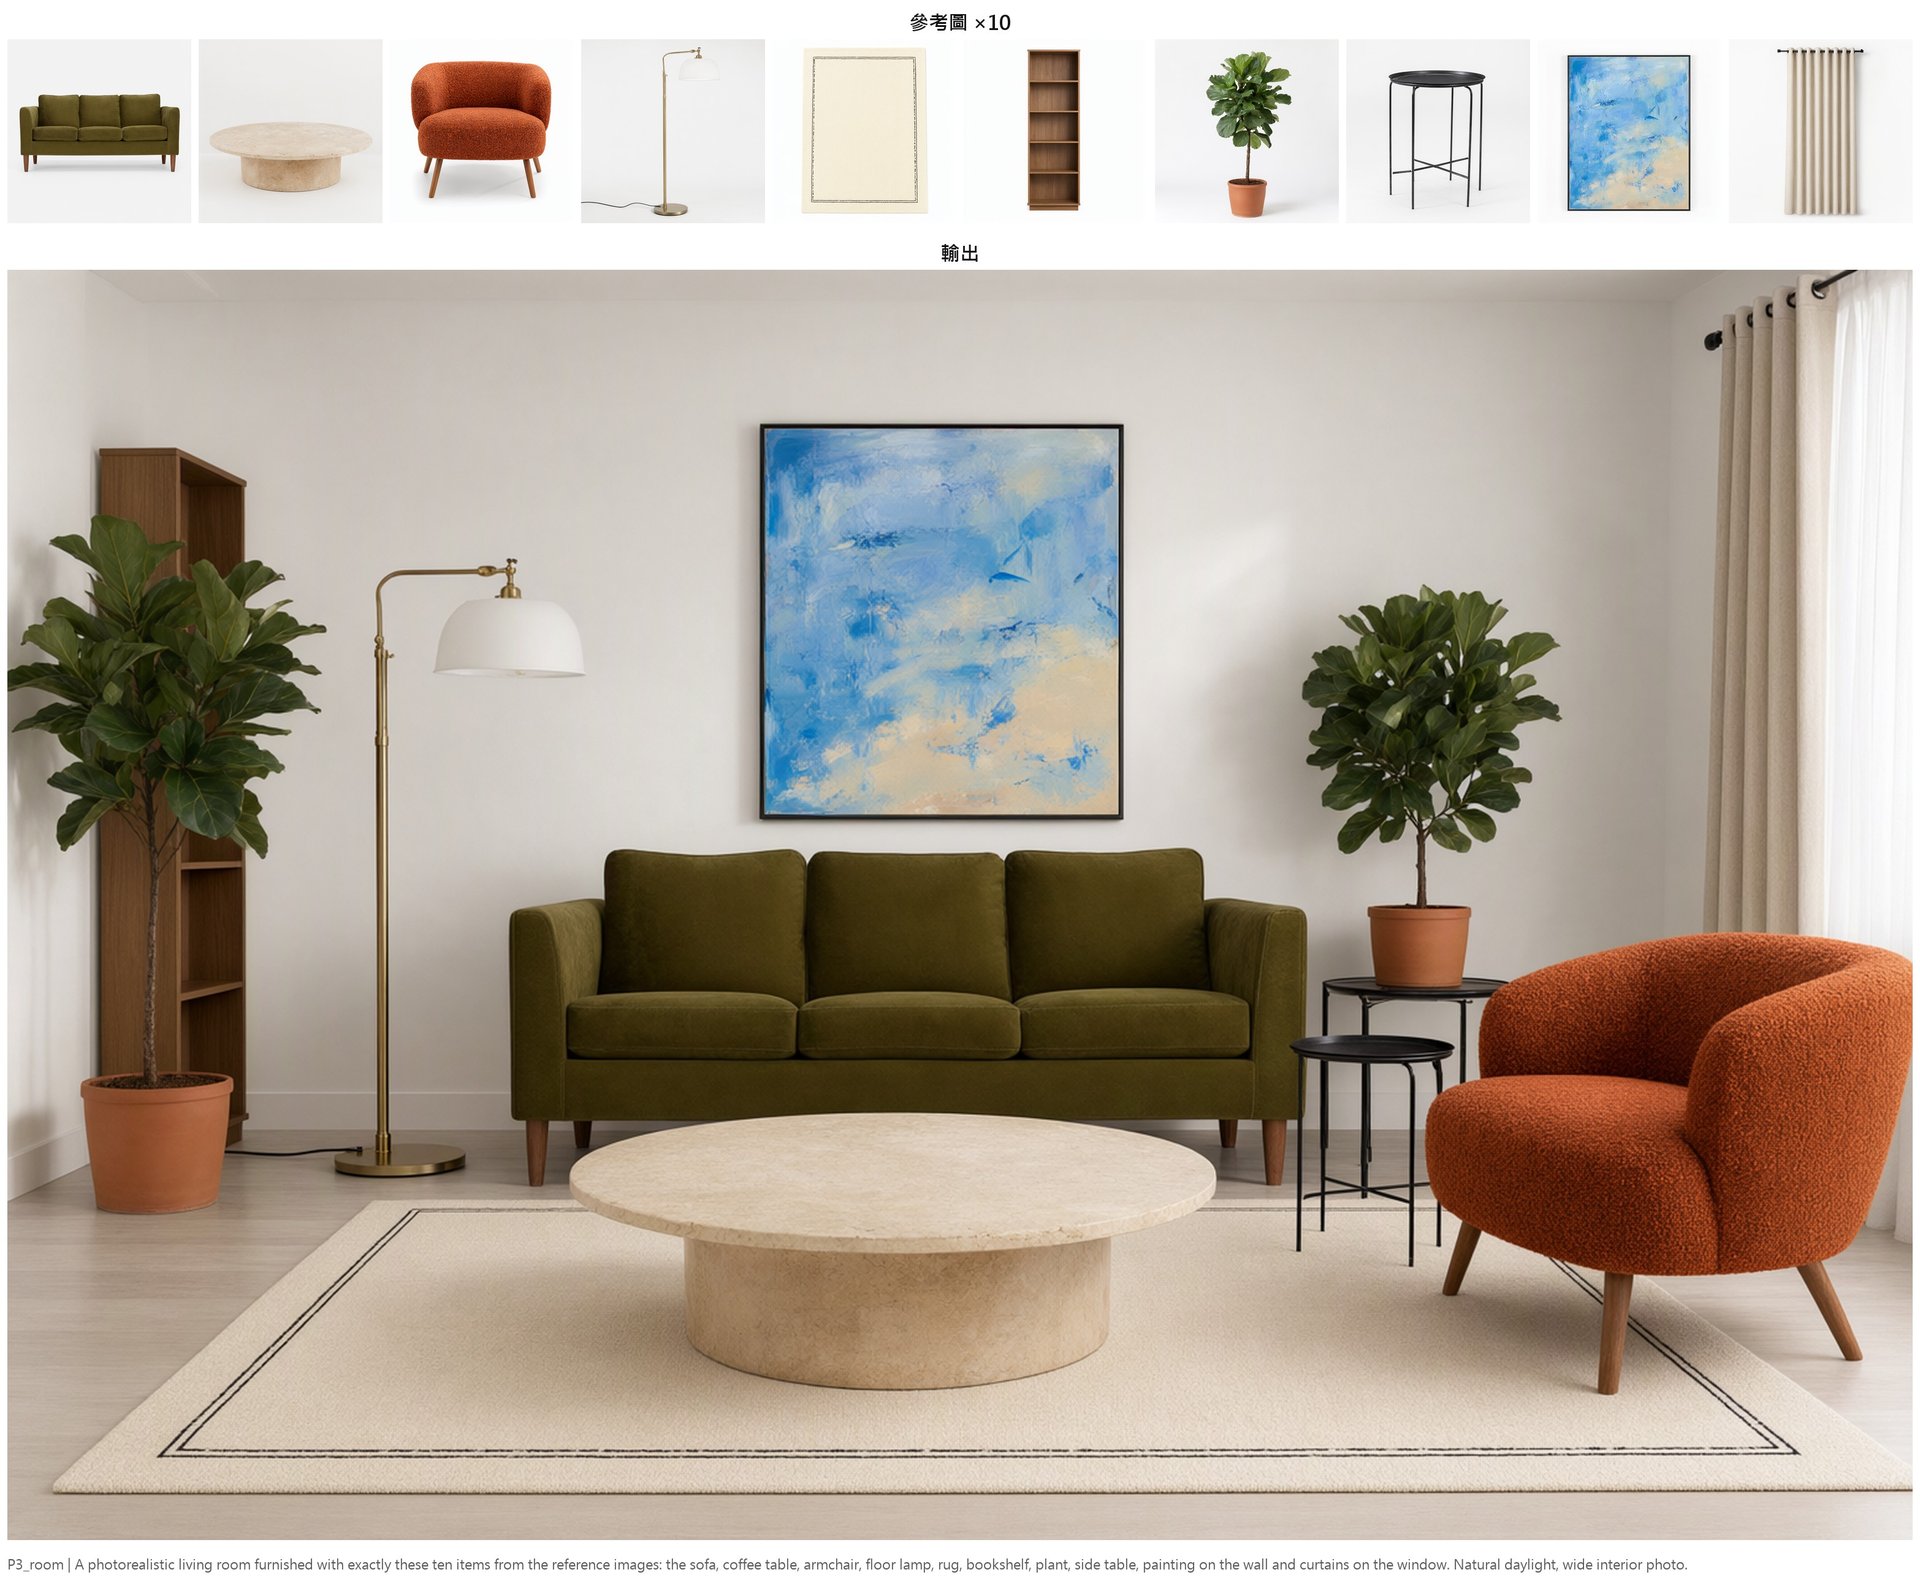
十件家具擺一間房:沙發、圓桌、扶手椅、弧形立燈、地毯、書架、琴葉榕、邊桌、畫、窗簾十張參考圖,十件全部到齊、樣式對、擺法合理。
沒成立的是把一張圖延伸成寬幅全景:給一張正方形的港口照片,要求往左右延伸成寬幅,出來的是同風格的重新構圖,燈塔從左邊搬到中間、建築重新排列,不是把原圖往兩邊接下去。要真正延伸畫布得用其他工具。
四、官方 Prompt Enhancer:18 題全勝
Qwen 另外釋出兩個 Prompt Enhancer 模型,作用是把你寫的 prompt 改寫得更完整。文生圖用的那個把短句改寫成英文長描述,並建議圖片比例;編輯用的那個會先看過參考圖,再把指令改成逐項描述每個物件的樣子。ComfyUI 有社群做的節點可以直接載入。我出 16 題文生圖與 2 題多張參考圖合成,「照原句生」與「先改寫再生」用同一個 seed、同一個 1024×1024,只有 prompt 不同。
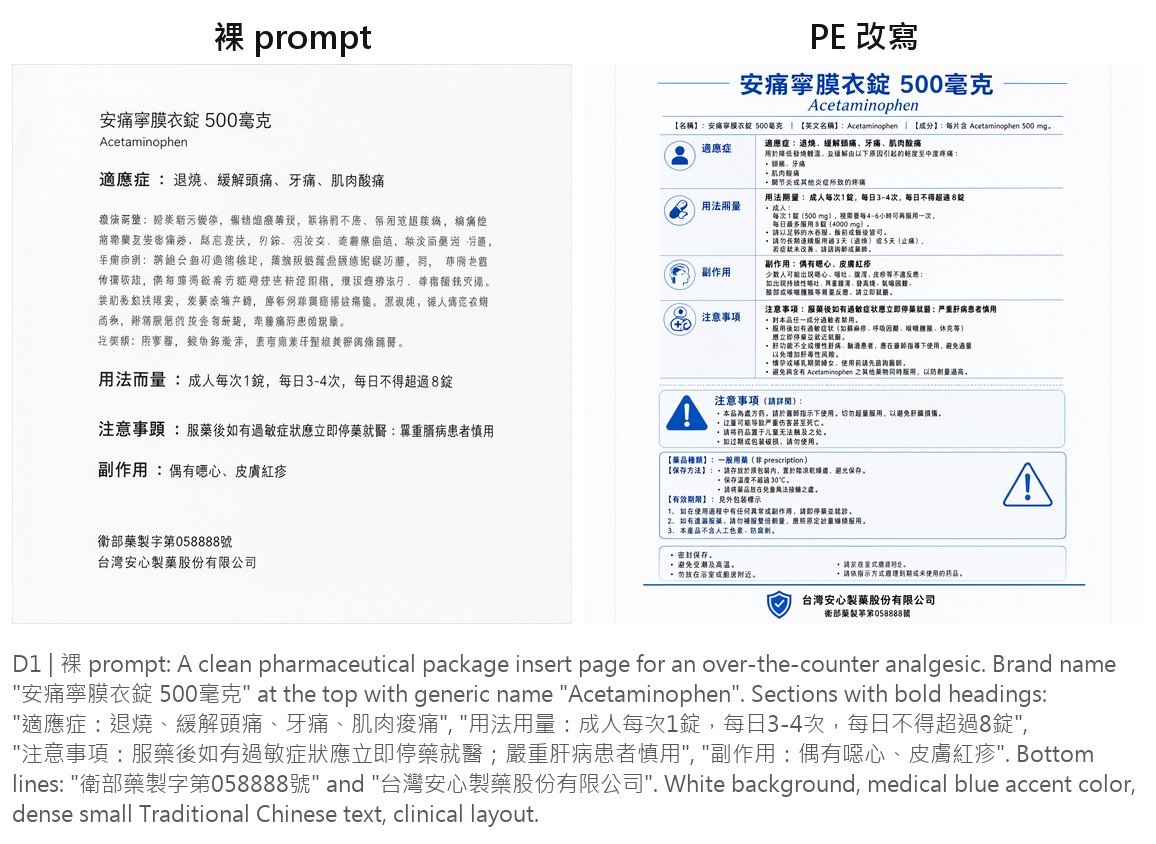
資訊版面的差距最大。成藥仿單照原句生的整段內文是亂碼,改寫後每一句都是可讀的繁體中文,還加了分節圖示與警語框。
咖啡菜單照原句生的有錯字漏字,改寫後五款飲品全對,多了引導點與咖啡壺插畫。珍奶產業報告照原句生的長條圖沒有國名與數值,改寫後補齊了六個出口地與金額。
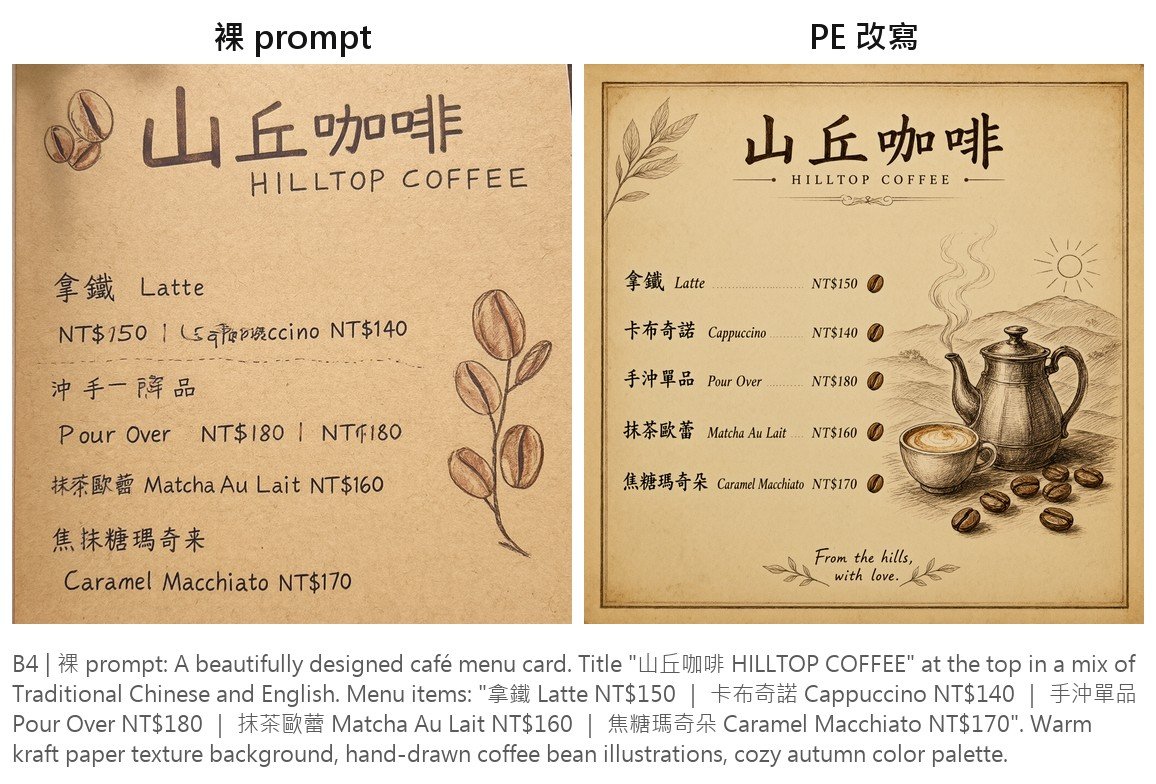
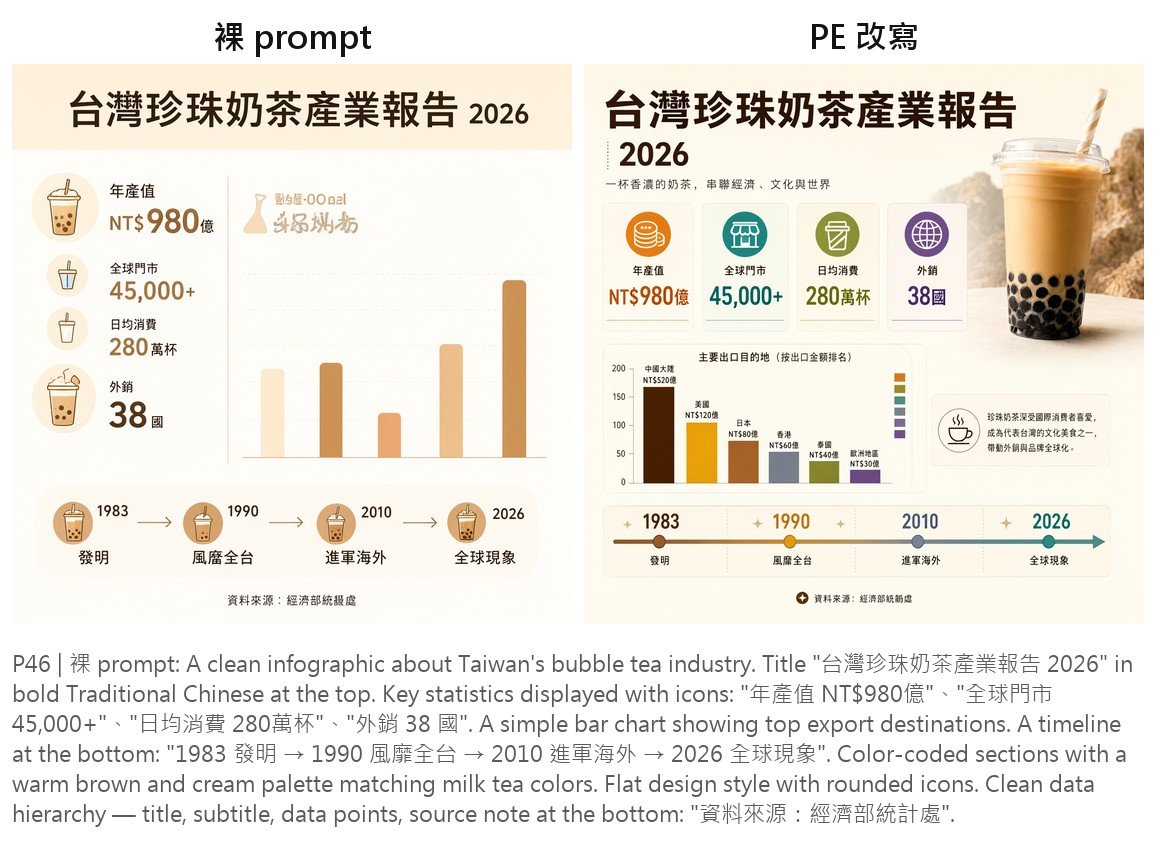
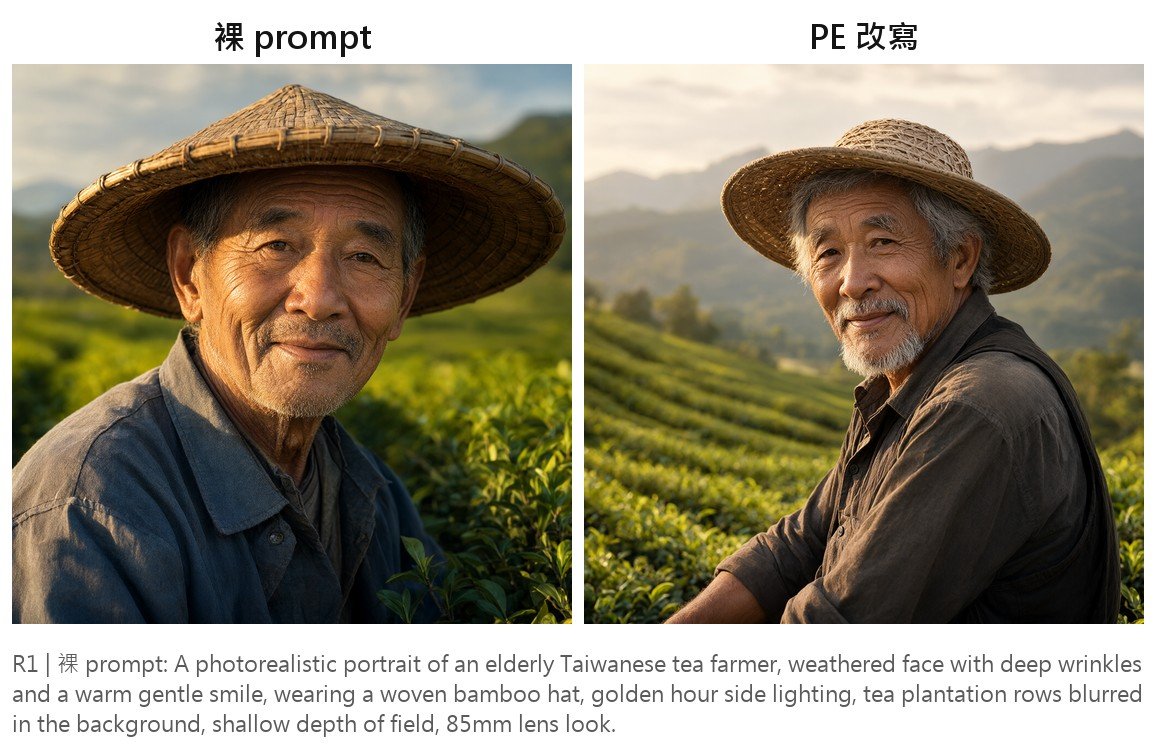
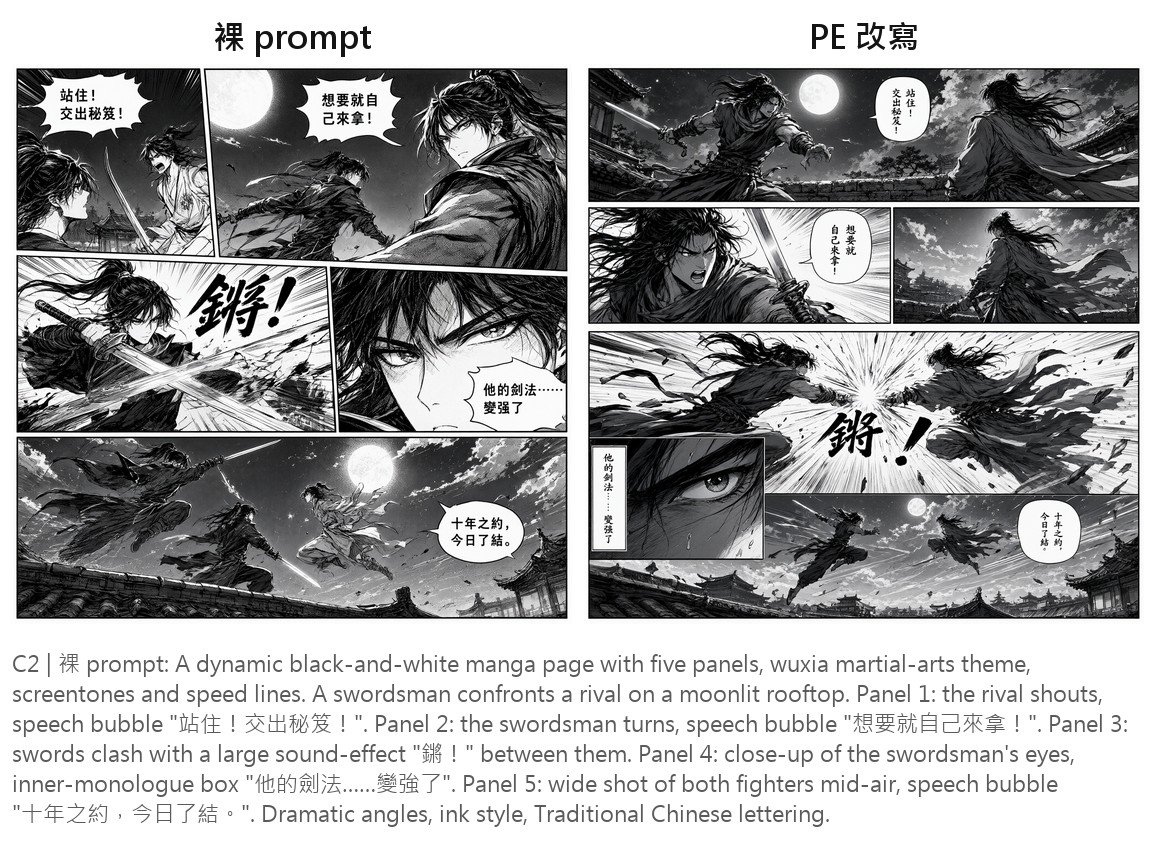
人像與漫畫我原本以為是各有風格,逐張看完後判定還是改寫後的贏:茶農從正面特寫變成側身加茶園的景深,武俠漫畫的分格與動線更完整。
編輯用的那個模型解決了上一篇的重複人物問題。 女孩夜市那題,照原指令會畫出兩個女孩;改寫後的指令把參考圖的外觀逐項寫出來(雀斑、藍灰色眼睛、紅褐色辮子、玳瑁眼鏡、黃色雨衣),出來只有一個女孩,紙袋上還多了「鮮蒸包子」四個字。柯基與馬克杯那題,改寫後比例正常、有接觸桌面的影子、光線一致。
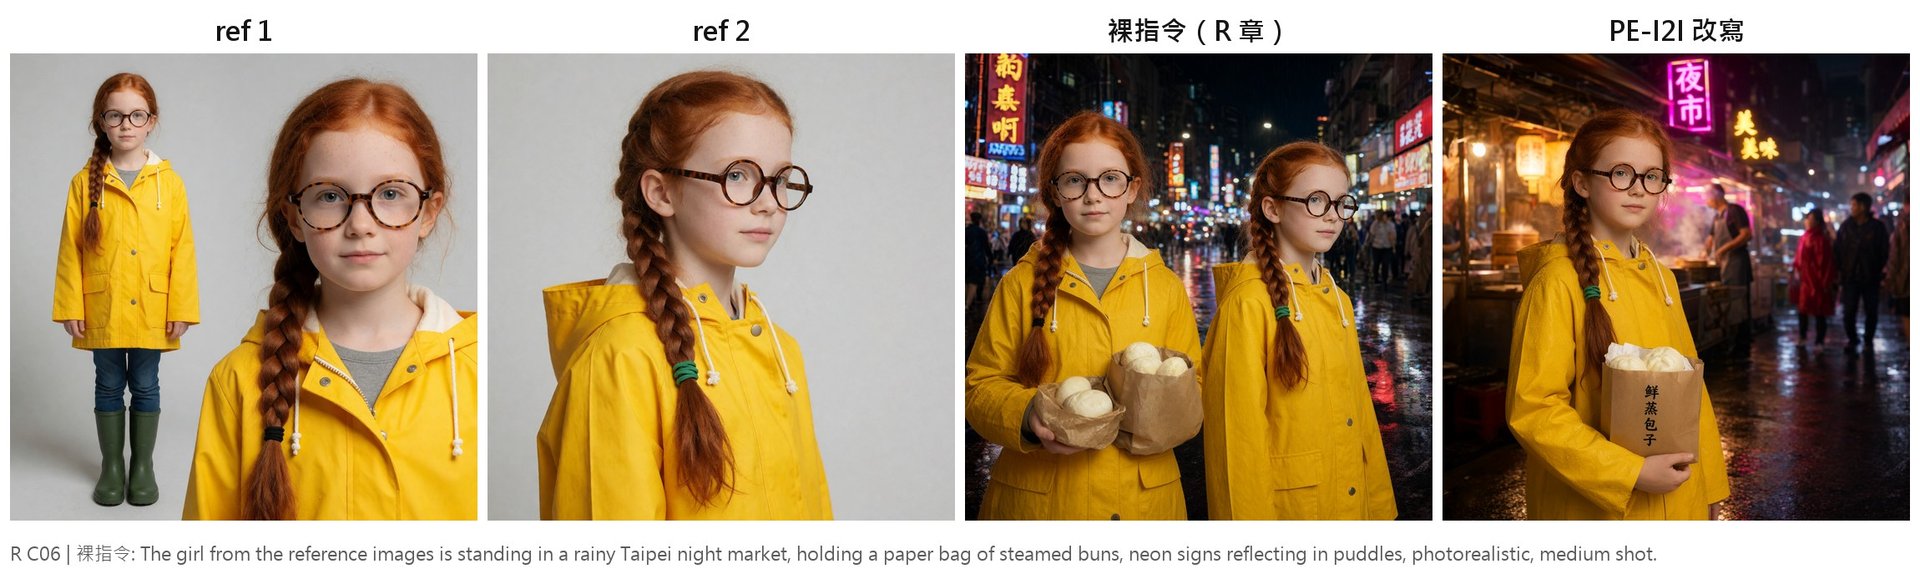
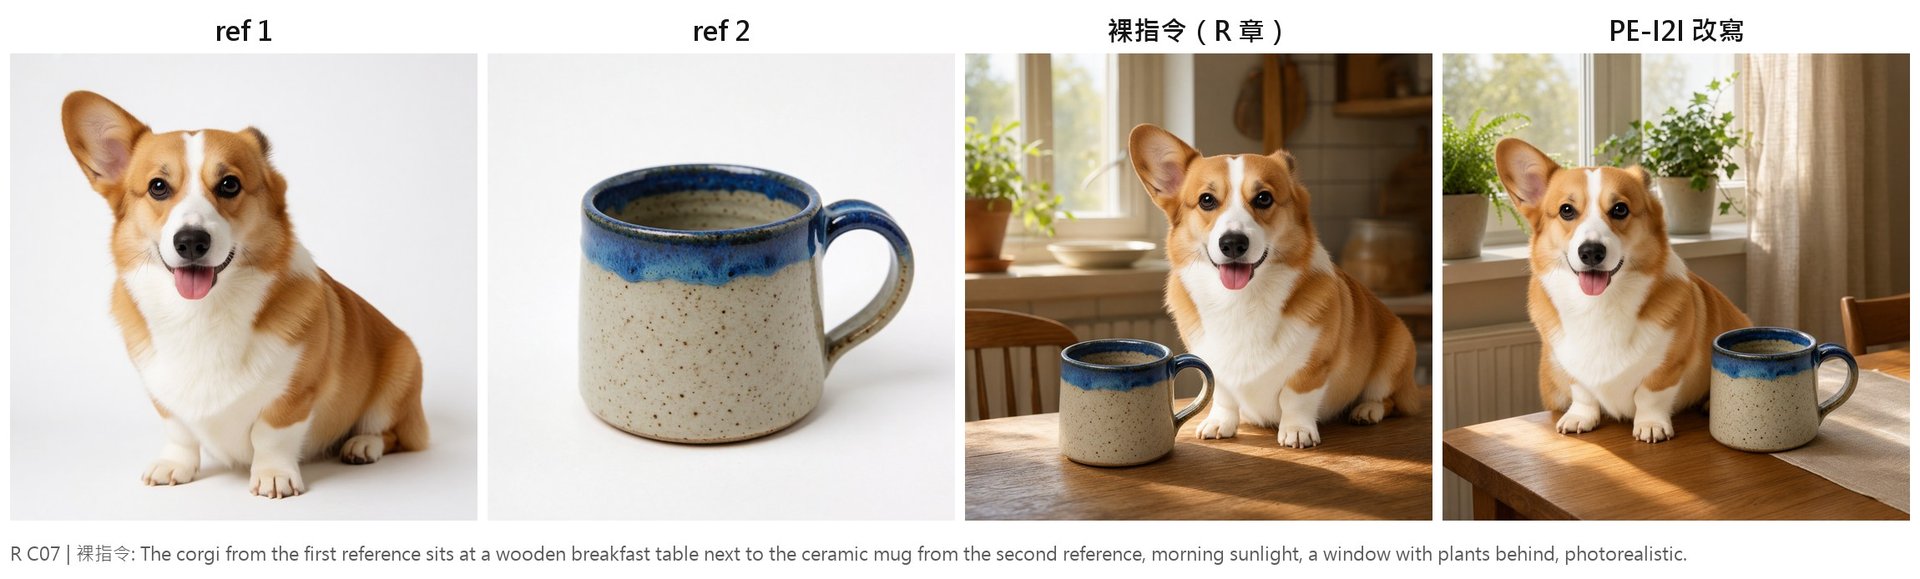
18 題判定改寫後全勝。所以我的用法改成:用 Qwen-Image-2.1 生圖或編輯,一律先過 Prompt Enhancer,人像也不例外。這跟之前測 SenseNova 的結論不同,那次人像是不改寫比較好,兩家改寫模型的習性不一樣。改寫的副作用是會自己加東西(菜單多了咖啡壺、報告多了珍奶照片),不想要得在短句裡先說明。
文生圖用的改寫模型會給比例建議,配合上一篇的 2K 官方尺寸表直接用;編輯用的那個另外會告訴你輸出該跟哪張參考圖的比例。
該怎麼用
| 需求 | 做法 |
| 已經是透明背景的貼紙、圖示要改字或改表情 | 直接當參考圖編輯,指令結尾寫 keep the transparent background exactly the same |
| 把照片裡的人物去背成透明圖層 | 指令用 Extract the main subject as a transparent RGBA layer;髮絲、動漫可用,背景雜亂的人像仍用 BiRefNet |
| 一張圖同時改多個地方 | 用文字列出每個要改的東西,加一句「其他保持不變」,不用畫圈 |
| 角色設定圖、分鏡、穿搭、合照、擺房 | 多張參考圖合成,參考圖依序對應 image1、image2;指令先過編輯用的 Prompt Enhancer |
| 任何文生圖 | 短句先過 Prompt Enhancer 再生,它會給比例建議 |
| 延伸畫布 | 不是它的強項,換專門的 outpainting 工具 |
想自己跑:ComfyUI 設定
模型與基本設定跟上一篇相同,這篇多兩個檔案:
| 檔案 | 下載 | 放置位置 |
| qwen3.5_9b_qwen_image_2.1_pe_t2i.int8_convrot.safetensors(文生圖用的改寫模型,約 9.5GB) | Hugging Face Comfy-Org/Qwen-Image-2.1 | models/text_encoders/ |
| qwen3.5_9b_qwen_image_2.1_pe_i2i.int8_convrot.safetensors(編輯用的改寫模型,約 9.5GB) | 同上 | models/text_encoders/ |
- 改寫節點用社群的 ComfyUI-Qwen-Image-2.1-Prompt-Enhancer,用內建的 Load CLIP 節點載入改寫模型(type 選 qwen_image),把它輸出的 positive_prompt 接進 TextEncodeQwenImage21 的 prompt。文生圖用的 presence_penalty 設 1.5,編輯用的設 0,作者 README 特別強調
- 改寫模型與生圖模型是前後兩步,ComfyUI 會自動換載,VRAM 充足的電腦兩個同時留在記憶體裡也沒問題
- 透明圖層當輸入時,Load Image 會把透明通道拆到 mask 輸出,要用 Join Image with Alpha 接回去,編碼節點才吃得到四通道
- 透明相關的兩個場景不要過改寫模型,它會把「RGBA、transparent」這些字改掉
- 改寫模型偶爾會在英文裡混進一小段中文,看到就換 seed 重跑
授權是 Qwen Research License,非商用,改寫模型同樣適用。
相關文章
- Qwen-Image-2.1 實測:透明輸出、多參考編輯、原生 2K — 本文的上一篇,模型下載與基本設定在那裡
- 用 Qwen-Image-2.1 直出透明貼圖:一張頭像、一段 prompt,九張 LINE 貼圖 — 透明輸出的實際應用
- SenseNova U1.5 照原句生對先改寫再生的實測 — 另一家改寫模型的測法與不同的結論
- HiDream-O1 實測 — 本文畫圈編輯與多張參考圖合成的對照模型之一
- ComfyUI 去背怎麼選 — 去背那題對照的專門去背模型