為什麼要測這個模型
Black Forest Labs(做 Flux 系列的公司)在 10 月 15 日開源了 FLUX 3 Image Klein,以下簡稱 Klein 3。它是一個 5.6B 參數的模型,文生圖、圖片編輯、多張參考圖合成都用同一個模型做,另外有一個新功能:在畫面上畫框,指定某樣東西要放在哪裡,或只改框裡面的東西。
官方的說法很有自信:文生圖、編輯、多參考三項在內部評測都排第一,比上一代 Klein 9B 的文生圖高 91 分、編輯高 70 分(他們用的是兩兩對比的 Elo 分數),而且參數少了 38%。
這些是官方自己測的。我的做法跟前幾篇一樣:拿之前做過的評比題目,同一句 prompt、同一個隨機種子補跑 Klein 3,放進原本的對照表裡一起看。 好壞由我自己逐張判斷。
快速結論
- 物件移除是它最強的地方:只給一句「把某某拿掉」,21 題成功 20 題,比之前最好的 Qwen-Image-2.1 加 Prompt Enhancer(19 題)和上一代 Klein 9B(18 題)都好,地毯上那堆零散的玩具也拿得乾乾淨淨
- 框選功能好用:9 題成功 7 題。用框排版的 5 題全部成功;照片裡有兩個相似的人時,畫框能準確指定改哪一個。要注意框要貼齊物件,框畫多大,它就把東西畫多大
- 一般文生圖跟 Qwen-Image-2.1、Krea2 同一級:35 題 5 勝 28 平 2 輸,略勝一點
- 指令遵循跟上一代 Klein 9B 差不多:12 題 1 勝 10 平 1 輸,官方說的大幅進步在這組題目上看不出來
- 繁體中文不能用:53 題 1 勝 6 平 46 輸,幾乎每題都有錯字,小字會糊
- 換頭、換臉不建議:各 24 題都輸了 21 題,換上去的頭像貼紙一樣、比原圖亮,表情和角度也不會跟著原圖
- 官方說的「沒改的地方完全不動」在開源版本上看不出來:它沒被要求改的區域,平均改動比其他編輯模型還多
測試方法
這次比了七項,除了框選是新出的題目,其他都是之前評比的現成題目,對手的圖都是當時生成的。
| 項目 | 題數 | 跟誰比 | Klein 3 的結果 |
|---|---|---|---|
| 物件移除 | 21 | Qwen-Image-2.1+Prompt Enhancer、Klein 9B、Qwen-Image-Edit-2511 | 成功 20 |
| 框選排版與局部修改 | 9 | 同一題不畫框、改用文字寫位置 | 成功 7 |
| 一般文生圖 | 35 | Qwen-Image-2.1、Krea2 Turbo | 5 勝 28 平 2 輸 |
| 指令遵循(數量、顏色、位置) | 12 | Klein 9B | 1 勝 10 平 1 輸 |
| 英文長段文字 | 6 | Z-Image Turbo、Qwen-Image 2512 等 | 0 勝 4 平 2 輸 |
| 繁體中文 | 53 | Qwen-Image-2.1、SenseNova U1.5 | 1 勝 6 平 46 輸 |
| 換頭、換臉 | 各 24 | Qwen-Image-2.1+換頭 LoRA、InstantID、PuLID-Flux | 0 勝 3 平 21 輸、2 勝 1 平 21 輸 |
用的是哪個版本:官方釋出兩種模型——給人微調用的完整版(50 步),和給一般使用的蒸餾版(16 步)。這次全部用蒸餾版。每種模型又有原始精度(bf16)、壓縮過的 int8、以及只有新款 NVIDIA 顯示卡才能加速的 nvfp4 三種檔案。我先拿同一批題目比了四種「生成器+文字編碼器」的組合:
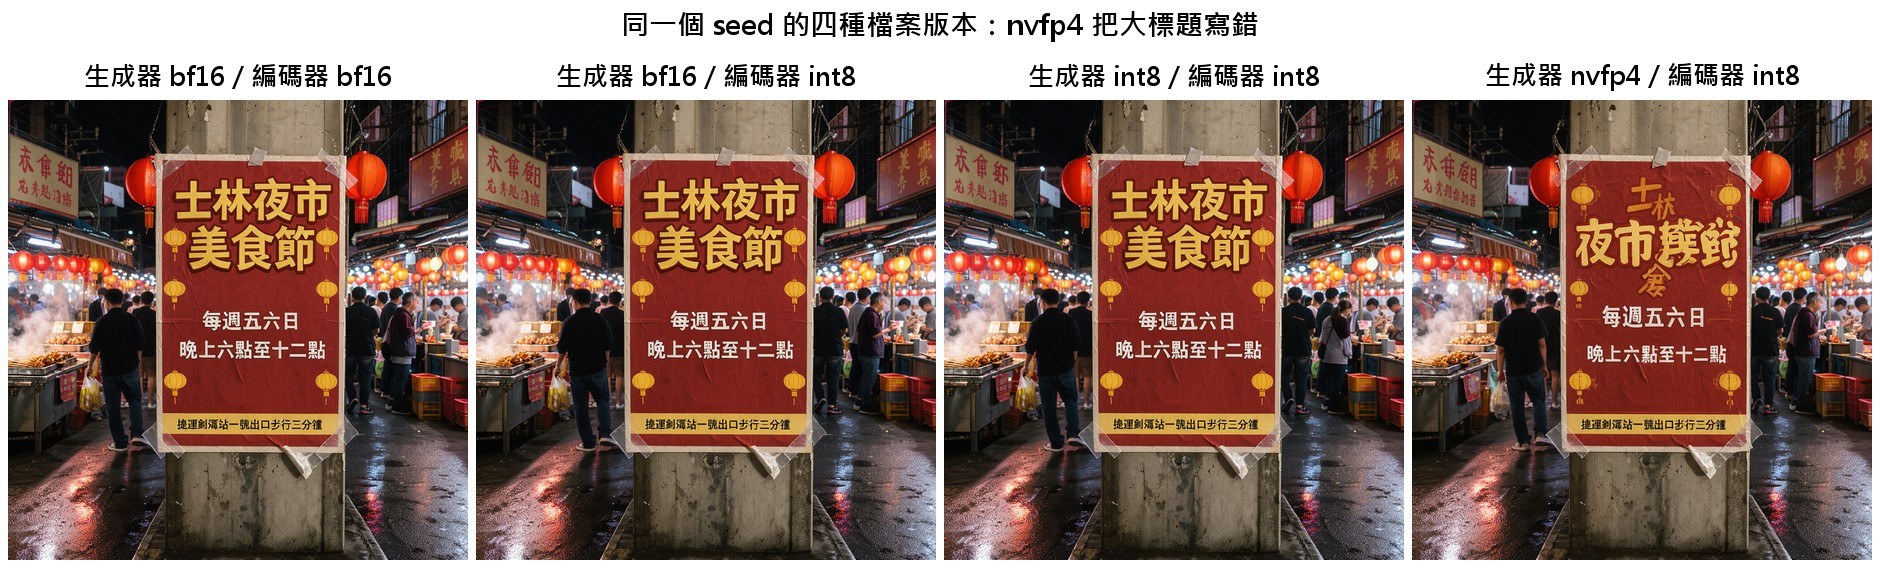
bf16 和 int8 生出來的圖幾乎一樣,看不出好壞;nvfp4 把海報大標題「士林夜市美食節」寫成了別的字。所以後面全部用 生成器和文字編碼器都是 int8 的版本,佔用的顯示記憶體大約是原始版本的一半,速度也比較快。
官方附了一個 prompt 擴寫模型:它是另一個 9B 的語言模型,會把你打的一句短描述擴寫成 100 到 350 字的完整英文描述,再交給 Klein 3 生成。官方說明裡直接寫「不要在沒有擴寫的情況下使用這個模型」,所以文生圖的題目我都照官方範本接上它。編輯題(物件移除、換頭換臉)則不擴寫,用跟其他模型一模一樣的原句,這樣比較公平。
幾個要誠實揭露的地方:測試圖都是 AI 生成的;每題只跑一次,用同一個隨機種子(seed,決定畫面初始雜訊的一個數字,換一個數字結果就會不同);文生圖題 Klein 3 有接擴寫模型,對手大多是照原句生成的,這對 Klein 3 比較有利;成功或勝負都是我一張一張看的,屬於主觀判斷。
一、物件移除:目前測過最好的一個
物件移除的做法跟上一篇物件移除評比一樣:不畫遮罩,只給一句「把某某拿掉,用周圍的背景自然補上,其他地方完全不變」,模型自己找出要拿掉的東西。
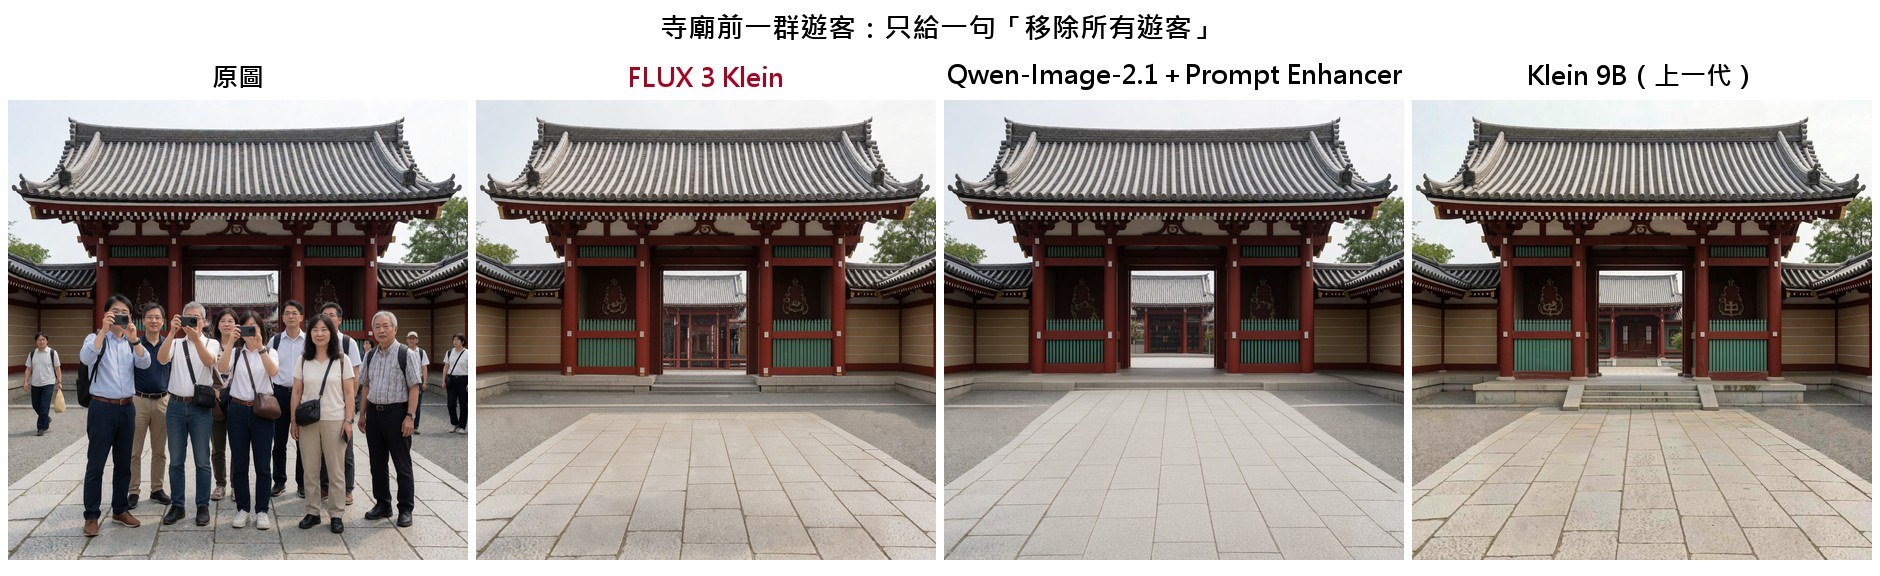
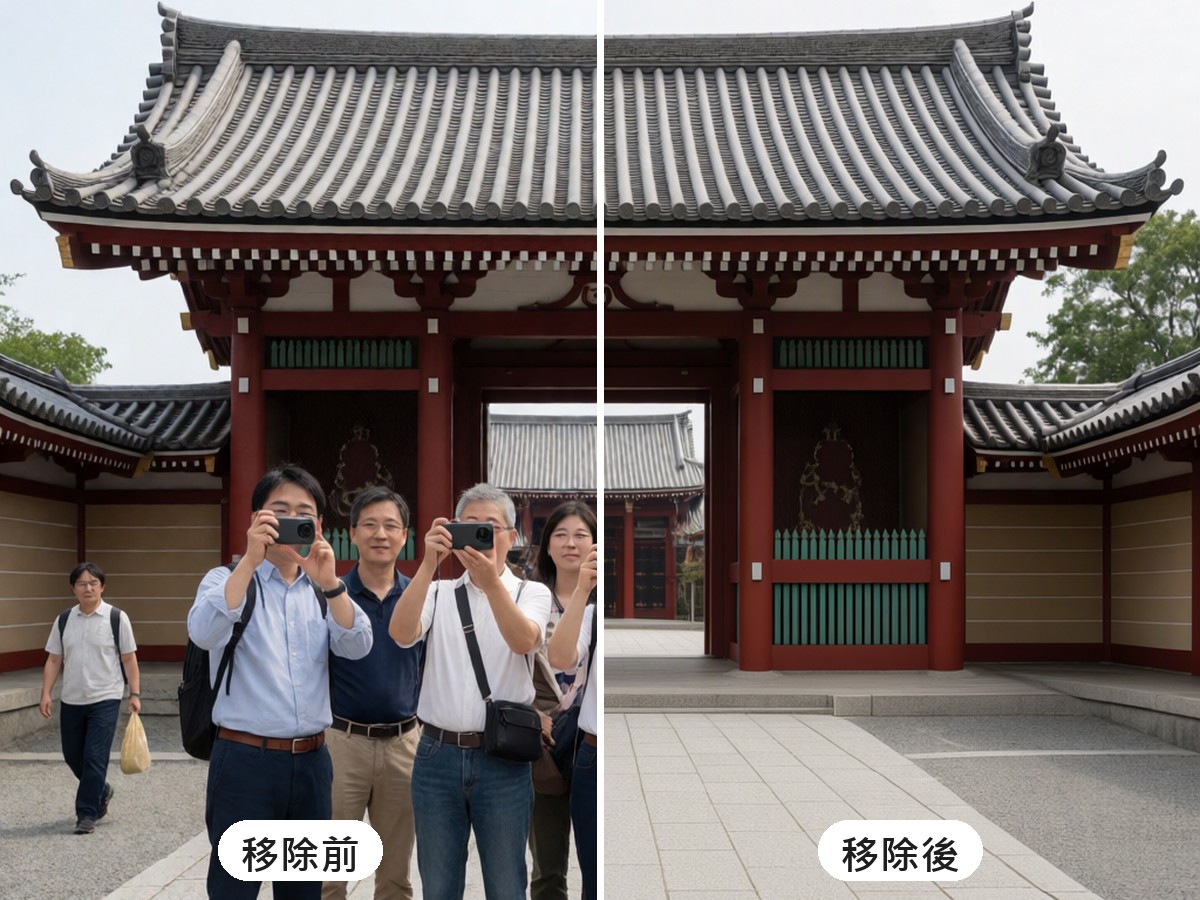
寺廟前十幾位遊客擋住大半個畫面,Klein 3 把人全部拿掉,補出一條延伸到大門的石板路,透視也對。
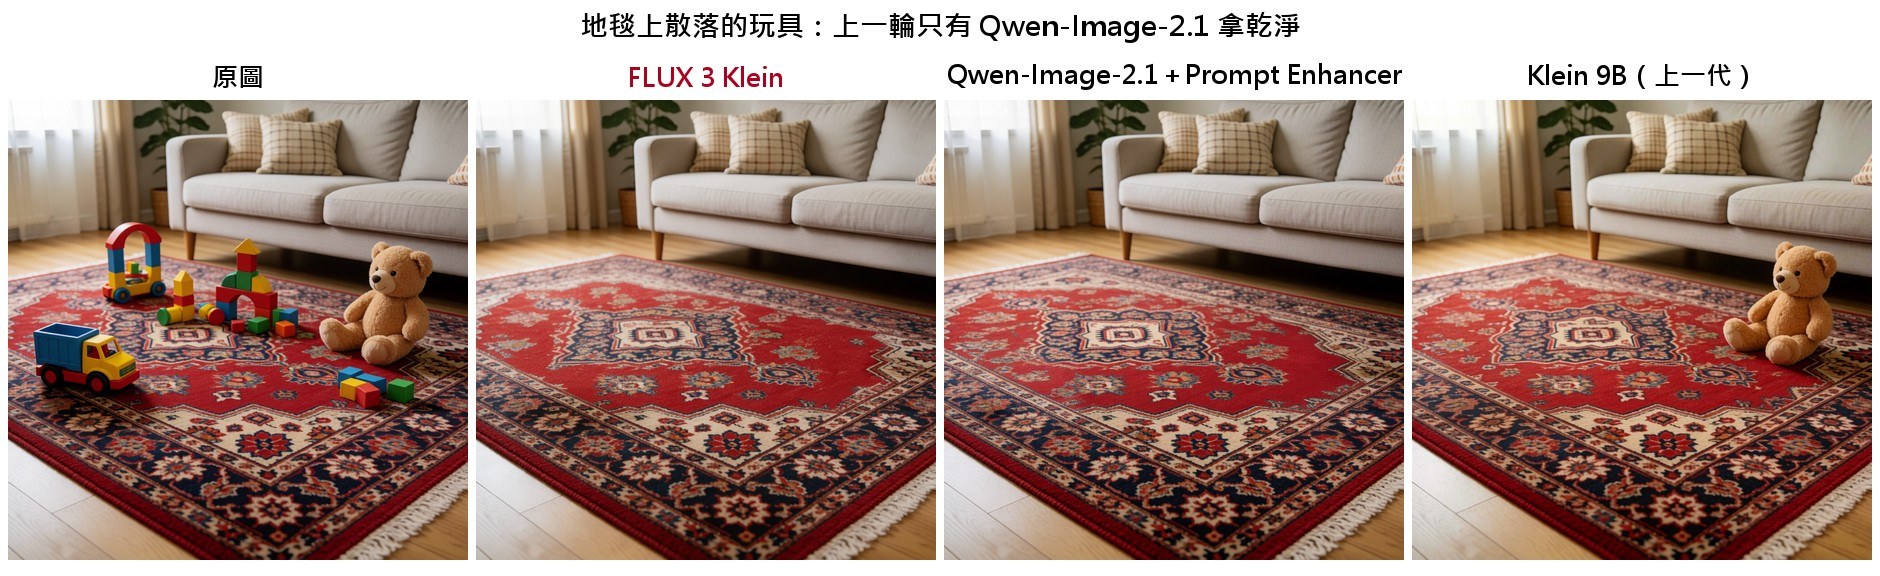
這題是上一輪最難的一題:地毯上散著玩具卡車、積木和泰迪熊,當時只有 Qwen-Image-2.1 加 Prompt Enhancer 全部拿乾淨,上一代 Klein 9B 留下了泰迪熊。Klein 3 一句話就全部拿乾淨,地毯花紋也接得很自然,而且不需要另外跑一個改寫指令的模型。
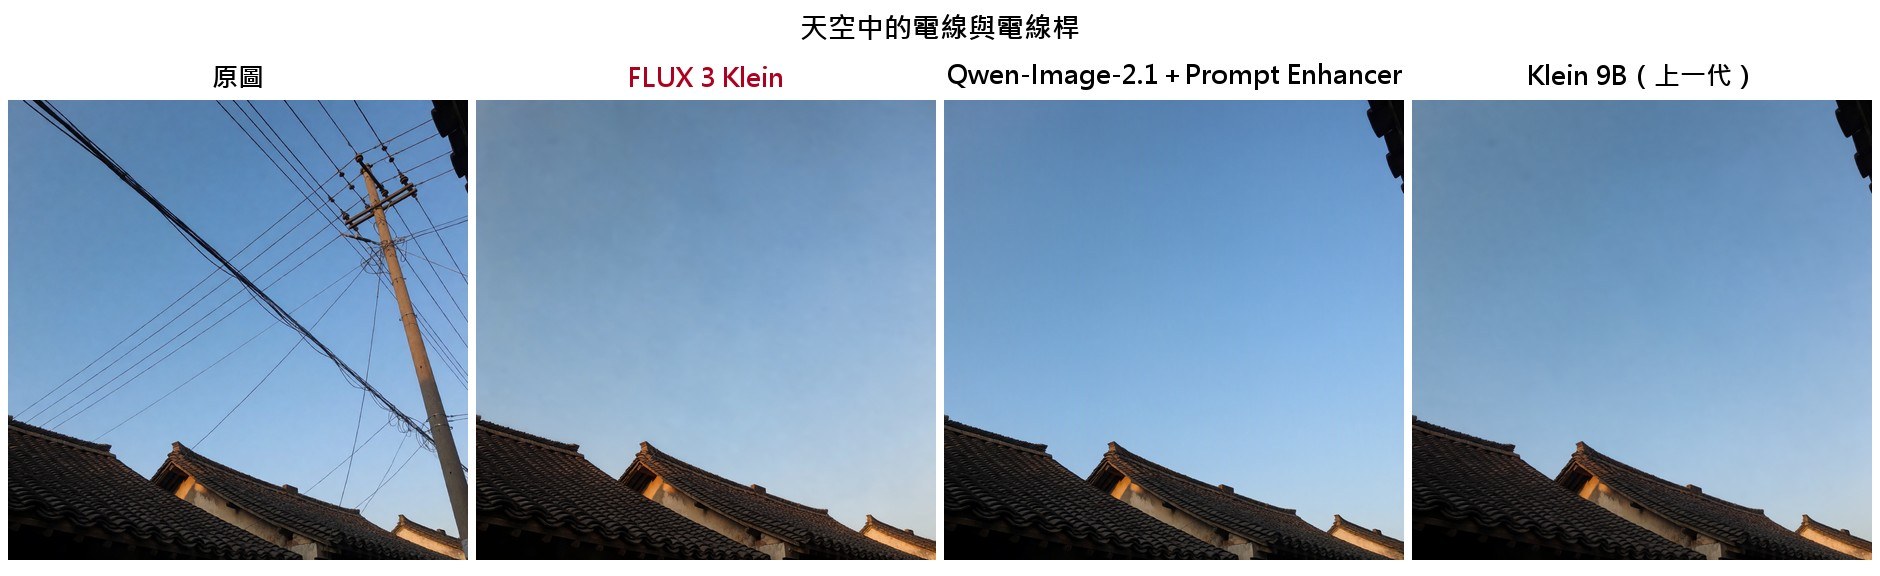
細長的電線也處理得很乾淨,天空沒有留下殘段。
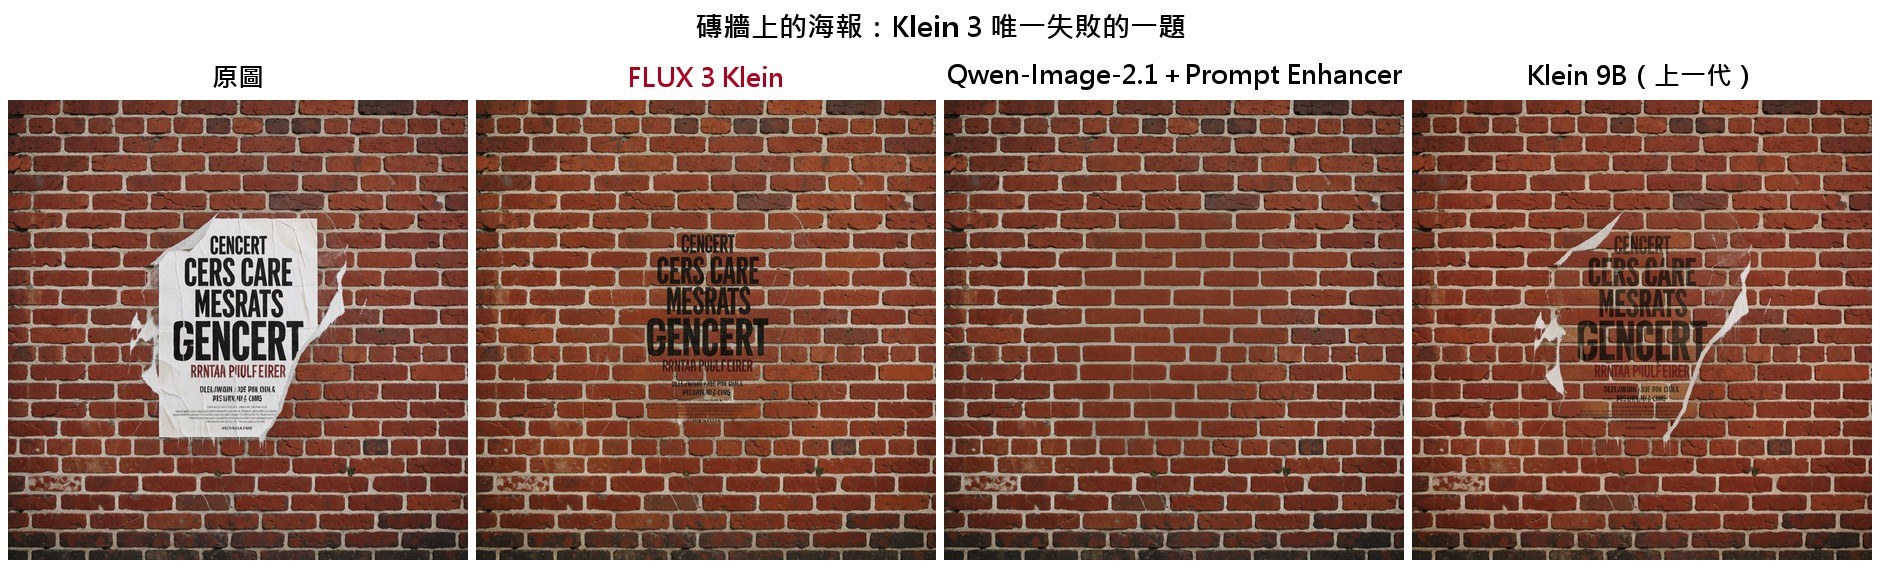
21 題裡唯一失敗的是磚牆上的海報:Klein 3 把海報的紙拿掉了,但字還半透明地留在牆上,跟上一代 Klein 9B 一樣。這題只有 Qwen 系列的模型補出了乾淨的磚牆。
沒被要求改的地方,其實也被動到了。 編輯模型拿掉一個東西時,其實是把整張圖重新畫一次。我計算了「遮罩以外、照理不該被動到的區域」平均每個點的顏色差(0 到 255,0 代表完全沒動):Klein 3 是 6.6,Qwen-Image-Edit-2511 是 3.6、Qwen-Image-2.1 加 Prompt Enhancer 是 5.0、Klein 9B 是 6.0。肉眼大多看不出來,但如果你需要沒改的地方一個像素都不變,Klein 3 不是最好的選擇。官方說的「像素級編輯」,在他們的線上服務有一個專門還原未編輯區域的選項,開源版本沒有。
二、框選:指定東西放哪裡、改哪一個
這是 Klein 3 新出的功能。在 ComfyUI 裡用 Create Bounding Boxes 節點在畫布上畫框,每個框寫一句描述;prompt 裡用 <obj_1>、<obj_2> 指到對應的框;最後由 FLUX.3 Layout Prompt 節點把每個框的座標整理成一個表格,接在 prompt 後面一起送進模型。
我出了 9 題:5 題是文生圖排版,4 題是拿現成照片、框住一樣東西只改它。每題同一個隨機種子另外跑一張不畫框、把位置用文字寫出來的版本當對照。結果 9 題成功 7 題,排版 5 題全部成功。
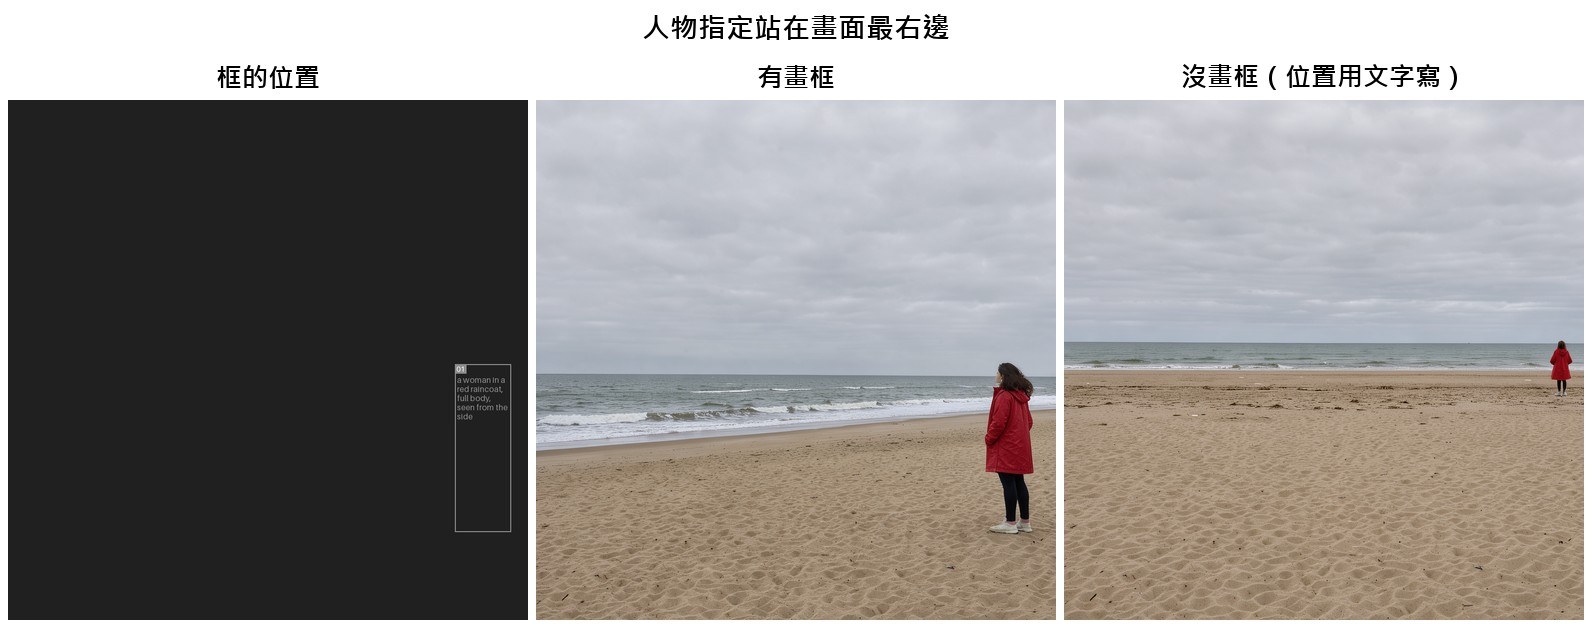
框最有用的地方是比較極端的位置和大小。叫它「把人放在最右邊」,沒畫框的版本把人縮成邊緣一個小點;畫了框,人就照框的大小站在右邊。
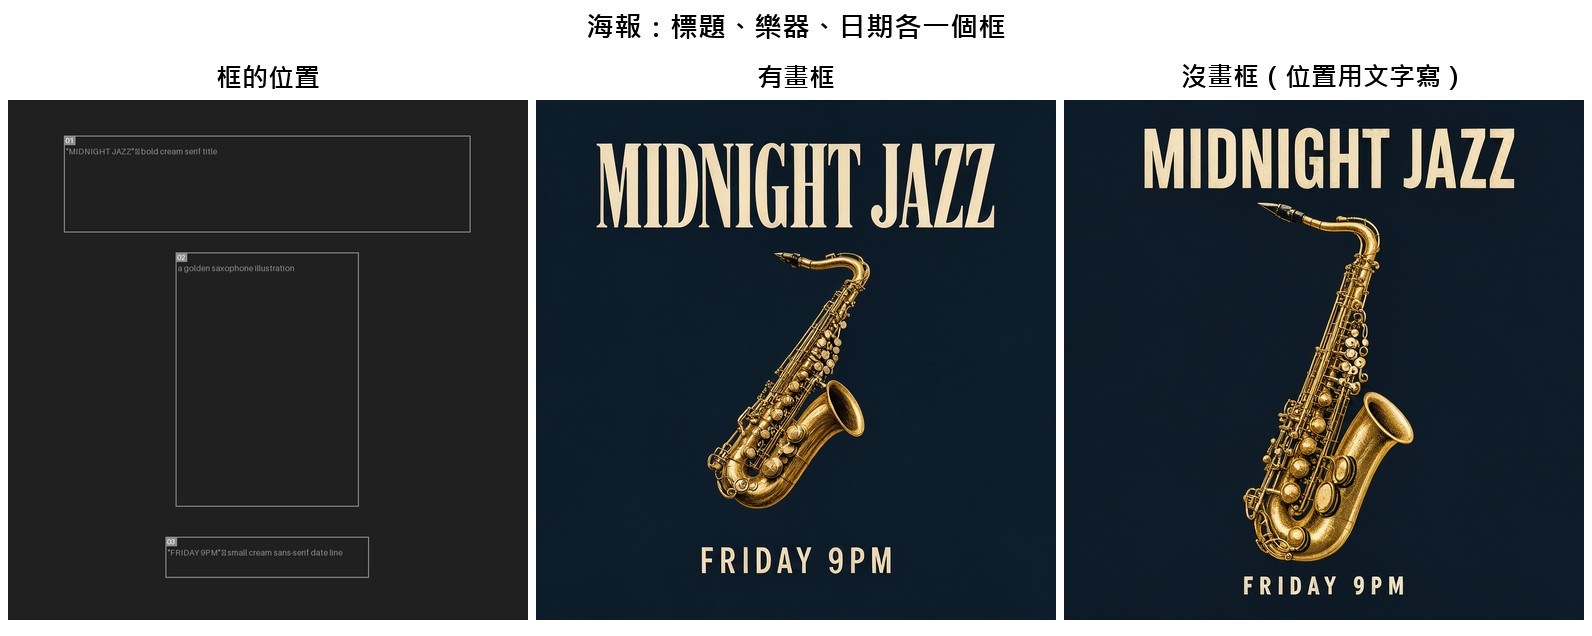
一般的排版,有沒有畫框差別不大:標題、樂器、日期都落在各自的框裡,但用文字寫「標題在上、樂器在中間、日期在下」也一樣排得出來。
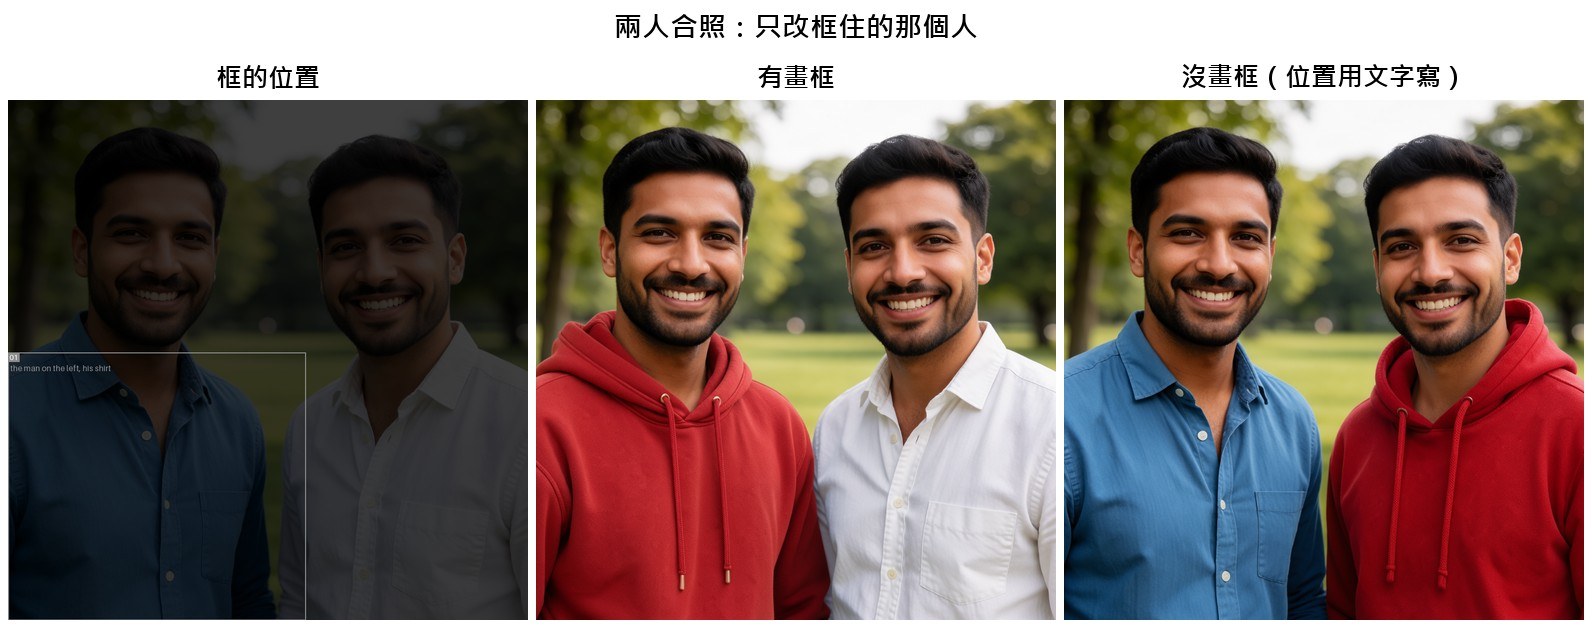
修改照片時,框最大的用處是指定改哪一個。兩個穿著相似的人,我要把左邊那位的襯衫改成紅色連帽衫:畫了框,改的正是框住的那一位;沒畫框、只寫「其中一個人」,它改到了右邊那位。
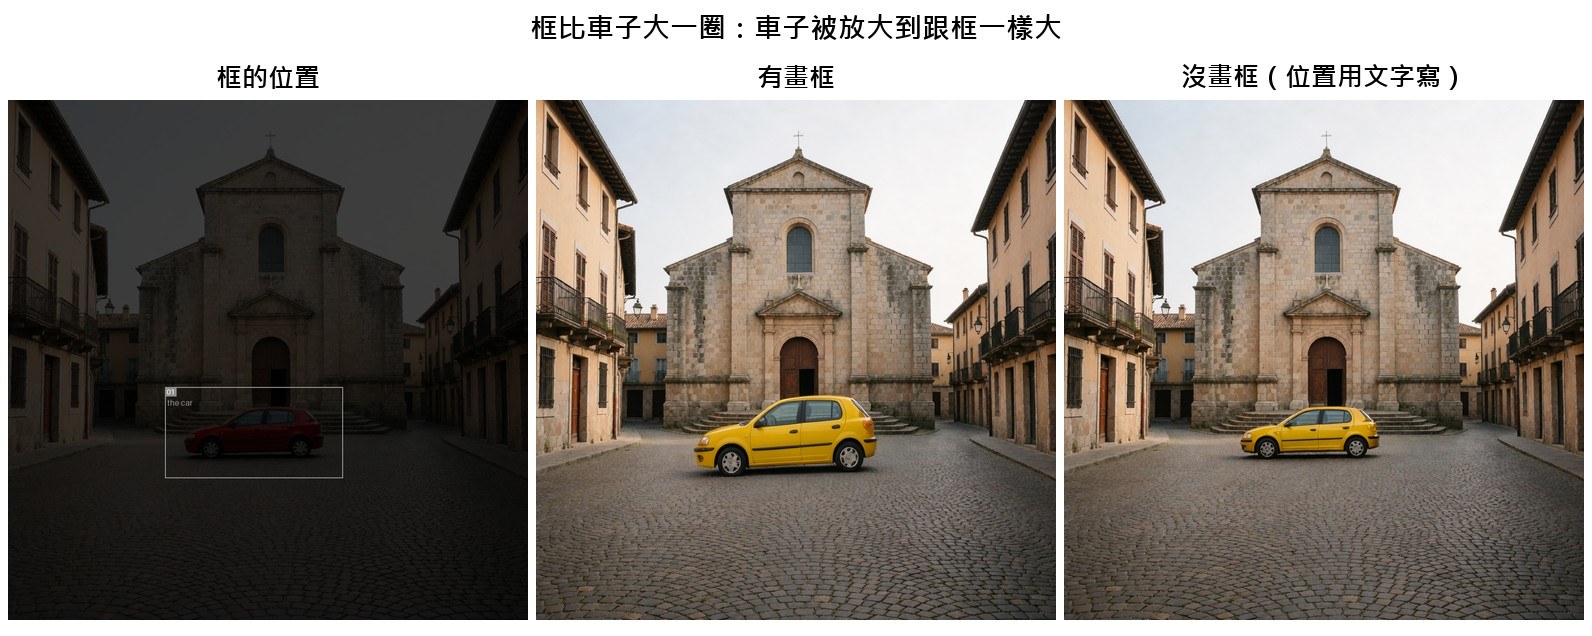
失敗的兩題都跟框畫得不夠準有關。上面這題我的框比車子大一圈,結果車子被放大到跟框一樣大——它會把框當成東西應該有的大小。另一題我框住了地毯上一整堆玩具,指令卻只寫「把那個玩具換成仙人掌」,它只換掉了其中一個。所以用法很簡單:框要貼齊要改的那一樣東西,一個框只框一樣。
另外,框選不能接擴寫模型:擴寫模型的說明裡寫著要刪掉座標和 <obj_1> 這類代號,接上去框的資訊就不見了。
三、一般文生圖:跟 Qwen-Image-2.1、Krea2 同一級
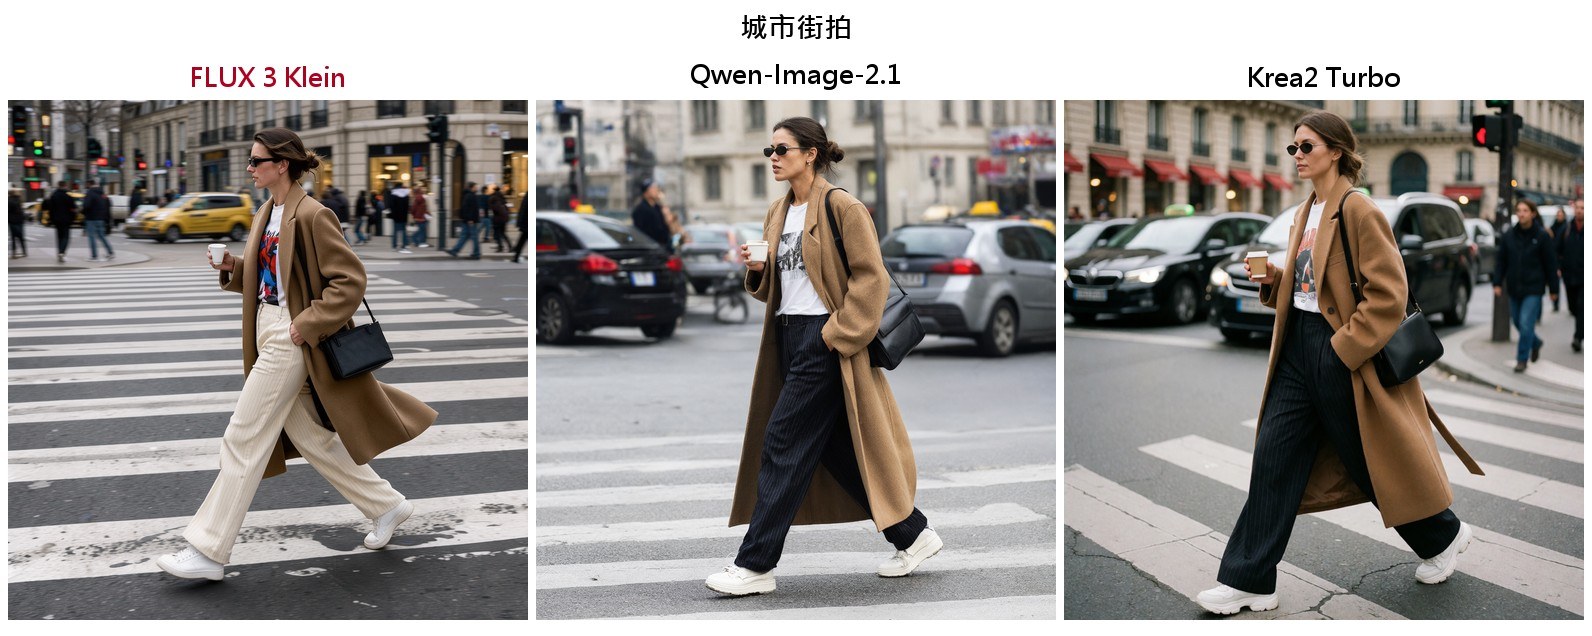
這 35 題是我每次評比都會跑的固定題目,有人像、插畫、廣告、街拍、動物。比較的對象是 Qwen-Image-2.1 和我平常用的 Krea2 Turbo,每題跟兩者中比較好的那張比。結果 5 勝 28 平 2 輸。
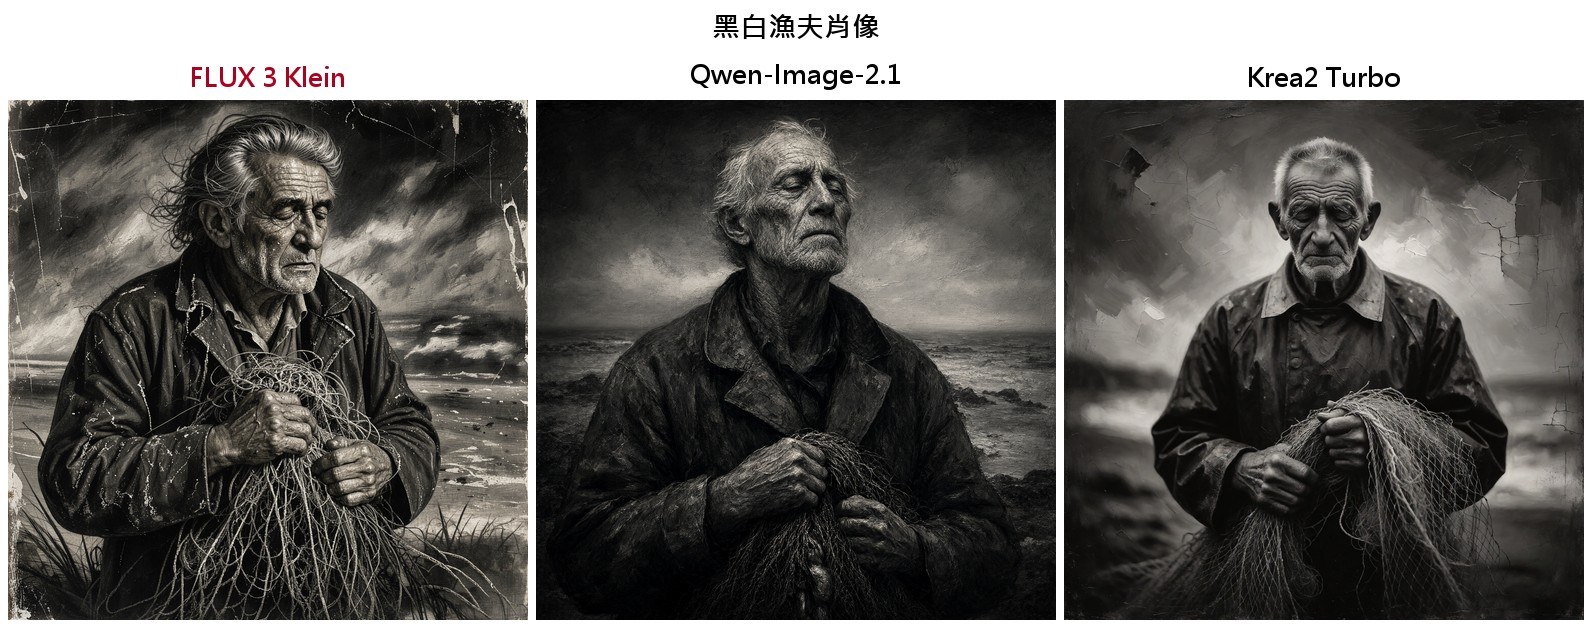
先看我判 Klein 3 勝出的三題。第一題要的是高對比的黑白肖像:年老的漁夫抱著一綑漁網,閉著眼睛,用林布蘭式的明暗打光。
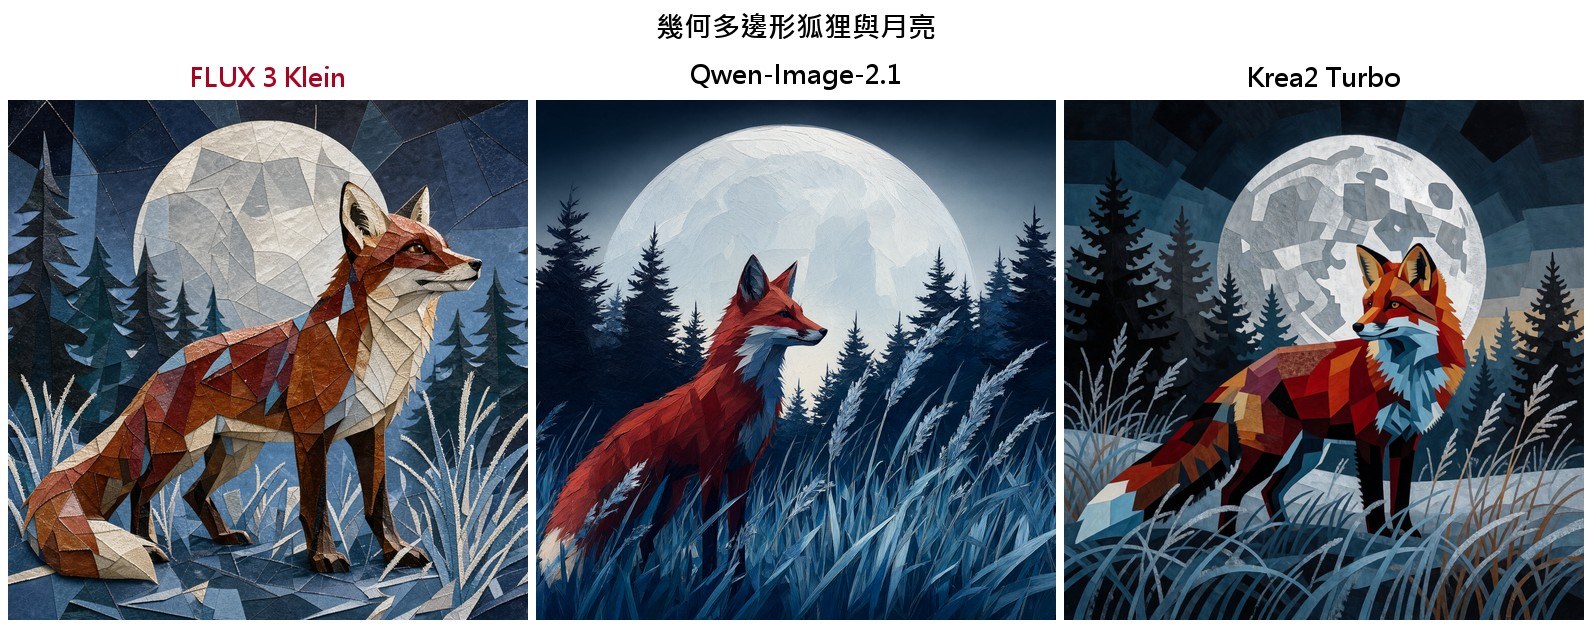
第二題是一隻由幾何多邊形拼成的狐狸,背後一個巨大的月亮。
第三題是歐洲城市正午、穿過斑馬線的女子街拍,一手拿咖啡、一手插在大衣口袋。
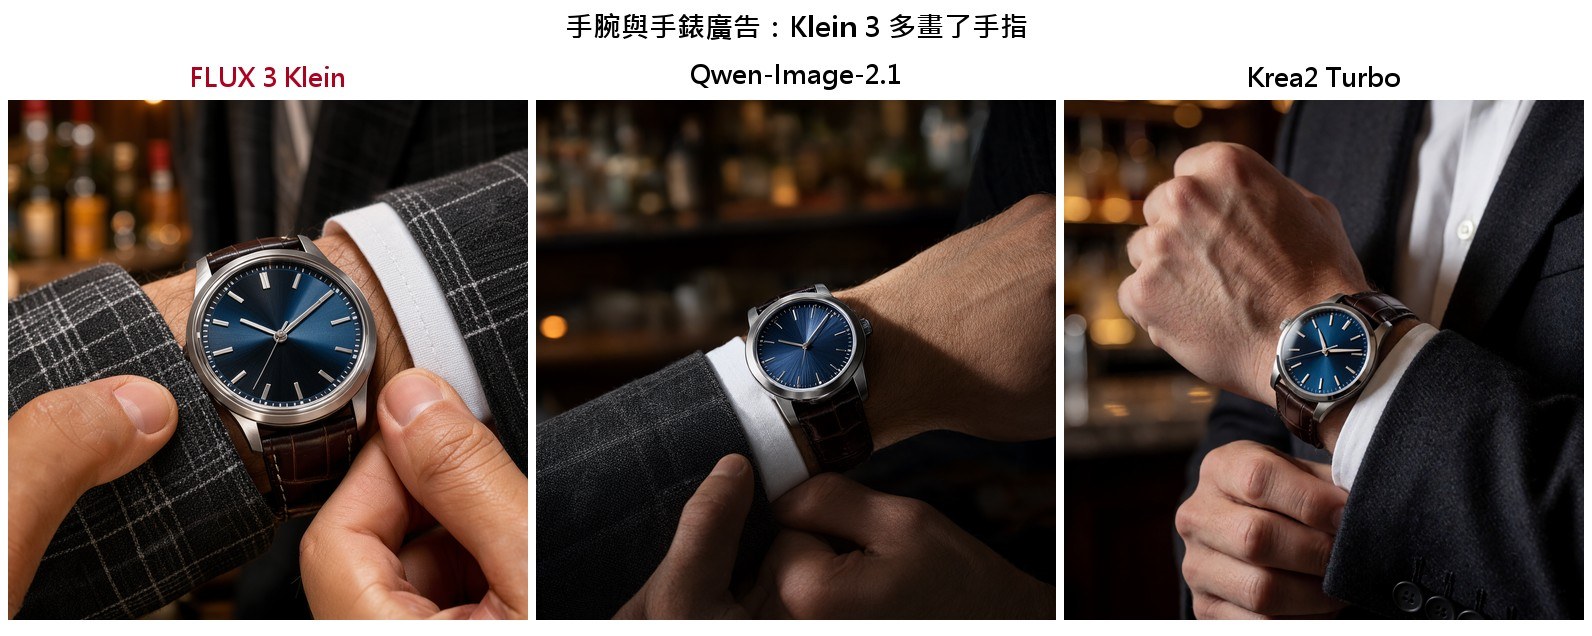
35 題裡大部分是三個模型各有特色、分不出高下。輸的有兩題,第一題是手錶廣告,Klein 3 多畫了一根手指:
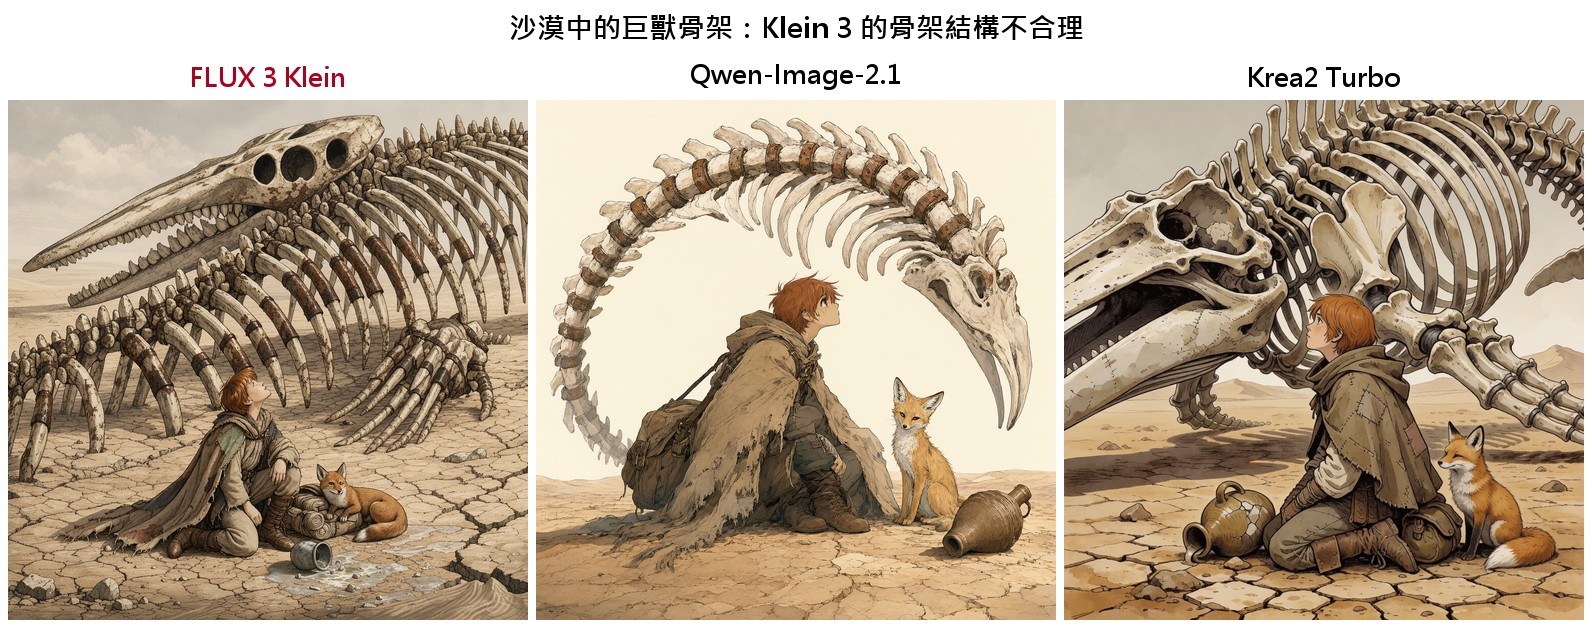
第二題是沙漠中的巨獸骨架,骨頭排列不合理,看不出是什麼動物:
另外有一個小毛病是擴寫模型造成的:它偶爾會自己在畫面上加字,原本的 prompt 並沒有要求。
四、指令遵循與英文長段文字:跟上一代差不多
指令遵循的 12 題考的是數量、顏色有沒有配對對、東西的左右上下位置,主要跟上一代 Klein 9B 比,看官方說的大幅進步有沒有出現在這裡。結果 1 勝 10 平 1 輸,大部分兩者都對或都錯。
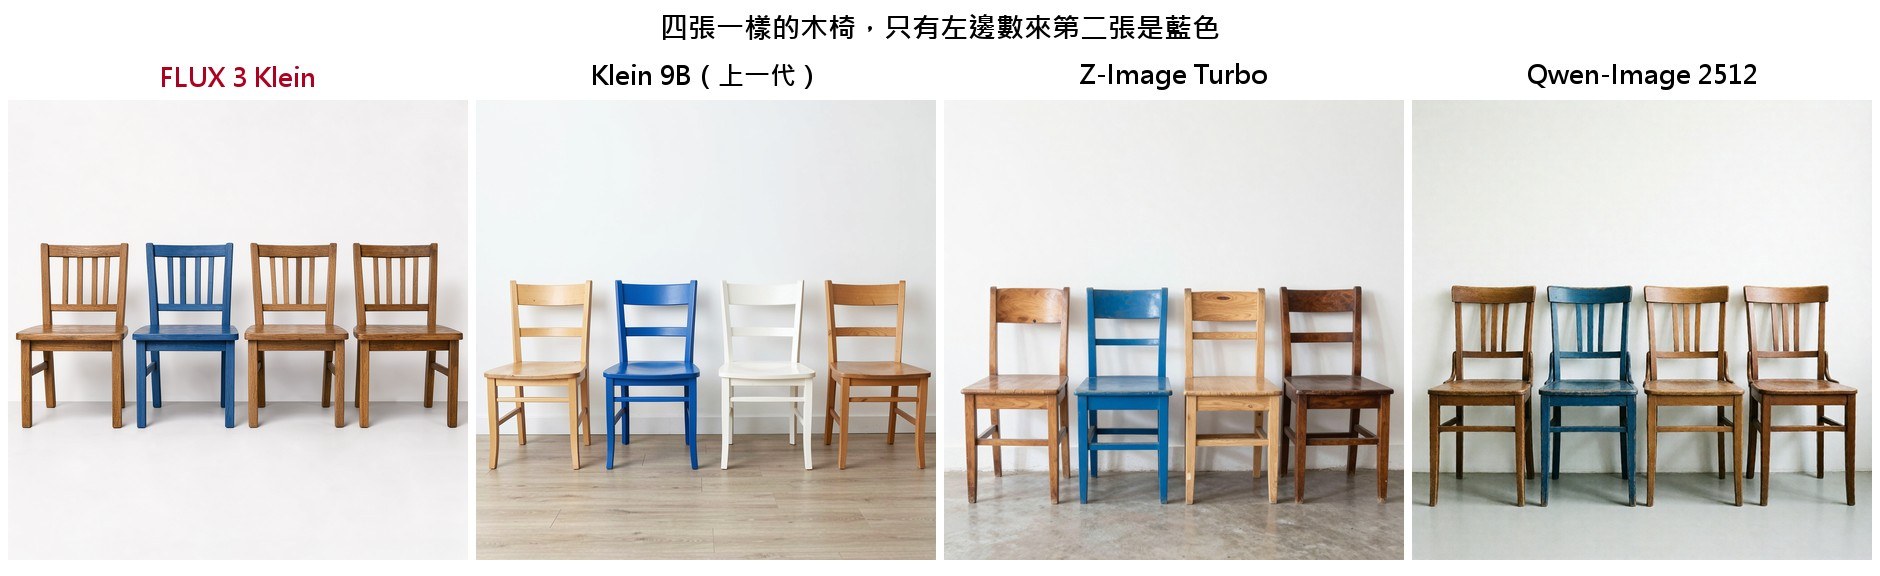
這題 Klein 3 是對的(四張一樣的木椅,左邊數來第二張是藍色),Klein 9B 把另一張椅子畫成白色。
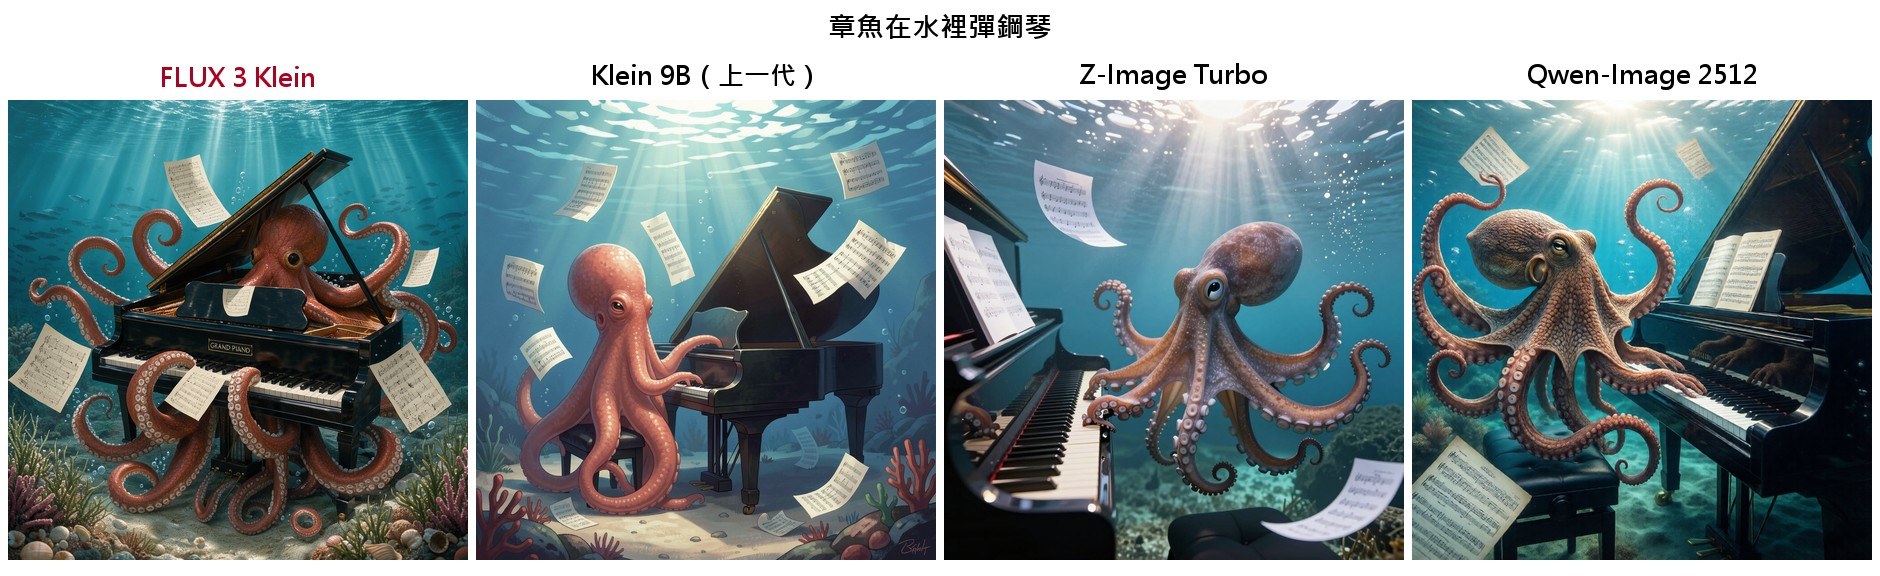
這題 Klein 3 輸了:章魚跟鋼琴都有,但章魚並沒有在彈琴。
英文長段文字 6 題(黑板、書頁、博物館說明牌、活動海報、語錄卡、果醬標籤)是 0 勝 4 平 2 輸,每題跟當時表現最好的那張比。
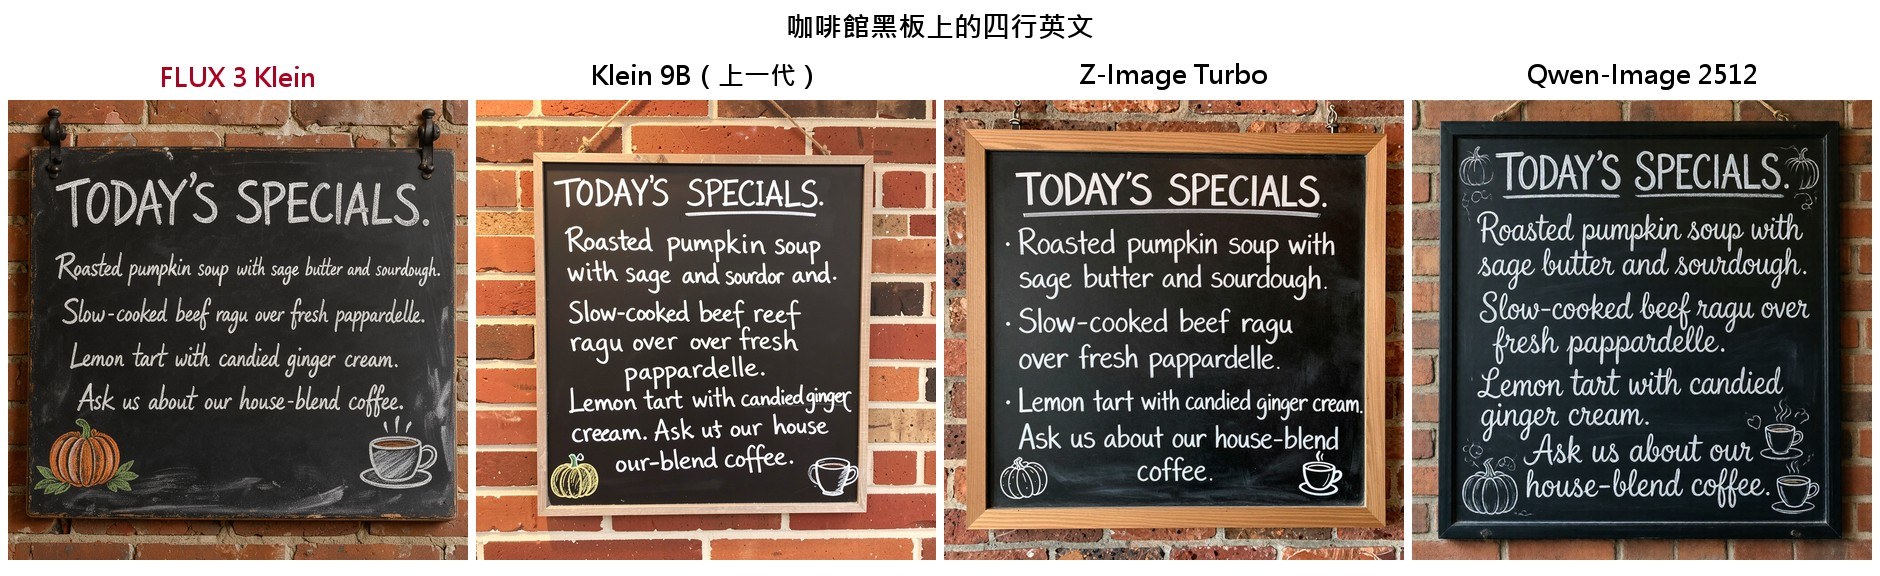
黑板這題四行英文全對,跟 Z-Image Turbo、Qwen-Image 2512 打平;Klein 9B 有錯字和重複的字。
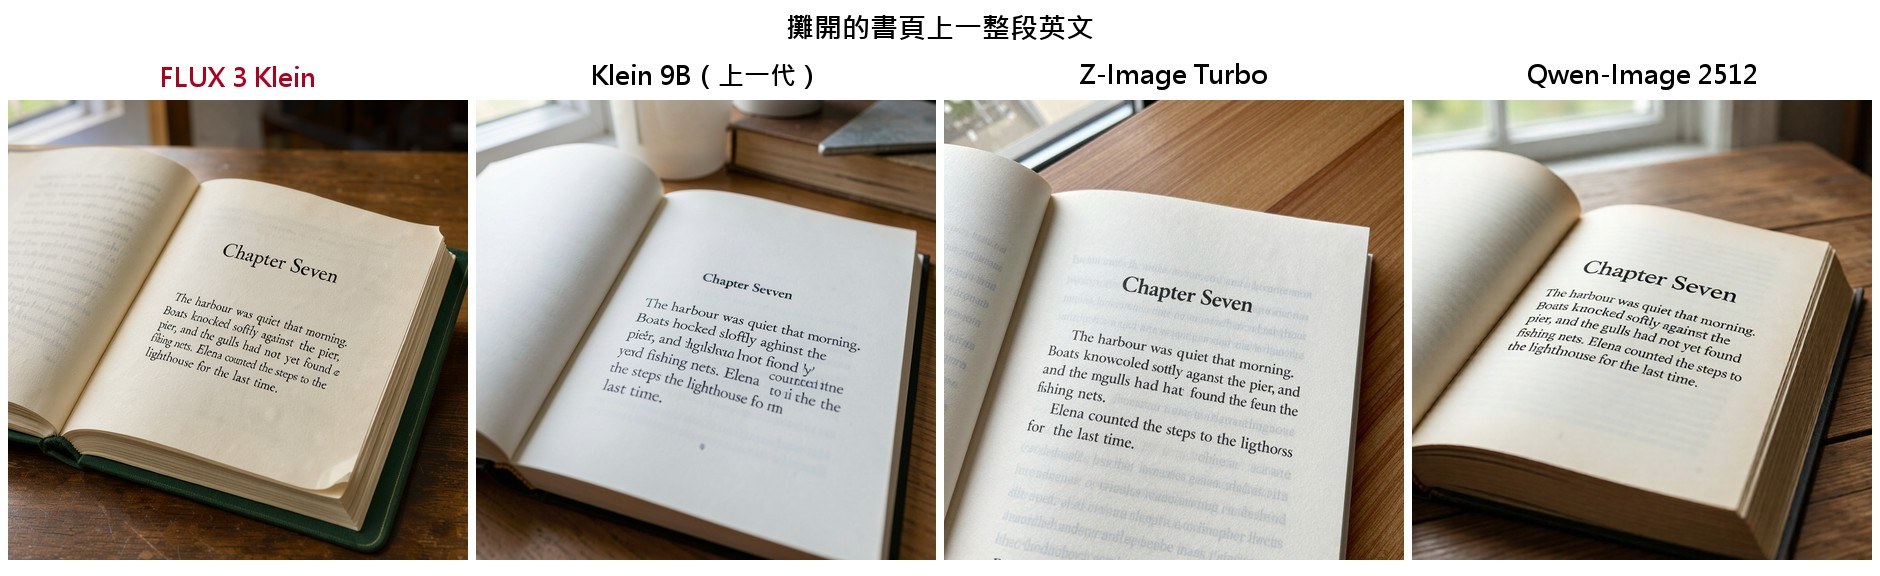
書頁這種一整段小字的題目就輸了,小字會模糊、抖動。語錄卡那題它還自己多加了三行小字。
五、繁體中文:不能用
繁體中文 53 題是我測每個新模型都會跑的,目前最穩的是 Qwen-Image-2.1 和 SenseNova U1.5(見 Qwen-Image-2.1 官方宣稱驗證)。Klein 3 的結果是 1 勝 6 平 46 輸,幾乎每題都有錯字。
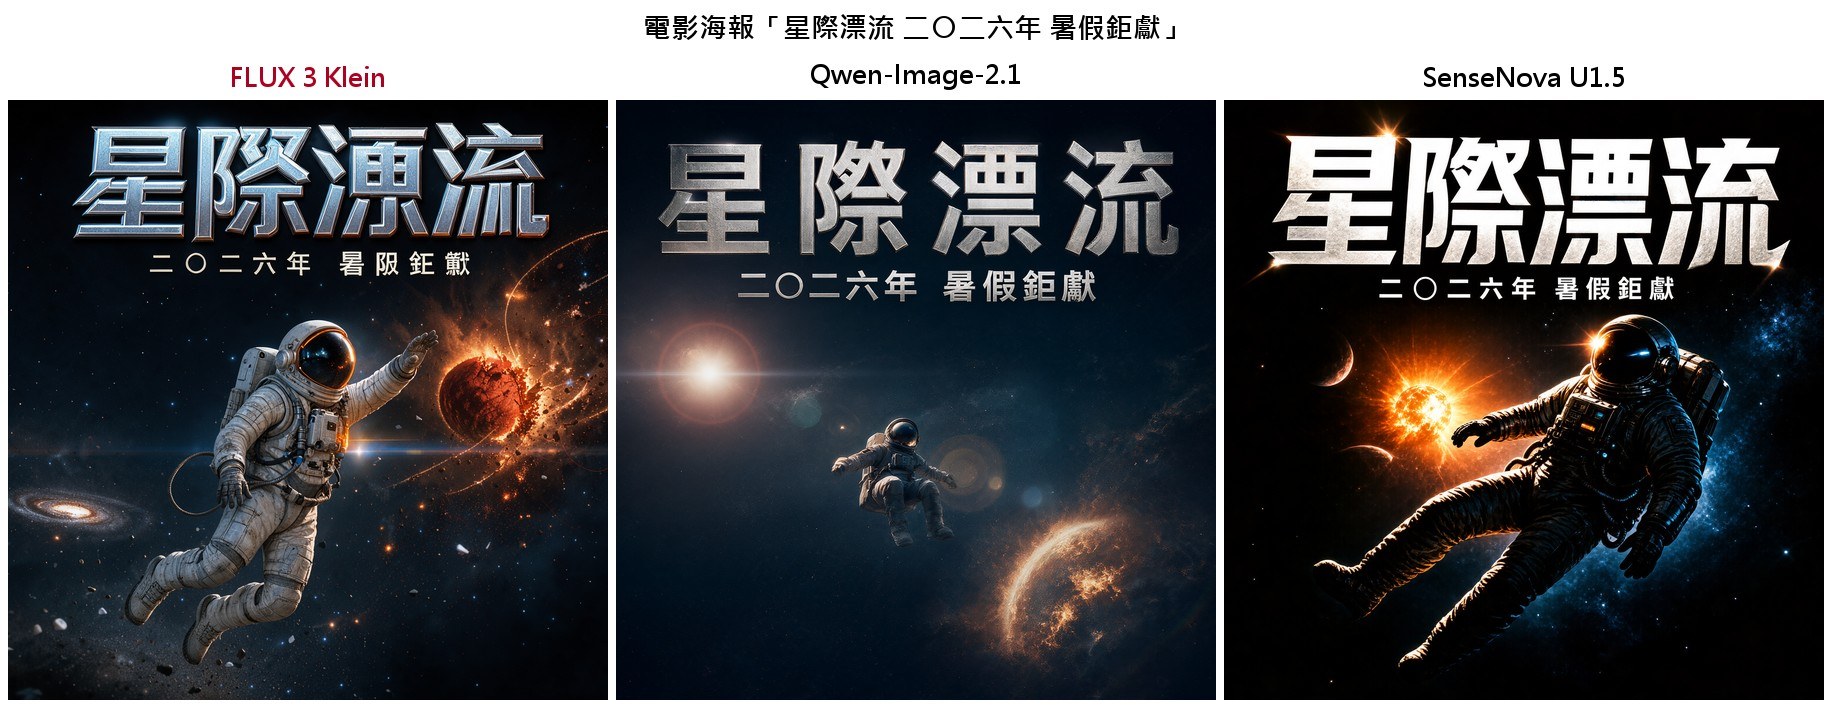
畫面本身常常很好看,像這張電影海報的構圖和質感我很喜歡,但「暑假」寫成了「暑限」。
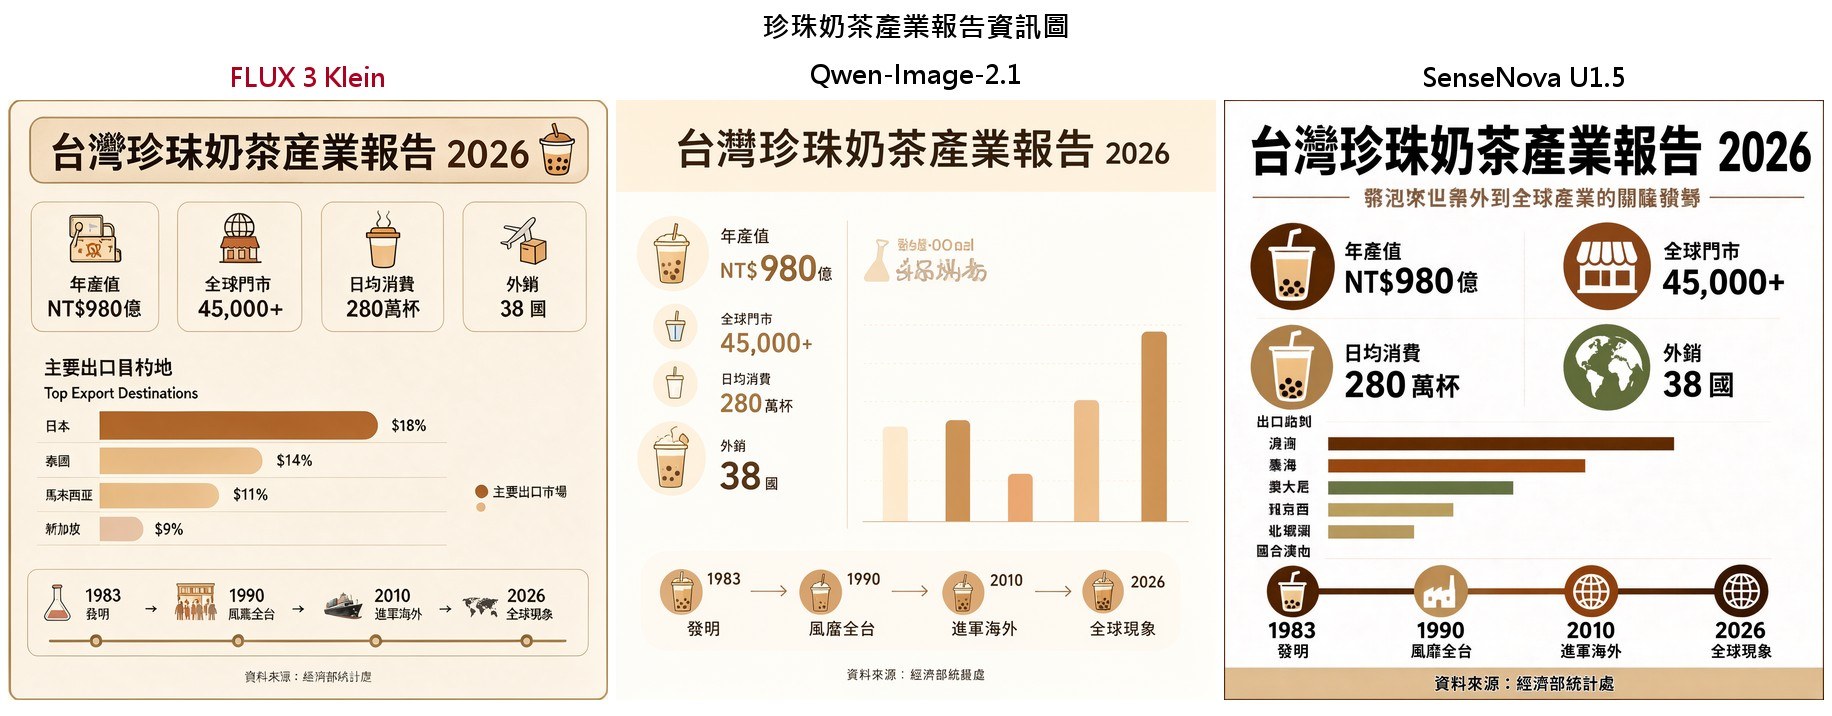
大字大多寫得出來,小字就模糊了,資訊圖這類有很多小字的版面不適合用它。
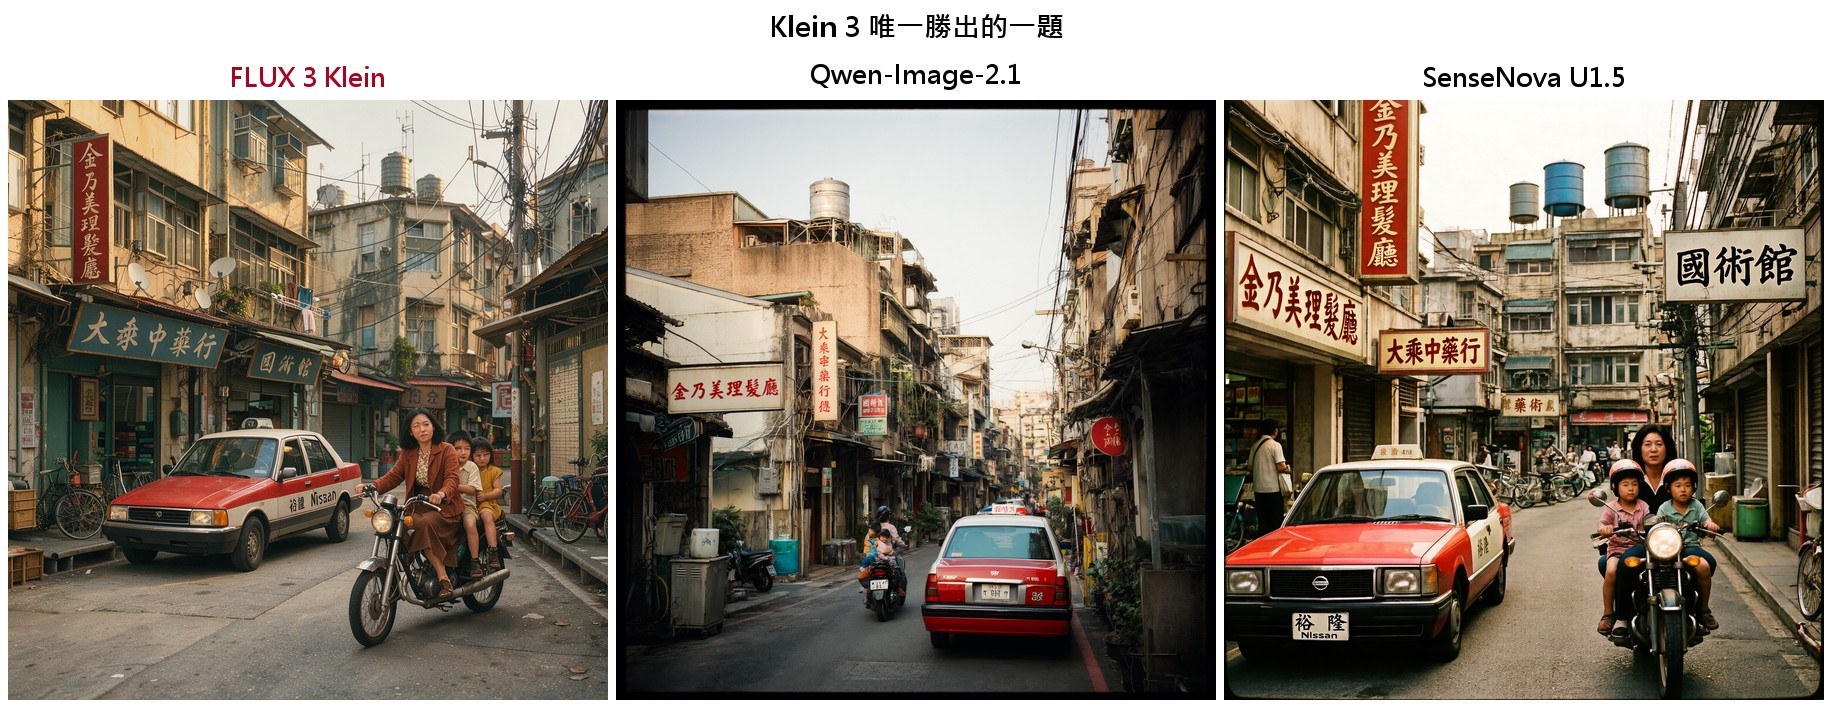
唯一勝出的是這張老街:招牌的字一樣有錯,但街景、計程車、機車上的一家人這些內容都照 prompt 畫出來了,整體最接近要求。另外,有幾題跟文字無關的人像題(指定側光、林布蘭光、單手撐地的動作)它也沒做到。
要做繁體中文的海報、招牌、資訊圖,還是用 Qwen-Image-2.1 或 SenseNova。
六、換頭與換臉:不建議
這兩項沿用換臉 vs 換頭評比的 24 題。Klein 3 沒有專用的 LoRA,我直接用文字指令:換頭用的句子跟換頭 LoRA 的官方範本一樣(只拿掉 LoRA 的觸發詞),換臉用的句子跟其他編輯模型一樣。換頭跟 Qwen-Image-2.1 加換頭 LoRA 比,換臉跟 InstantID(重繪幅度 0.5)和 PuLID-Flux 加 FaceDetailer(重繪幅度 0.65)比。
結果換頭 0 勝 3 平 21 輸,換臉 2 勝 1 平 21 輸。
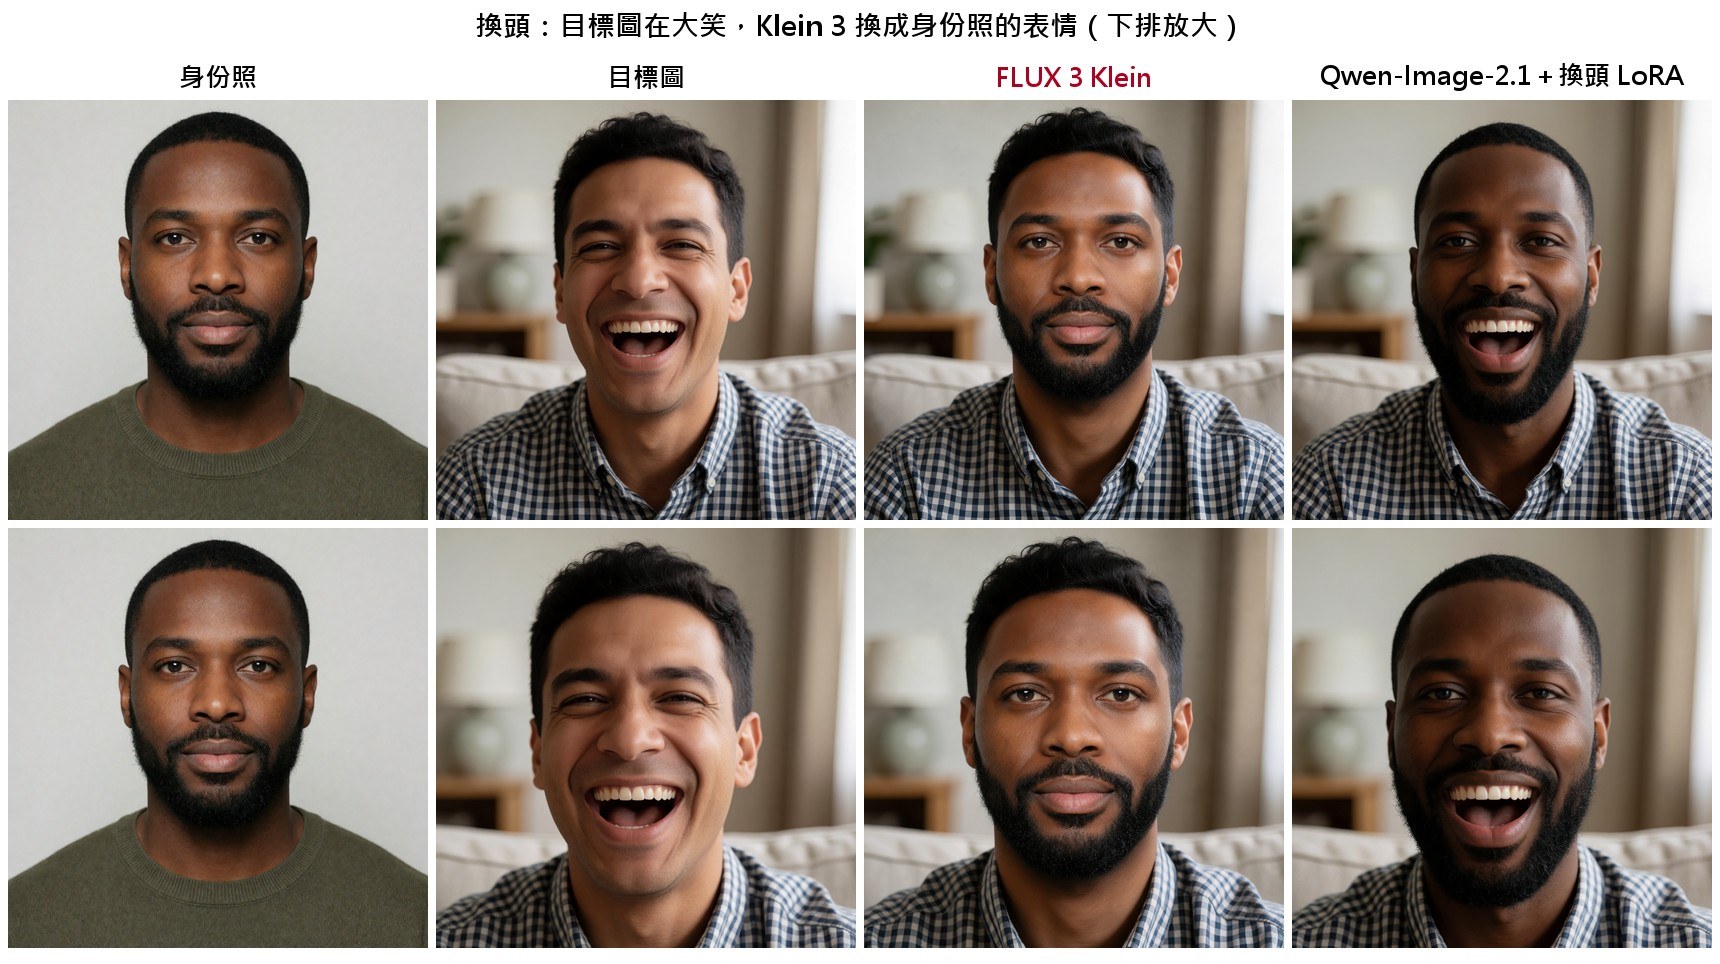
最常見的問題是表情和角度不會跟著目標圖:目標圖在大笑,換上去的頭卻是身份照那種中性表情;目標圖是側臉,它只轉到 45 度;目標圖在仰頭,它沒有仰。
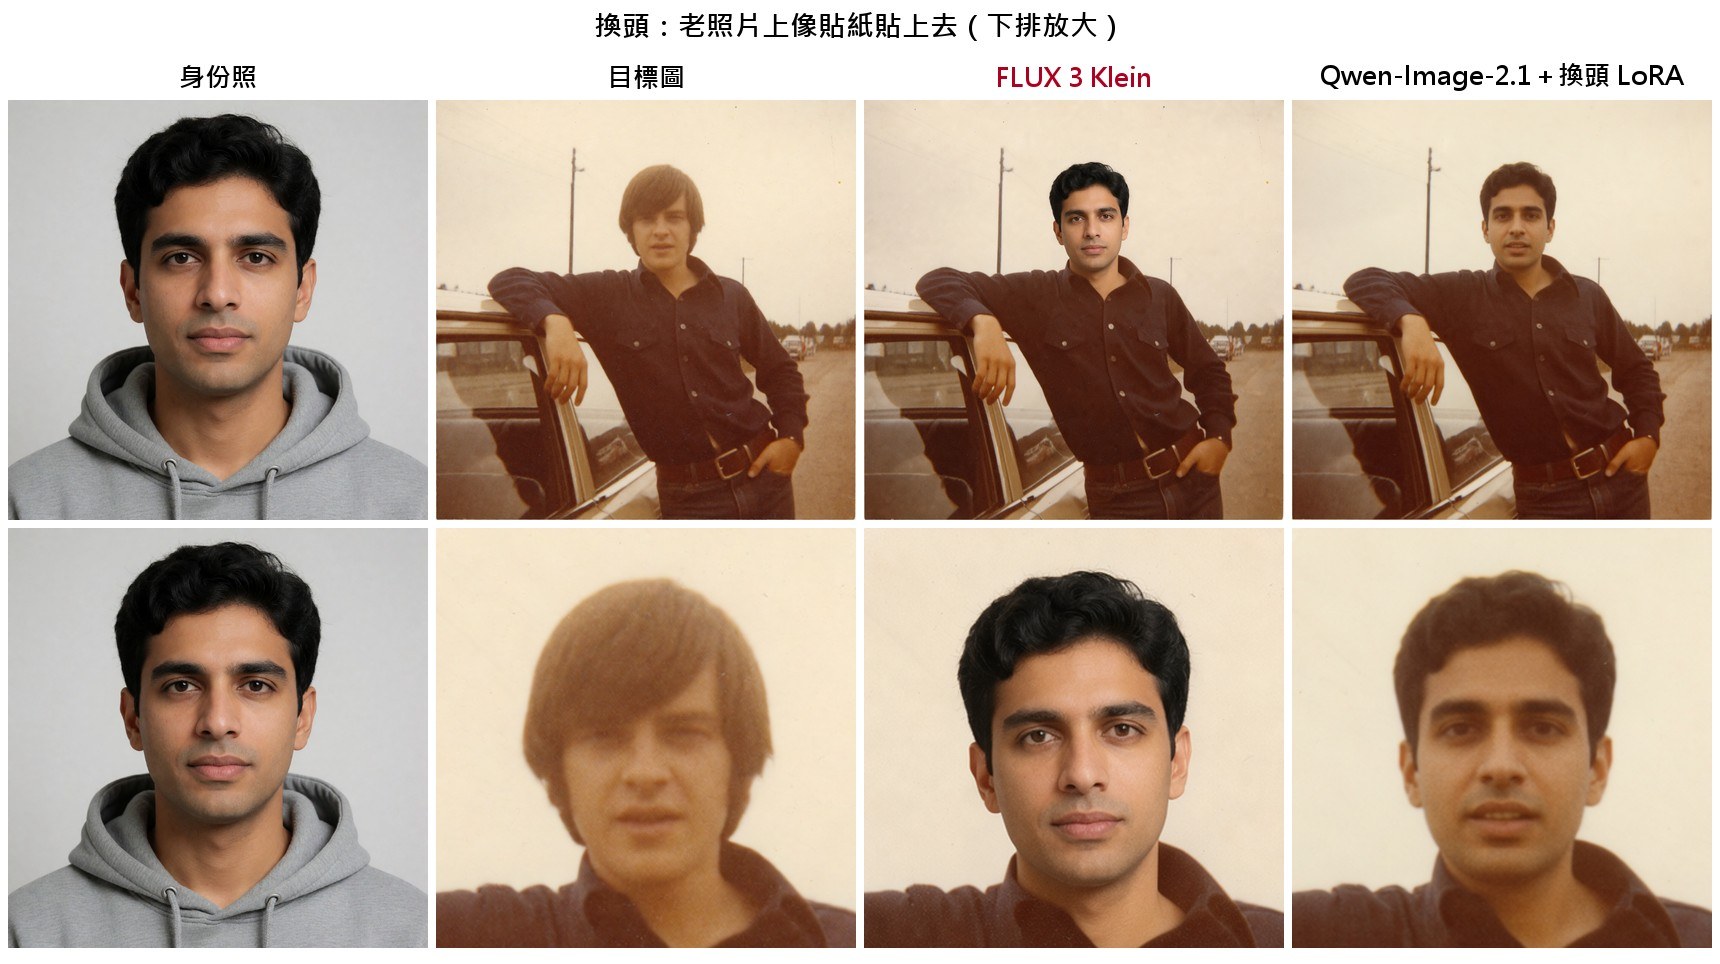
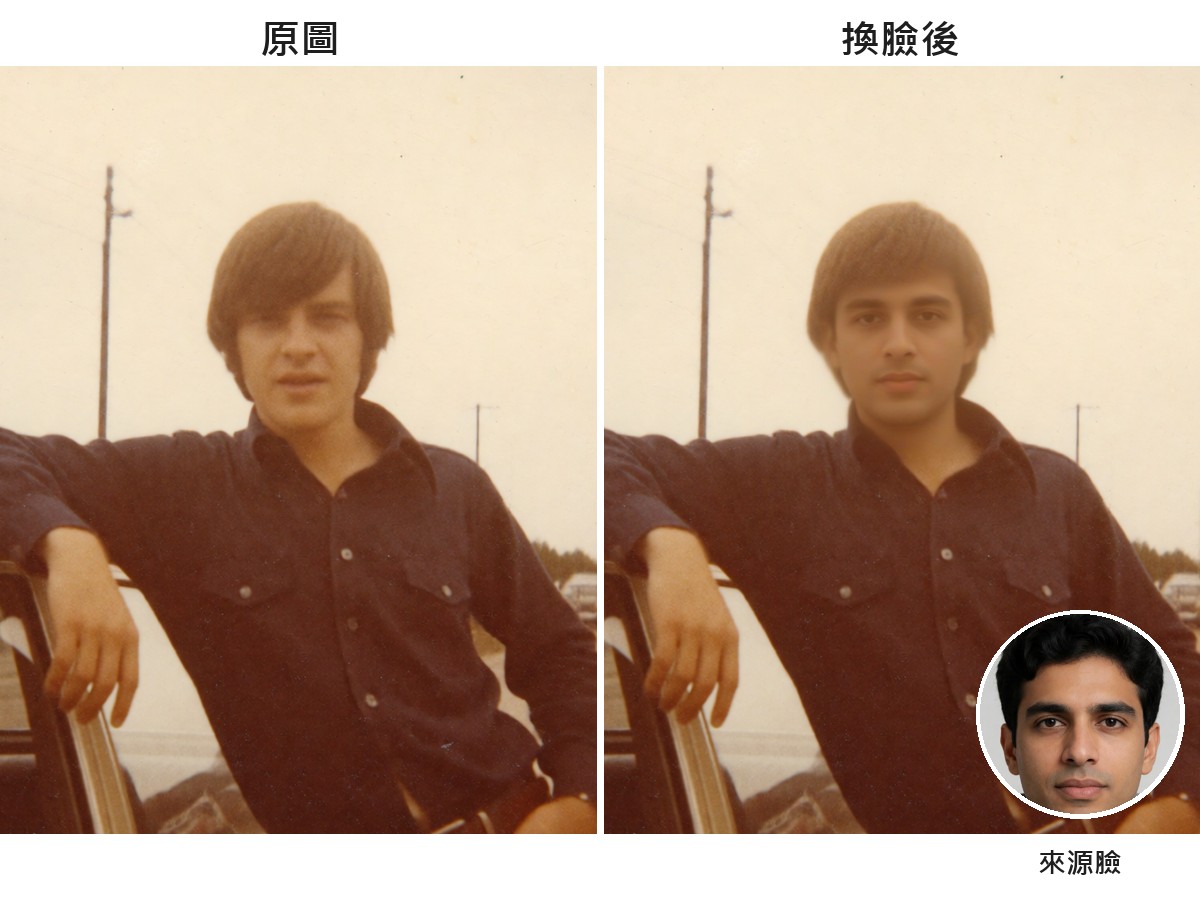
另一個問題是換上去的頭像貼紙:亮度、色調比周圍亮,跟原圖接不起來,老照片這題最明顯。
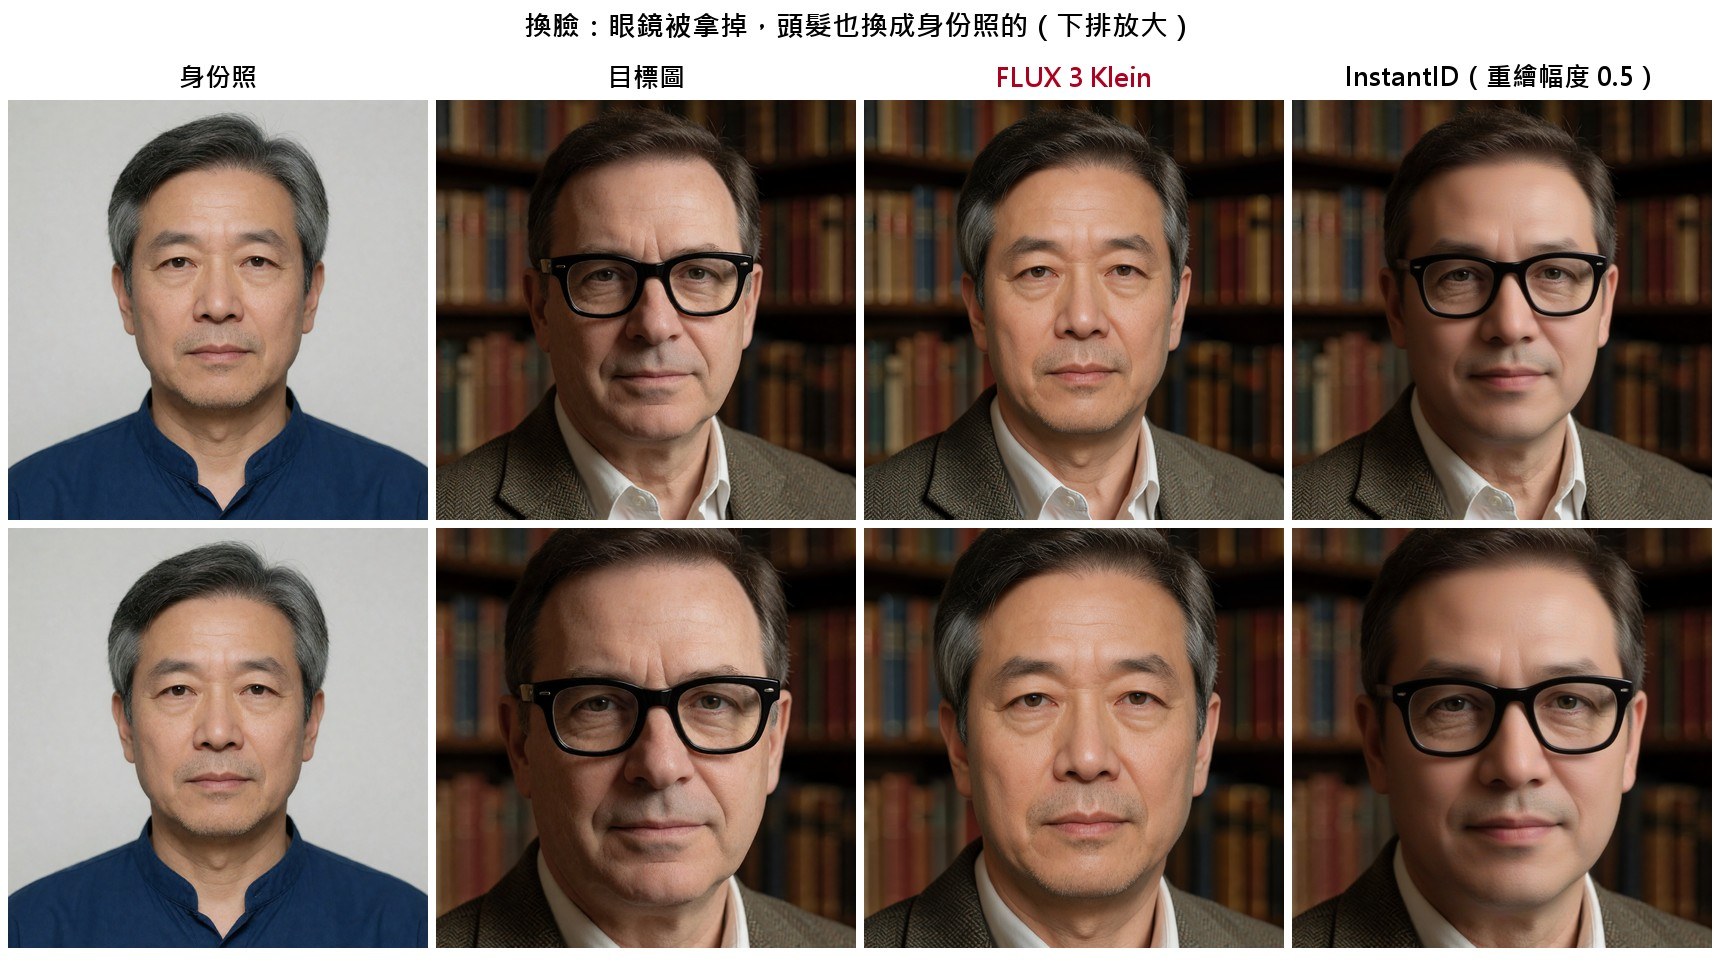
換臉同樣有表情不跟、偏亮的問題,有時還不只換臉:這題連頭髮也換成身份照的,戴的眼鏡也被拿掉了,等於做了換頭。
有一點值得一提:用自動辨識臉孔的工具算「像不像身份照」,Klein 3 換頭的分數跟 Qwen-Image-2.1 加換頭 LoRA 幾乎一樣。但這個分數只量臉像不像,量不到表情、角度、亮度接不接得上,實際看圖差很多。
情境推薦
| 你要做的事 | 用 Klein 3 嗎 | 備註 |
|---|---|---|
| 一般照片拿掉路人、雜物、零散小東西 | 用 | 21 題成功 20 題,不用畫遮罩,也不用另外跑改寫指令的模型 |
| 拿掉東西,但沒改的地方要完全不動 | 不建議 | 改用畫遮罩、貼回原圖的做法(見物件移除評比) |
| 照片裡有好幾個相似的人或物,只改其中一個 | 用,加畫框 | 框要貼齊要改的那一樣東西 |
| 指定東西放在畫面哪裡、多大 | 用,加畫框 | 一般位置用文字寫也大致會對 |
| 日常生圖 | 可以用 | 跟 Qwen-Image-2.1、Krea2 同一級 |
| 繁體中文海報、招牌、資訊圖 | 不用 | 用 Qwen-Image-2.1 或 SenseNova |
| 英文長段小字 | 不用 | 大字可以,小字會糊 |
| 換頭、換臉 | 不用 | 換頭用 Qwen-Image-2.1 加換頭 LoRA;換臉用 InstantID 或 PuLID-Flux 加 FaceDetailer |
授權:Klein 3 是 FLUX Kommunity License,個人和年營收低於 500 萬美元的公司可以免費商用。
在 ComfyUI 裡怎麼用
- ComfyUI 要更新到 0.41 以上,舊版不認得這個模型。
- 範本庫裡有四個官方範本:FLUX 3 Image Klein 的文生圖、蒸餾版文生圖、圖片編輯、蒸餾版圖片編輯。照這次的結果,日常用蒸餾版就好。
- 文生圖範本預設會接擴寫模型,有開關可以關掉;如果你已經寫好一段完整的長 prompt,可以關掉直接生成。
- 編輯時 prompt 裡用
<ref_image_0>代表你給的那張照片,第二張參考圖是<ref_image_1>,以此類推。 - 框選要用 Create Bounding Boxes 和 FLUX.3 Layout Prompt 兩個節點,記得不要接擴寫模型。
附錄:這次用的指令
物件移除(all the tourists 換成要拿掉的東西;跟上一篇物件移除評比的指令一樣,只把 the image 換成 Klein 3 的照片代號 <ref_image_0>):
Remove all the tourists from <ref_image_0>. Fill the area naturally so it matches the surrounding background. Keep everything else in the image exactly the same.
框選局部修改(兩人合照那題。框畫在左邊那位的上半身,描述寫 the man on the left, his shirt;送進模型時,FLUX.3 Layout Prompt 節點會自動在句子後面接上框的座標):
In <ref_image_0>, change the shirt of the man <obj_1> into a red hoodie. Keep everything else unchanged.
框選排版(海報那題。三個框分別是標題、樂器、日期;標題框和日期框選「文字」類型,填入要寫的字 MIDNIGHT JAZZ、FRIDAY 9PM):
Minimal jazz concert poster, dark navy background. The title <obj_1> in bold cream letters, a golden saxophone <obj_2> illustration, and the date line <obj_3> in small letters.
換頭(<ref_image_0> 是要被換的照片,<ref_image_1> 是身份照):
Start with <ref_image_0> as the base image, keeping its lighting, environment, and background. Remove the head from <ref_image_0> completely and replace it with the head from <ref_image_1>, strictly preserving the hair, eye color, and nose structure of <ref_image_1>. Copy the eye direction, head rotation, and micro-expressions from <ref_image_0>. Keep the body, clothing, pose, framing, and background intact.
換臉:
Replace the face of the person in <ref_image_0> with the face of the person in <ref_image_1>. Keep the hairstyle, head pose, facial expression, clothing, lighting and background of <ref_image_0> unchanged.
模型下載
模型在 Hugging Face 的 black-forest-labs/flux-3-image-klein-comfy,要先登入並同意授權條款才能下載。這次用到的四個檔案:
| 檔案 | 用途 | 放置位置 |
|---|---|---|
flux3_image_klein_sd_int8_convrot.safetensors | 生成模型(蒸餾版,int8) | diffusion_models/ |
qwen3vl_4b_int8_convrot.safetensors | 文字編碼器(int8) | text_encoders/ |
qwen3.5_9b_flux3_prompt_upsampler_w4a8.safetensors | prompt 擴寫模型 | text_encoders/ |
flux2-vae.safetensors | VAE,跟 FLUX.2 共用 | vae/ |
檔名裡有 sd 的是蒸餾版,沒有的是給人微調用的完整版。如果你的 text_encoders/ 裡已經有其他模型用的同名檔案(例如 qwen3vl_4b_bf16),內容不一定一樣,建議放進子資料夾,避免互相覆蓋。
相關文章
- ComfyUI 物件移除大評比:12 條路線同圖實測 — 這次物件移除的題目與對手
- ComfyUI 換臉 vs 換頭:12 種做法實測 — 這次換頭換臉的題目與對手
- Qwen-Image-2.1 官方宣稱驗證 — 繁體中文 53 題目前最穩的模型
- 開源圖像編輯模型大亂鬥 — 上一代 Klein 9B 的一般編輯能力