為什麼要做這篇
把照片裡不想要的東西拿掉,是修圖最常見的需求:觀光景點前的一群遊客、天空中橫過去的電線、人像背後路過的人、圖庫照片上的浮水印、老照片的刮痕。在 ComfyUI 裡做這件事,選擇多到讓人不知道從哪裡開始——有專門的擦除模型、有各家的補畫模型,最近一年的圖像編輯模型又號稱一句話就能移除。
上一篇去背評比寫完之後,我照同一套方法再做一輪:把找得到的物件移除做法全部接進同一張工作流,21 張測試圖每張跑完 12 條路線,結果排在一起比。 好壞由我自己逐張判斷,每題勾選「物件確實消失、補得自然、沒有長出新東西」的路線,最後算成功次數。
快速結論
- 只給一句移除指令的編輯模型全面勝出:Qwen-Image-2.1 加上官方 Prompt Enhancer 21 題成功 19 題、Klein 9B 18 題、Qwen-Image-Edit-2511 16 題、Flux Kontext 14 題;畫遮罩補畫的做法最多 9 題,傳統擦除模型最多 4 題
- 差距出在真實照片:13 張真實場景裡,Qwen-Image-2.1 加 Prompt Enhancer 全部成功,畫遮罩補畫的做法最多只過 3 張;浮水印、木地板上的背包這類單純的題目,幾乎每條路線都過
- 畫遮罩補畫最常見的失敗是「補回一個新東西」:拿掉一群遊客,補出一排穿西裝的人;拿掉酒瓶,又畫出一個新瓶子
- 編輯模型會一起處理影子和倒影,遮罩沒框到的影子它也會拿掉;畫遮罩的做法只會動遮罩裡面
- 編輯模型有兩個要注意的副作用:它會整張重畫,遮罩以外的地方也會有細微改變;Qwen-Image-2.1 修老照片時會把黑白照片自動上色
- 傳統擦除模型(LaMa、MAT)只適合小面積、紋理單純的地方,面積一大就糊成一片
先懂三種做法
這篇測的 12 條路線,按照「你要給它什麼」分成三類。看後面的對照圖之前,先知道它們的差別。
傳統擦除:只給遮罩。 遮罩是一張黑白圖,白色的地方代表「這裡要拿掉」。LaMa(2021 年)和 MAT(2022 年)是專門做這件事的模型,它們看遮罩周圍的紋理,把洞補起來。不需要文字、速度很快,但它們不會「想像」被擋住的東西長什麼樣子,所以補小洞很自然,補大洞就會糊。
遮罩式生成:給遮罩,再給一句背景描述。 用生圖模型只重畫遮罩裡面的部分,並告訴它這裡應該是什麼(例如「空的石板路,後面是紅色的寺廟大門」)。這次測了 BrushNet(SD1.5 時代的補畫模型)、Flux Fill(Flux 官方的補畫版本)、Flux Fill 加上一個專門做物件移除的 LoRA、Qwen-Image 搭配修補用的 ControlNet,以及我平常生圖用的 Krea2 直接只重畫遮罩區域。這一類畫完之後我都把結果貼回原圖,所以遮罩以外的地方一個像素都不會變。
指令式編輯:只給一句話。 不畫遮罩,直接跟圖像編輯模型說「把畫面裡的某某拿掉,其他地方保持不變」。模型自己找出要拿掉的東西,然後整張圖重新畫一次。這次測了 Qwen-Image-Edit-2511、Flux.2 Klein 9B、Flux.1 Kontext,以及 Qwen-Image-2.1。Qwen-Image-2.1 的指令先經過官方的 Prompt Enhancer——這是一個專門把指令改寫得更完整的模型,會把畫面裡要拿掉的東西、要保留的東西逐項寫出來——上一篇進階用法實測已經確認它對生成結果有幫助,所以這裡也照用。
遮罩是怎麼畫出來的
前兩種做法都需要遮罩。遮罩就是一張跟原圖一樣大的黑白圖:白色的地方是要拿掉的,黑色的地方保持不動。後面的對照圖為了好看,把白色的部分改成紅色疊在原圖上,兩者是同一件事:
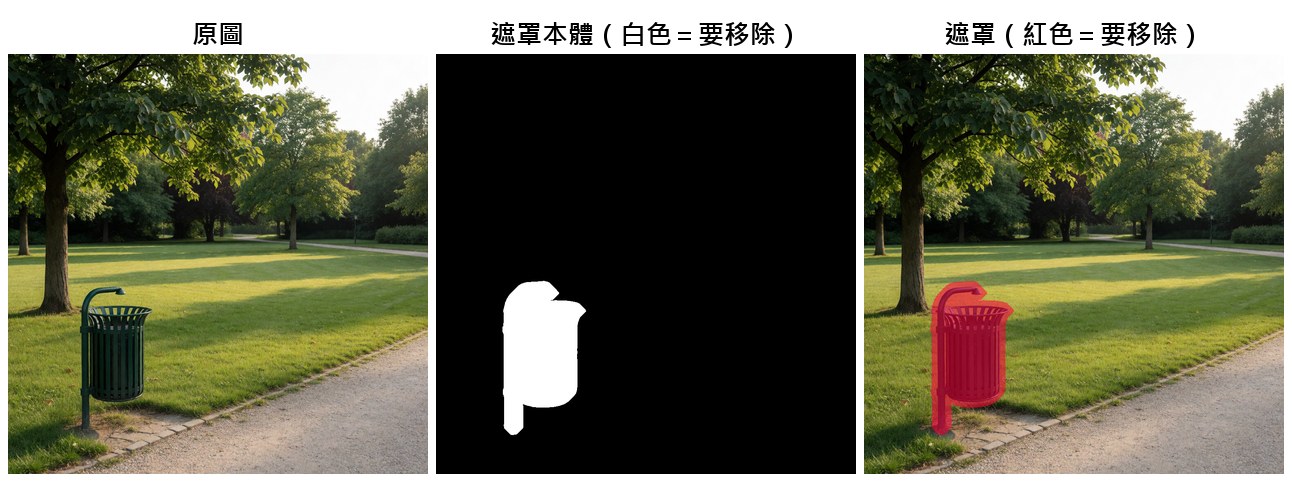
在 ComfyUI 裡有兩種方式做出這張圖。
自己用筆刷塗。 在讀取圖片的節點(Load Image)上按右鍵,選「Open in MaskEditor」,會打開一個像小畫家的視窗,用筆刷把要拿掉的東西塗滿,按儲存就好。塗好的範圍會從節點的 MASK 輸出接出去,直接連到補畫的節點。塗的時候範圍要比物件大一點,把邊緣、影子一起蓋住,補出來才不會留下一圈輪廓。一兩張圖自己塗最快。
用文字自動框。 這次 21 張圖、每張都要用同一個遮罩給 8 條路線,所以我改用 SAM 3.1:輸入一個英文名詞(例如 person、trash can),它會找出畫面裡符合的東西、自動畫出遮罩,我再讓遮罩往外擴一點,蓋住邊緣。它也有失手的時候,例如一開始只框到一群人裡的一個,或是框到桌上不相干的影子,所以每張遮罩我都打開檢查過才開始比。
至於第三種做法,指令式編輯完全不用遮罩,這也是它在實際使用上最省事的地方。
測試方法
測試圖 21 張,分兩組。 全部用 Krea2 Turbo 生成,1024×1024。
- 真實場景 13 張:要拿掉的東西直接畫在場景裡——海灘上的人、老街上的行人、人像背後路過的人、天空中的電線與電線桿、廣場上的汽車、草地上的垃圾桶、大理石桌上的咖啡杯、磚牆上的海報、酒瓶和它的影子、湖面上的小船和倒影、地毯上的一堆玩具、動漫房間沙發上的貓、寺廟前的一群遊客。這組沒有標準答案,只能看。
- 有標準答案 8 張:先生成一張乾淨的圖,再用程式加上要拿掉的東西——貼上去的汽水罐、三角錐、寶特瓶、背包,兩種浮水印,兩張加了刮痕與灰塵的老照片。拿掉之後可以直接跟原本那張乾淨的圖比。
遮罩怎麼來的:真實場景的遮罩用 SAM 3.1 依文字自動框出(例如「person」),再往外擴 14 個像素,蓋住物件邊緣;有標準答案那組的遮罩是程式算出來的,完全精確。有一點要特別交代:編輯模型被要求「拿掉垃圾桶」時,會連它的支柱一起拿掉;被要求「拿掉酒瓶」時,會連影子一起拿掉。 為了公平,酒瓶的影子、船的倒影、垃圾桶的支柱我都框進了遮罩,不然只吃遮罩的做法一定會輸。
12 條路線:
| 類別 | 路線 | 給它什麼 |
|---|---|---|
| 傳統擦除 | LaMa(comfyui-rmbg 節點)、LaMa(LayerStyle 節點)、MAT(LayerStyle 節點) | 只給遮罩 |
| 遮罩式生成 | BrushNet(SD1.5)、Flux Fill、Flux Fill+移除 LoRA、Qwen-Image+修補 ControlNet、Krea2 遮罩重繪 | 遮罩+背景描述(移除 LoRA 照官方範本給「Remove the …」指令) |
| 指令式編輯 | Qwen-Image-Edit-2511、Klein 9B、Flux Kontext、Qwen-Image-2.1+Prompt Enhancer | 只給一句移除指令 |
每條路線的步數與設定都照 ComfyUI 官方範本或整合包內建工作流的預設,每張圖只跑一次(同一個隨機種子)。
幾個要誠實揭露的地方:測試圖是 AI 生成的,真實照片的雜訊與壓縮痕跡會更難;每張只跑一次,換一個隨機種子結果可能不同,尤其是遮罩式生成「補出新東西」這件事,運氣成分不小;成功與否是我一張一張看的,屬於主觀判斷。
成功次數:
| 路線 | 21 題合計 | 真實場景 13 題 | 有標準答案 8 題 |
|---|---|---|---|
| Qwen-Image-2.1+Prompt Enhancer | 19 | 13 | 6 |
| Klein 9B | 18 | 10 | 8 |
| Qwen-Image-Edit-2511 | 16 | 8 | 8 |
| Flux Kontext | 14 | 8 | 6 |
| Flux Fill+移除 LoRA | 9 | 3 | 6 |
| Flux Fill | 7 | 1 | 6 |
| Qwen-Image+修補 ControlNet | 7 | 2 | 5 |
| Krea2 遮罩重繪 | 6 | 1 | 5 |
| LaMa(LayerStyle 節點) | 4 | 1 | 3 |
| BrushNet(SD1.5) | 4 | 0 | 4 |
| MAT | 3 | 0 | 3 |
| LaMa(comfyui-rmbg 節點) | 1 | 0 | 1 |
大面積:一群遊客
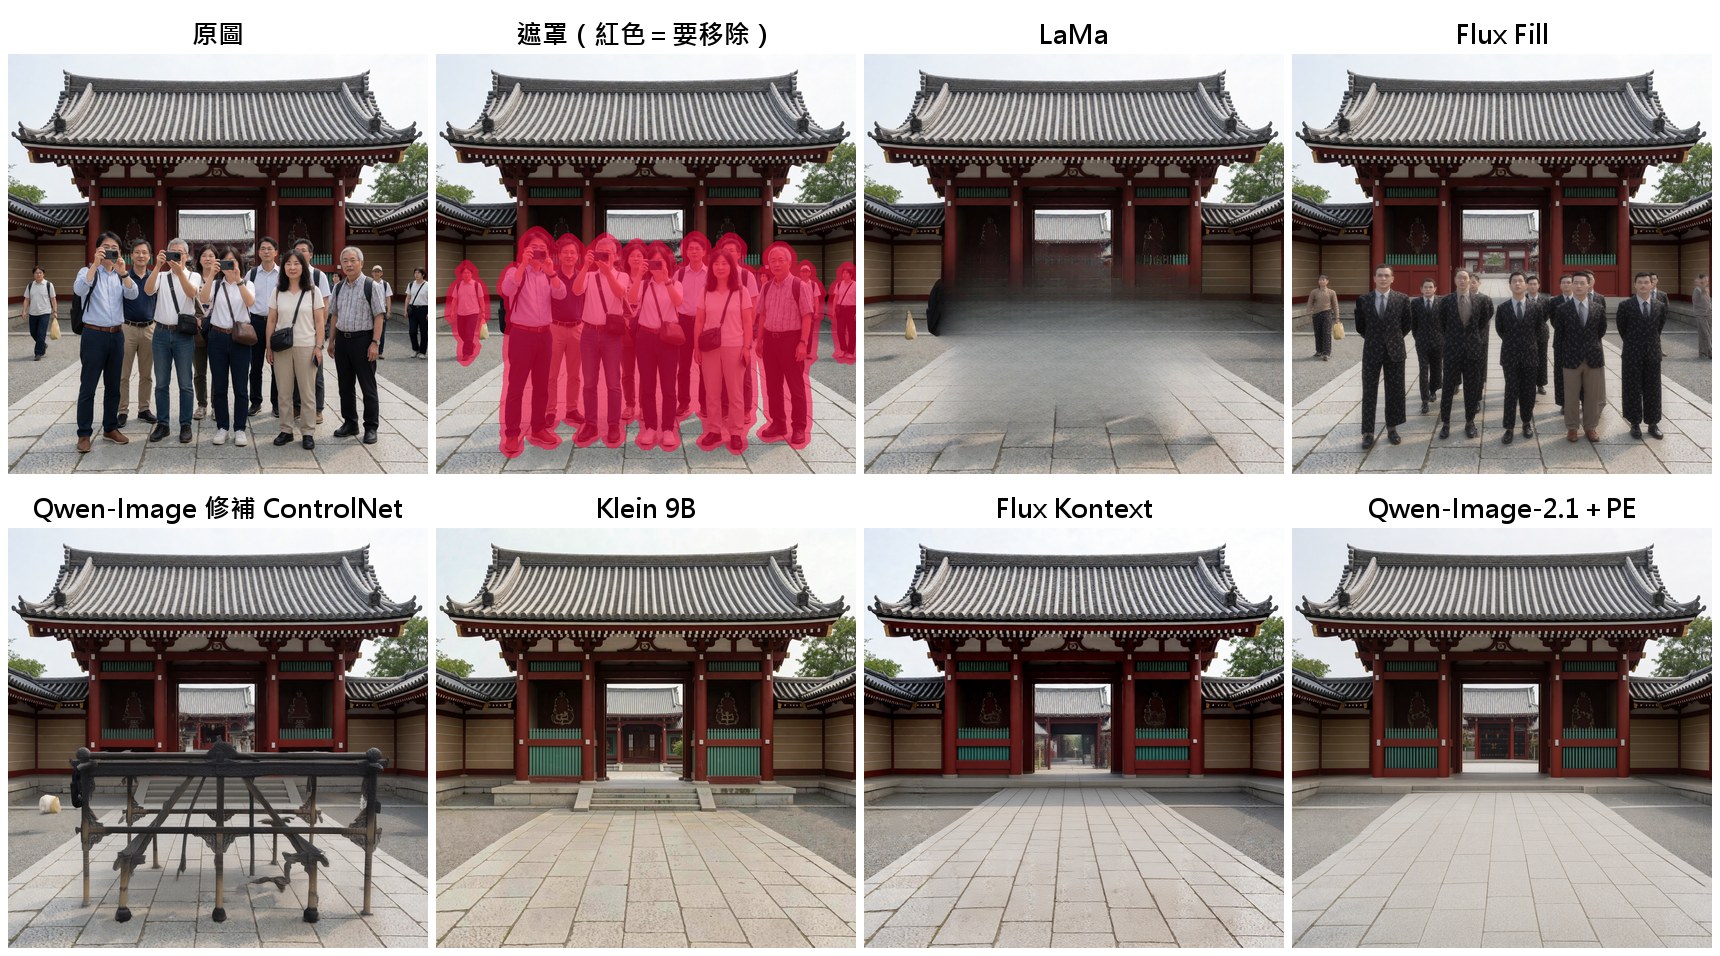
文章開頭那張是遮罩面積最大的一題,十幾位遊客擋住了寺廟前大約四成的畫面。被擋住的石板路、台階、大門下半部都得重新想像。
LaMa 把整片區域糊成灰色;Flux Fill 照著「空的石板路」這句描述畫,結果在原處畫出一排穿西裝的人;Qwen-Image 修補 ControlNet 畫出一個奇怪的木架。四款編輯模型裡 Klein 9B、Flux Kontext、Qwen-Image-2.1 都把人全部拿掉,補出一條延伸到大門的石板路,連透視都對。
這一題最能說明遮罩式生成的問題:遮罩框出來的形狀本身就像一群人,生圖模型很容易順著這個形狀又畫出人來。 面積越大、形狀越像原本的物件,越容易發生。
細長的東西:電線與電線桿
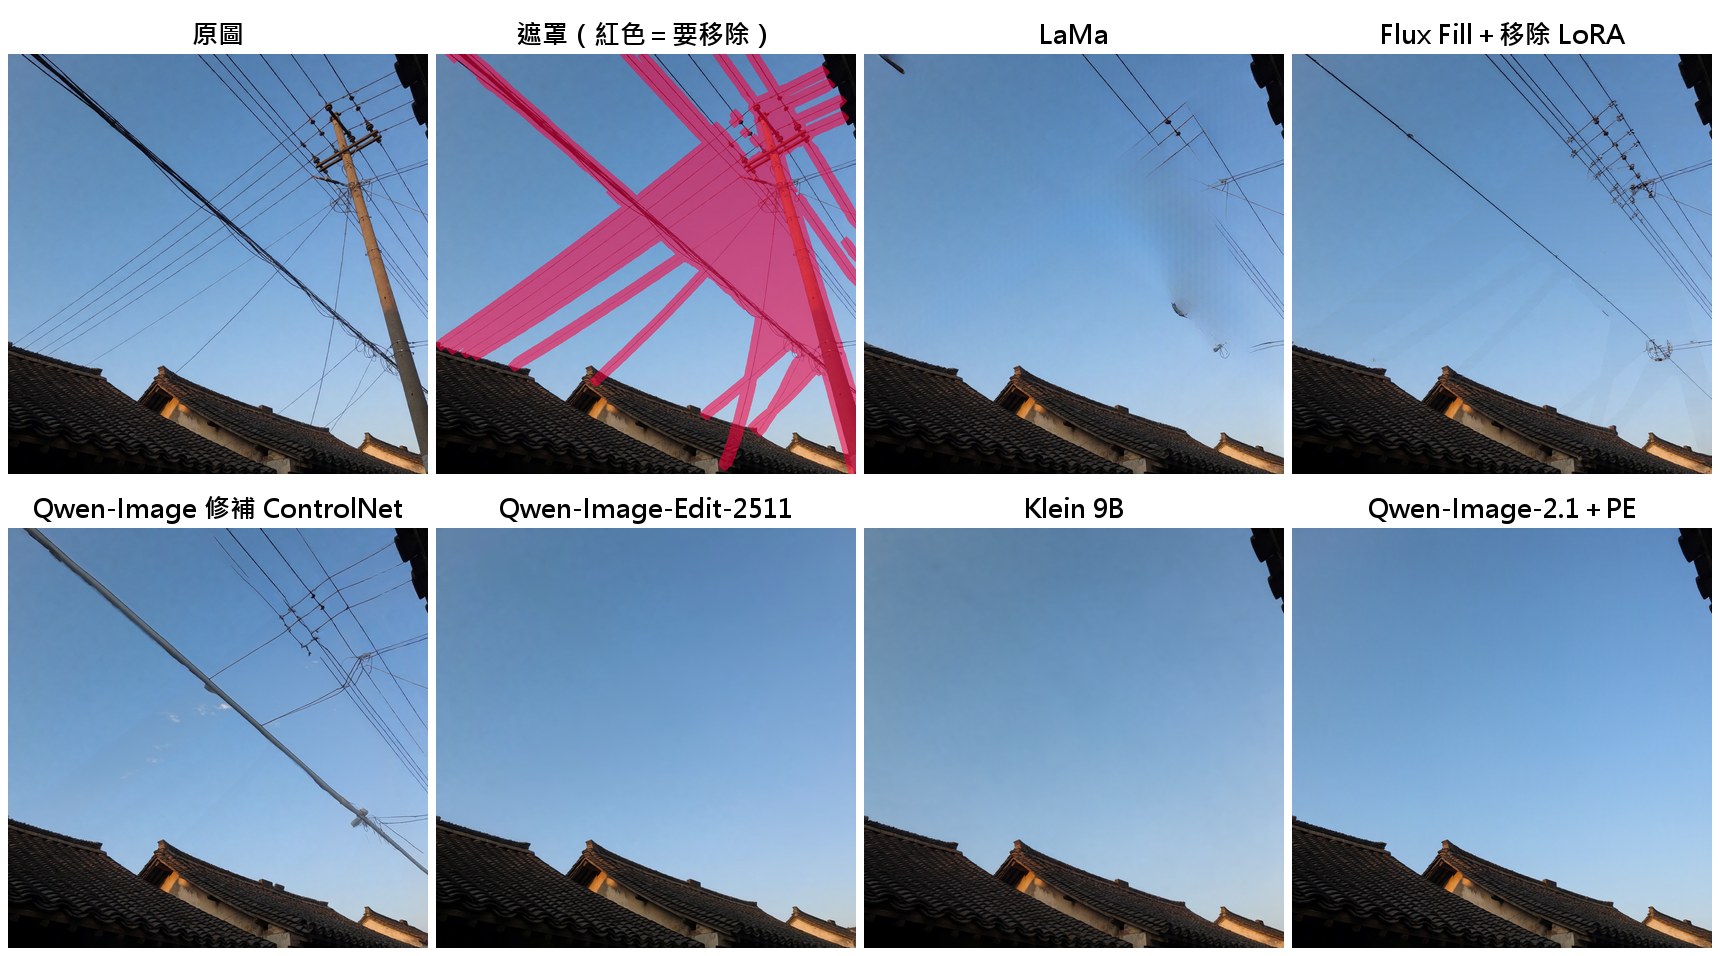
電線是另一種難題:很多條細線橫越整個畫面,遮罩變成一堆細長條。
結果分得很清楚。四款編輯模型全部給出一片乾淨的天空;傳統擦除與遮罩式生成都留下電線的殘段,加了移除 LoRA 的 Flux Fill 和 Qwen-Image 修補 ControlNet 甚至又畫回了新的電線。這是因為遮罩細長條之間還留著一小段一小段的原圖電線,補畫模型看到周圍有電線,就把電線接起來了。
影子與倒影:編輯模型會一起拿掉
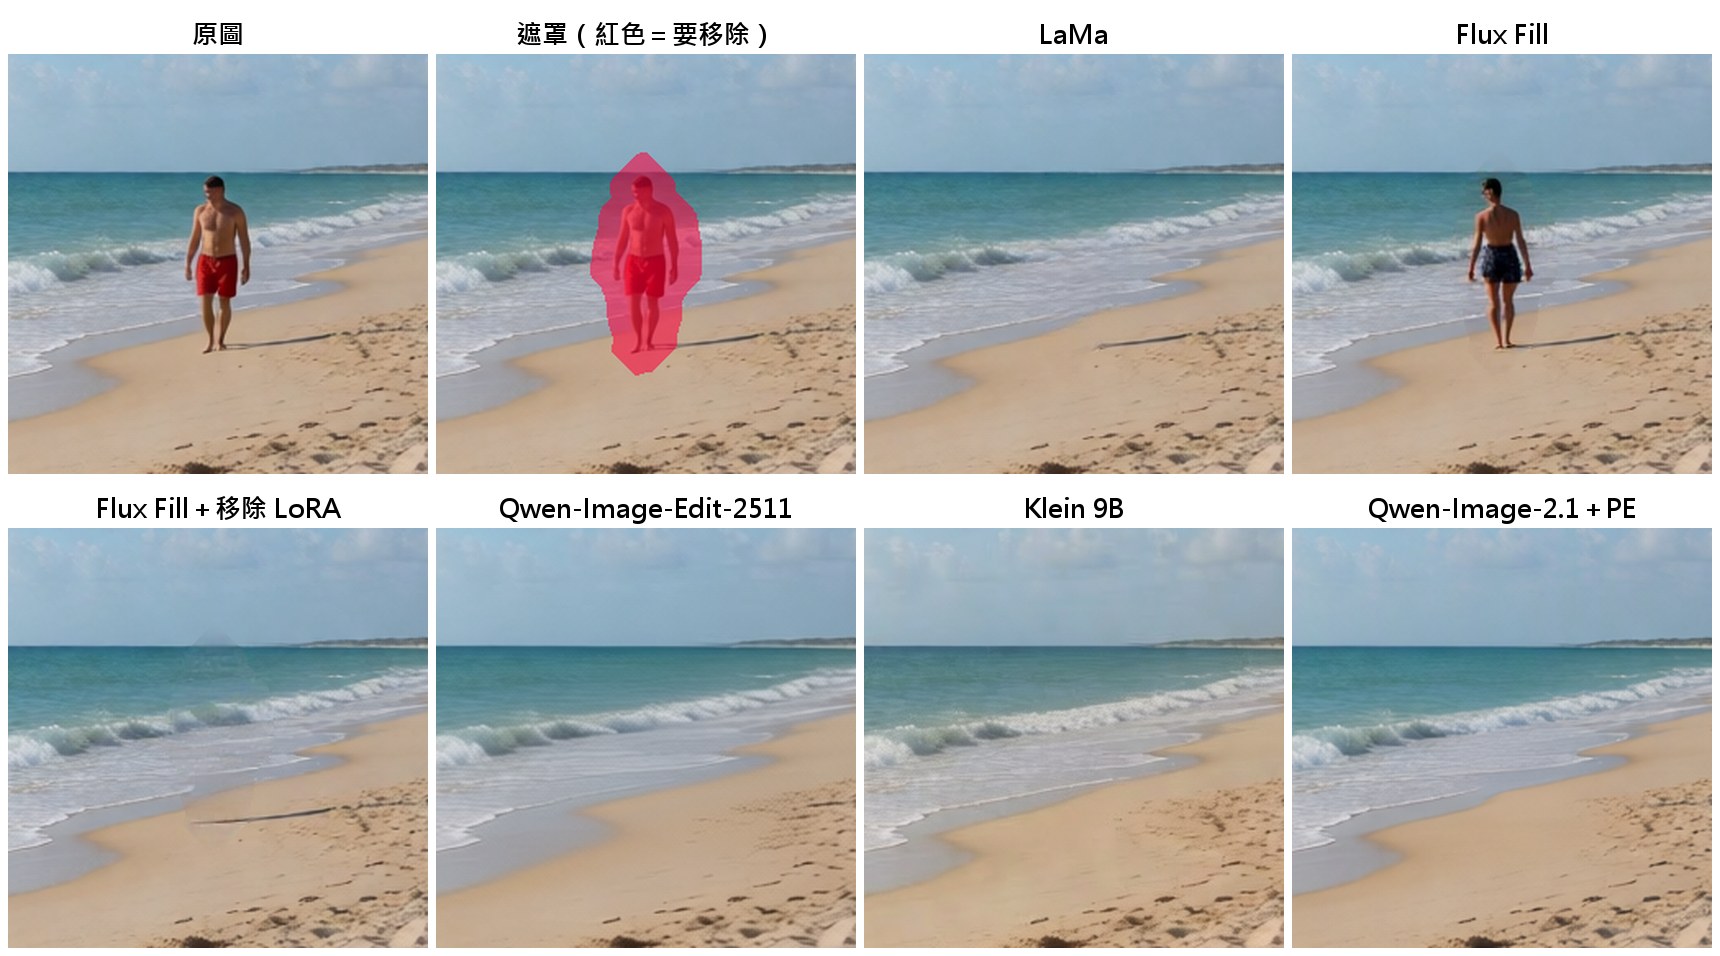
海灘這題的遮罩只框了人,沒有框到他在沙灘上的影子。結果只有四款編輯模型把人和影子一起拿掉;畫遮罩的做法都只處理遮罩裡面,沙灘上留著一道沒有主人的影子。沒加 LoRA 的 Flux Fill 還在原處畫了另一個人。
酒瓶那題我把影子也框進了遮罩:
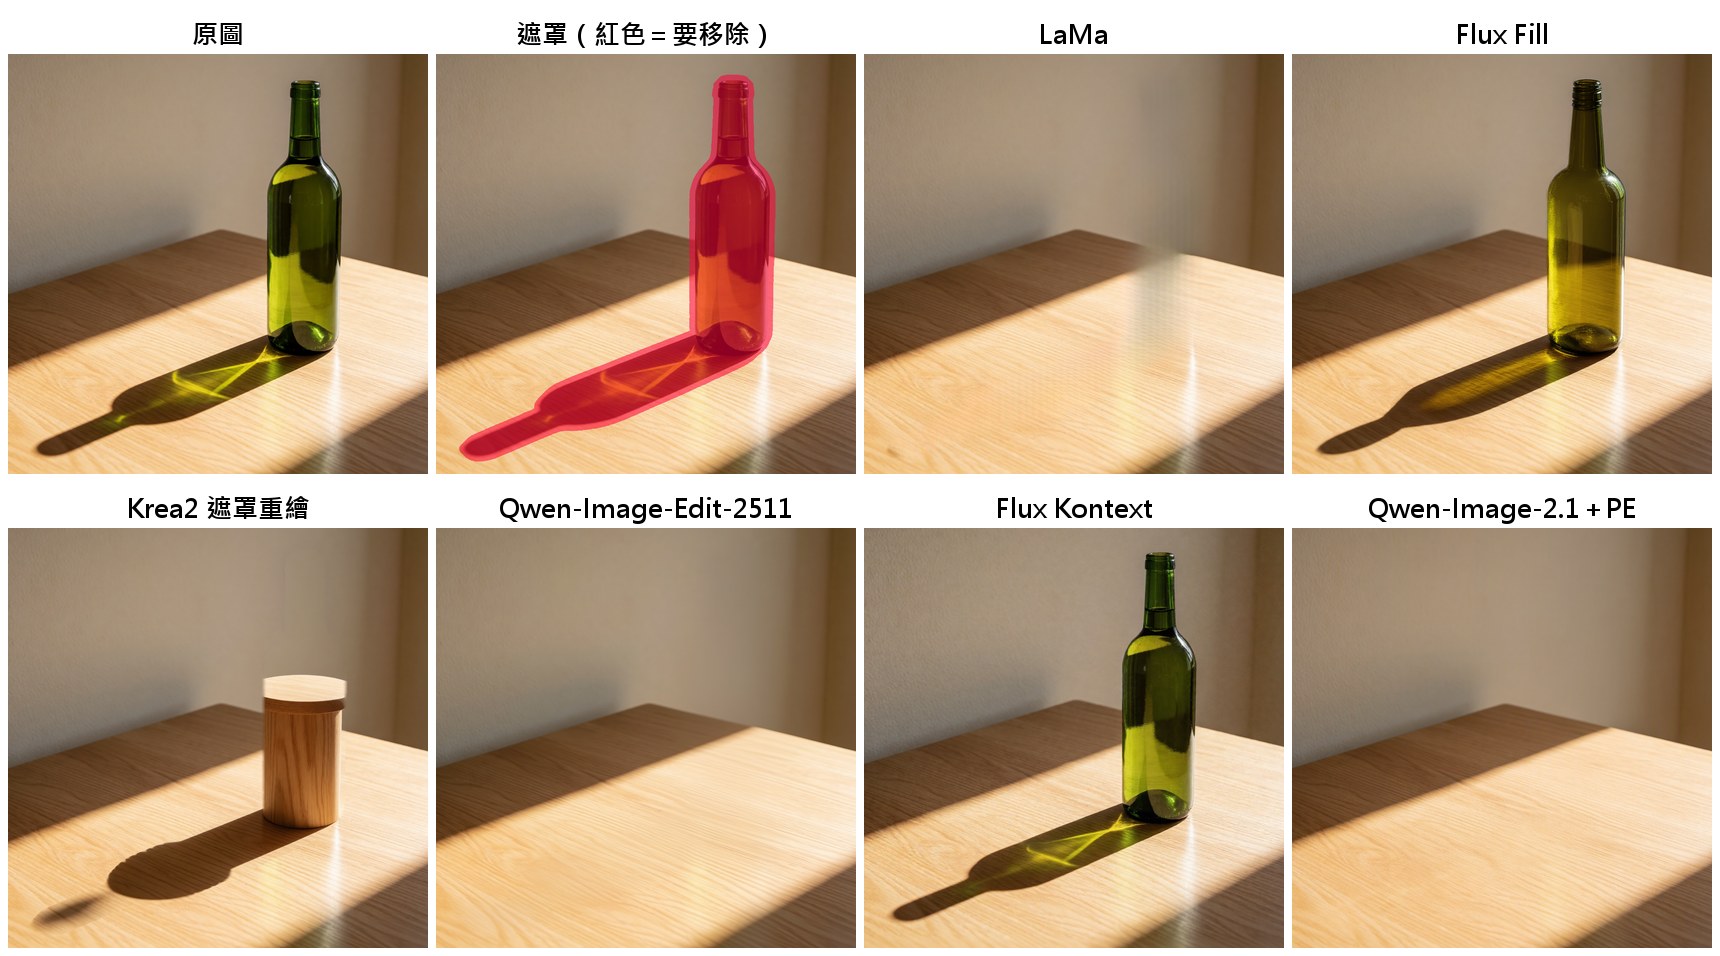
即使影子已經在遮罩裡,遮罩式生成還是會補出東西:Flux Fill 又畫了一個酒瓶,Krea2 畫了一個木罐,而且都順手加上新的影子。Qwen-Image-Edit-2511、Klein 9B、Qwen-Image-2.1 給出一張空桌面,陽光照在桌上的光影也保持一致。Flux Kontext 這一題沒有執行,酒瓶原封不動。
很多零散的小東西:只有一個模型全部拿乾淨
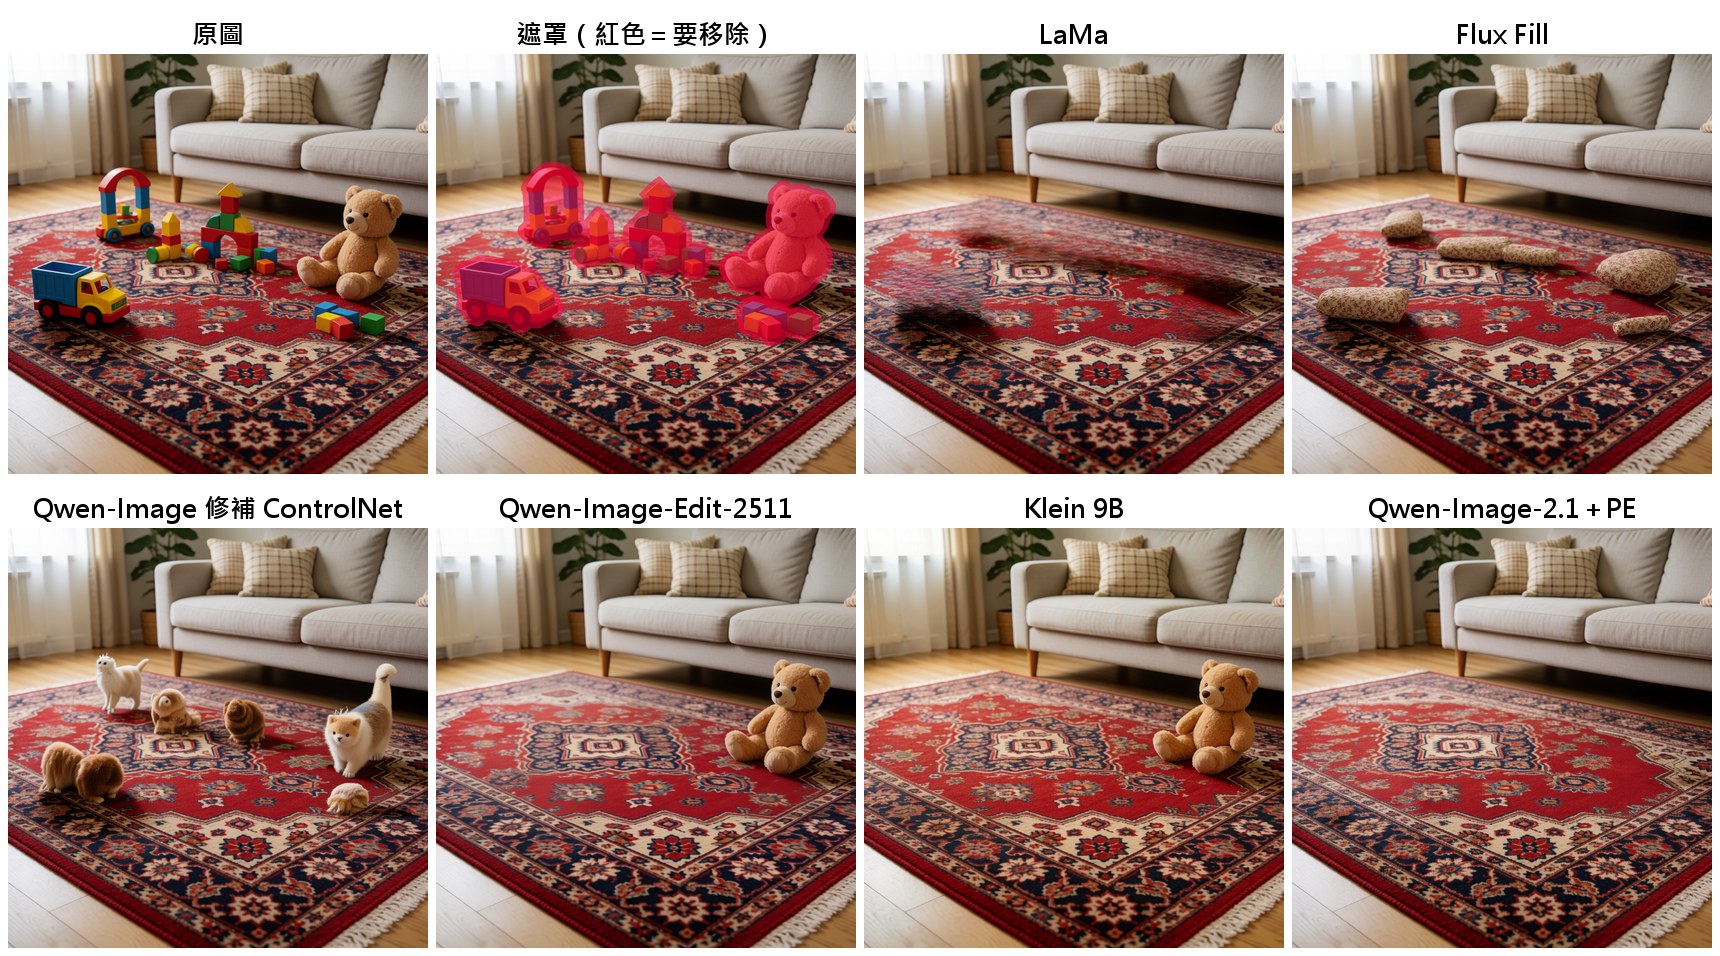
一張波斯地毯上散落著玩具卡車、積木、泰迪熊。這題是全場最難的一題,只有 Qwen-Image-2.1 加 Prompt Enhancer 成功。
Qwen-Image-Edit-2511、Klein 9B、Flux Kontext 都拿掉了卡車和積木,但留下了泰迪熊;Flux Fill 在原處補出幾塊像石頭的東西,Qwen-Image 修補 ControlNet 甚至補出幾隻貓狗;LaMa 把地毯花紋糊掉了。
Qwen-Image-2.1 贏在 Prompt Enhancer:它看過圖之後,把「泰迪熊、黃色卡車、紅色拱門積木、中間的積木塔、散落的方塊」逐項寫進指令,還交代要把地毯的花紋接起來。完整的改寫內容放在文末附錄。
遮罩式生成表現好的時候:人像背後的路人
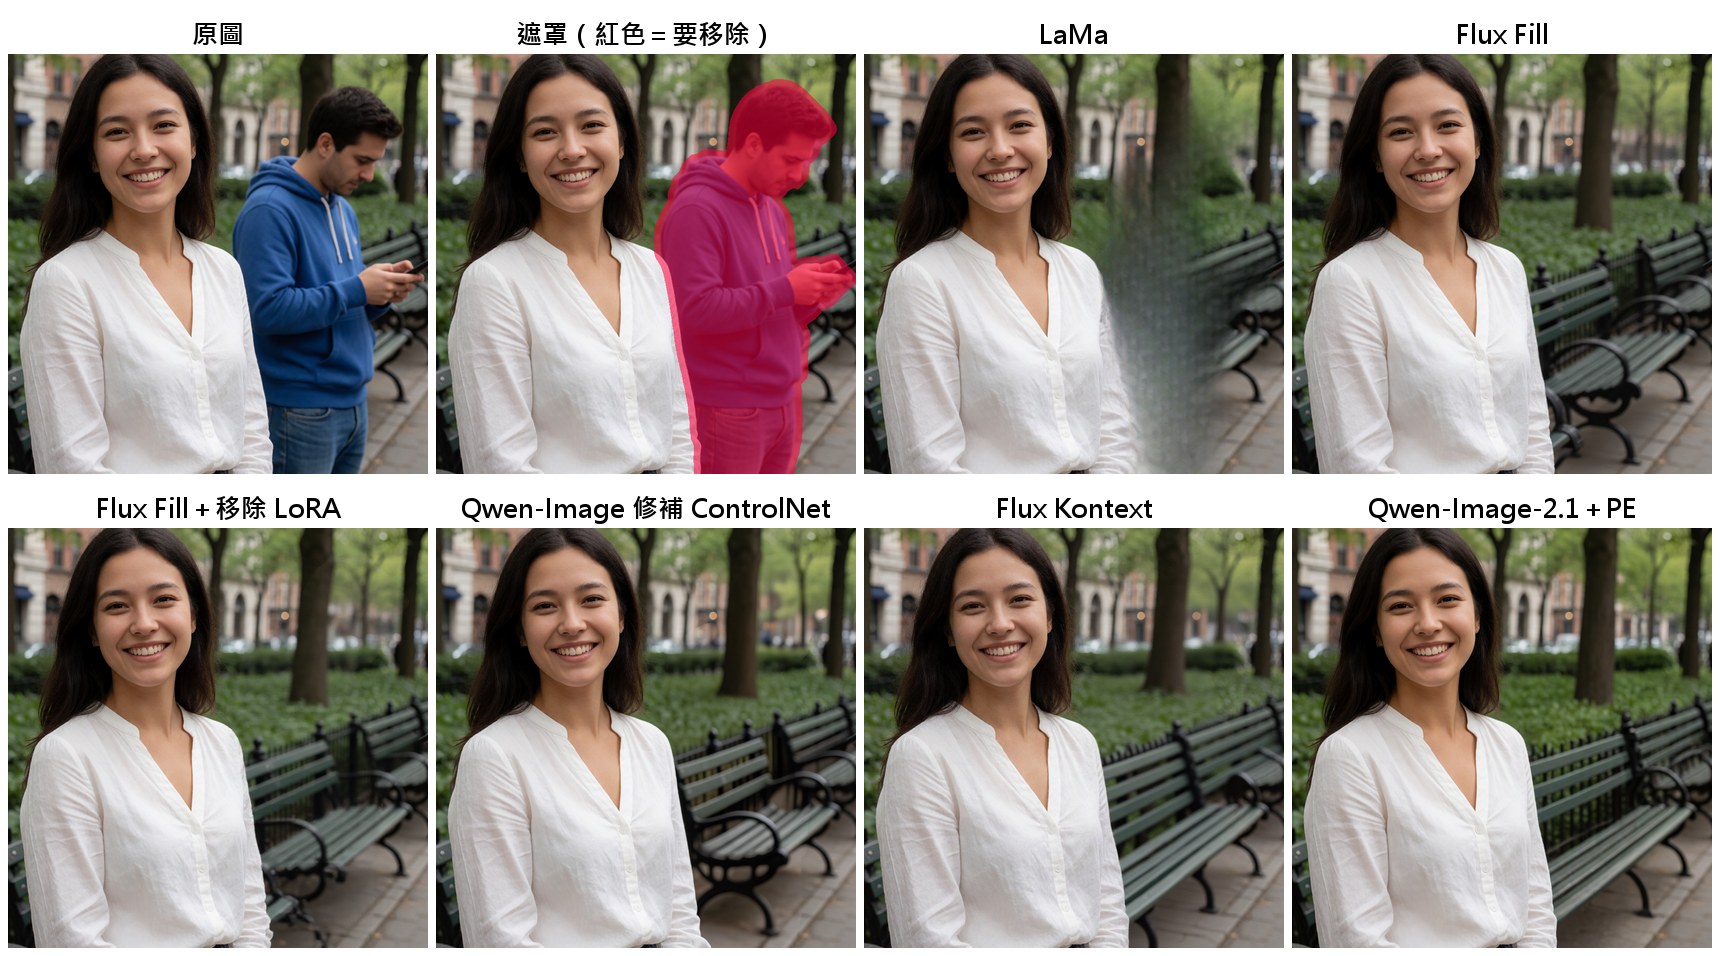
遮罩式生成也有表現好的題目。人像背後路過的男人,遮罩緊貼著主角的肩膀與頭髮。Flux Fill、加了移除 LoRA 的 Flux Fill、Qwen-Image 修補 ControlNet 都補出了合理的公園長椅與樹木,而且因為結果貼回原圖,主角的臉和頭髮完全沒有變——對人像來說這點很重要。編輯模型裡 Flux Kontext 和 Qwen-Image-2.1 也成功。LaMa 在這題留下一大片模糊的綠色。
磚牆上的海報是另一個對照:
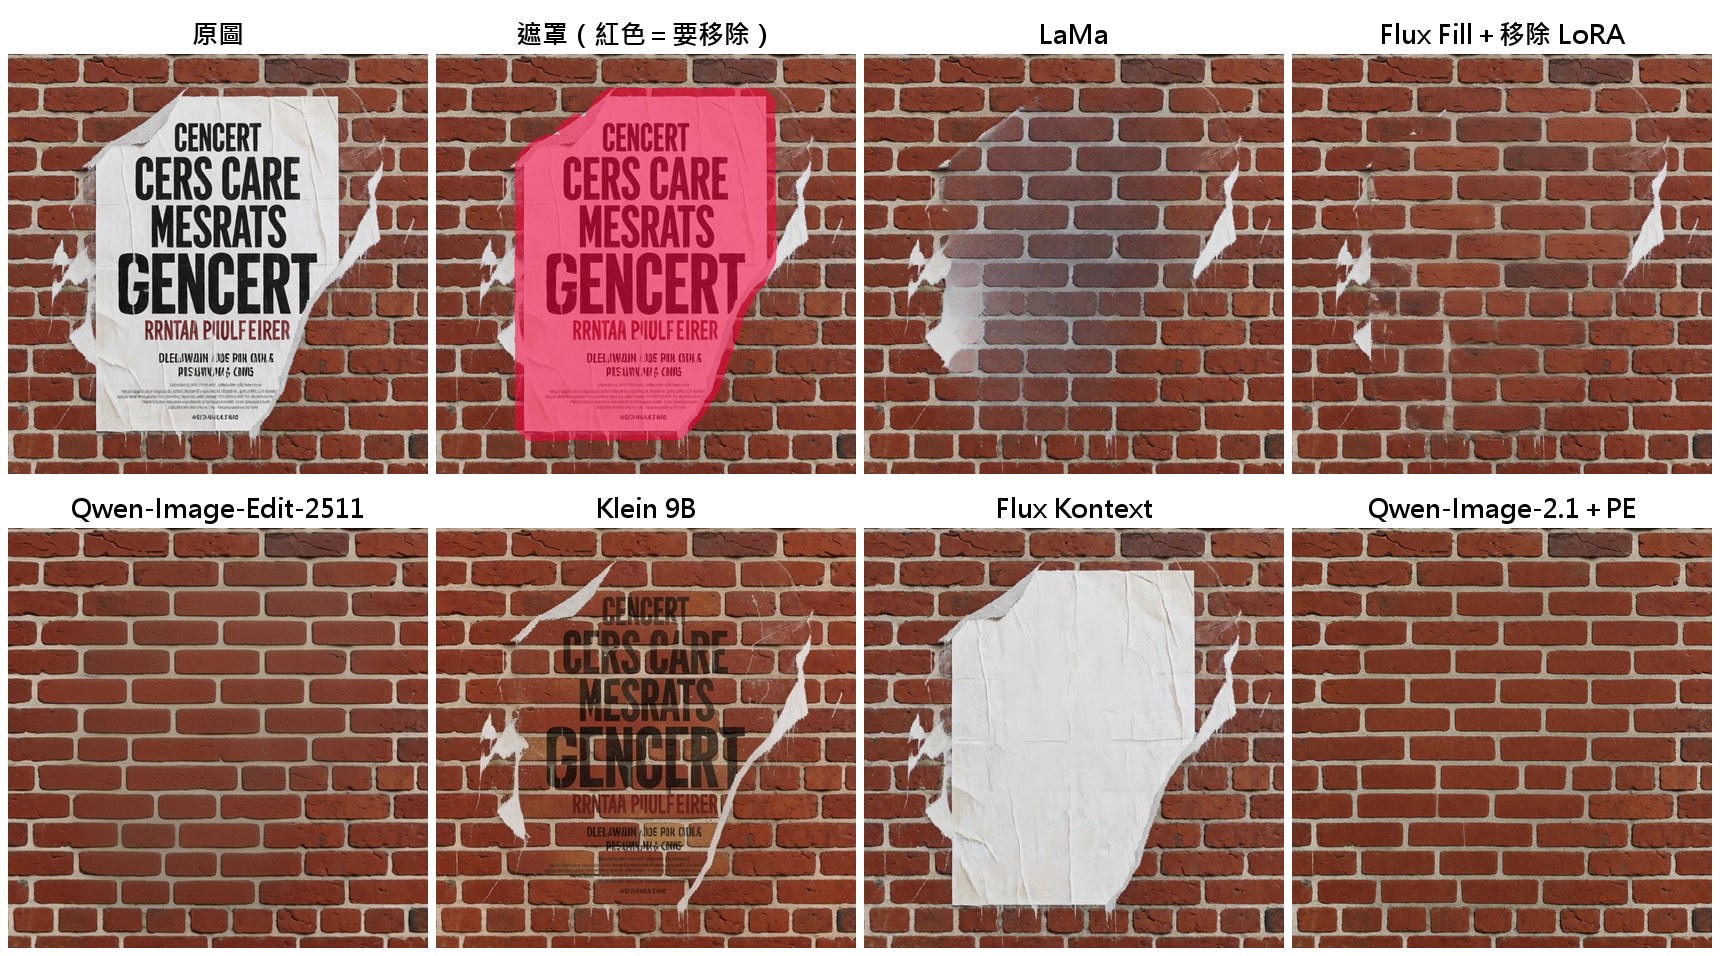
規則的磚紋看起來容易,其實考的是磚縫能不能對齊。Qwen-Image-Edit-2511 和 Qwen-Image-2.1 補出了完整、對齊的磚牆;Klein 9B 把海報的字變成半透明殘影留在牆上;Flux Kontext 把字拿掉了,但留下一張空白的紙;LaMa 補出來的磚塊糊成一片;加了移除 LoRA 的 Flux Fill 補得不錯,但海報撕破的白色邊角在遮罩外面,沒有被處理到。
動漫插畫:小心連旁邊的東西一起拿掉
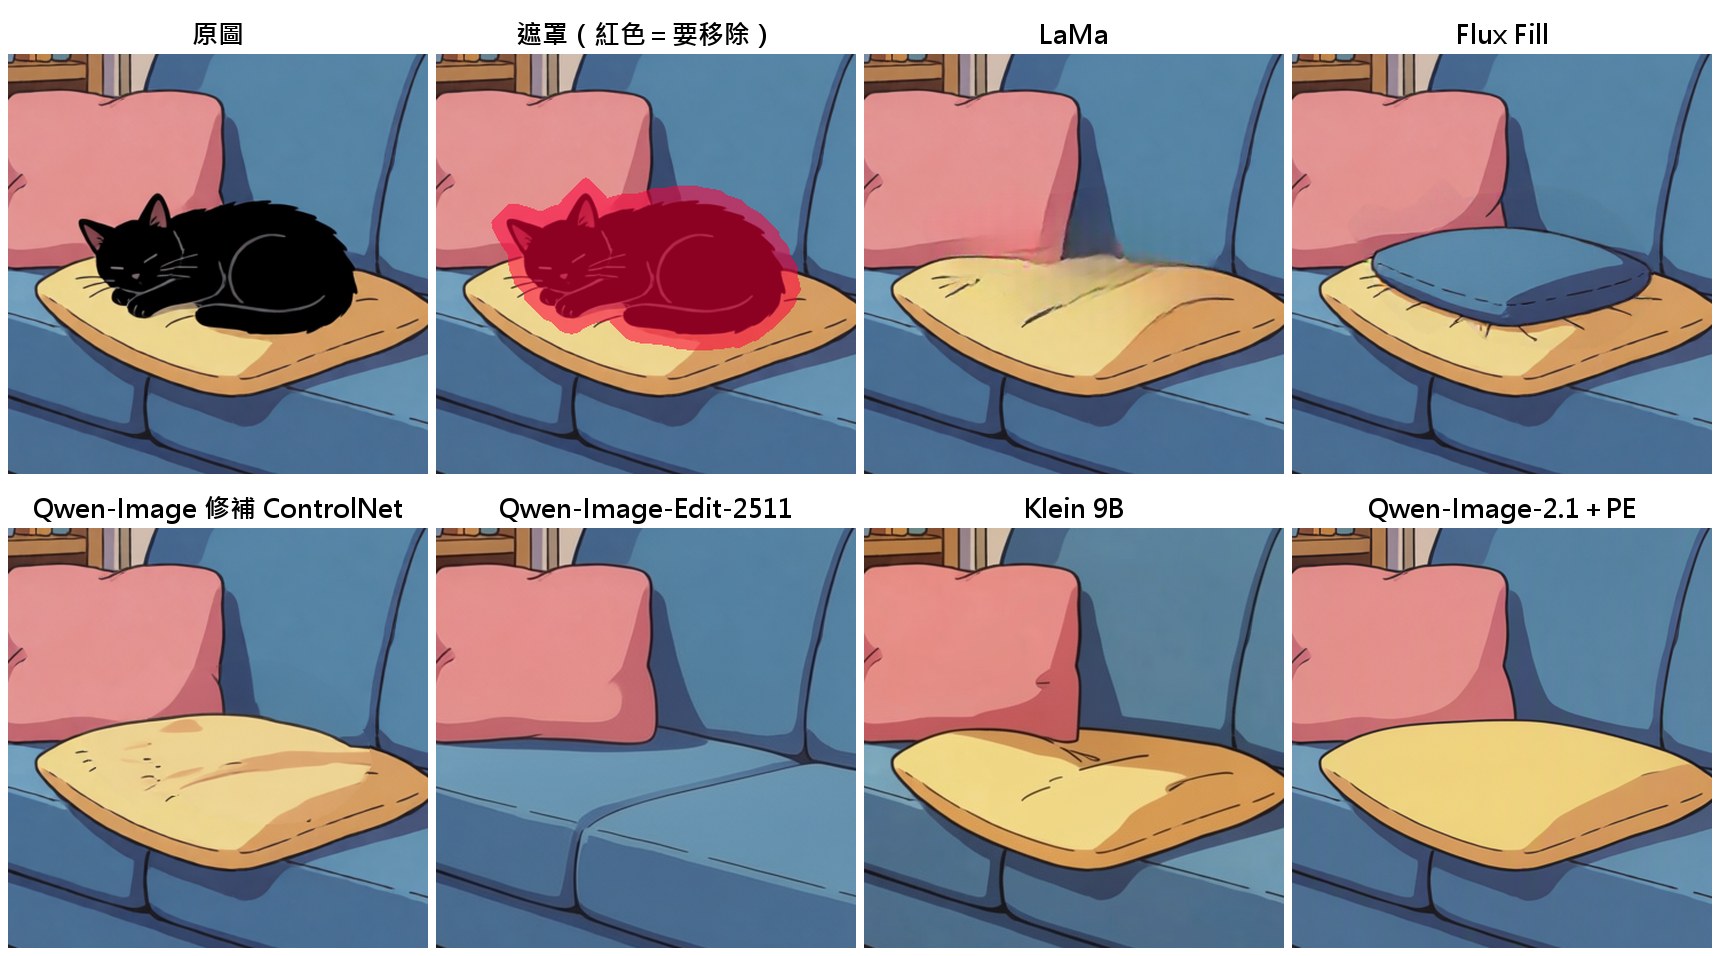
插畫要看補出來的地方畫風是否一致。Klein 9B 和 Qwen-Image-2.1 把貓拿掉後,留下一個線條乾淨的坐墊,跟原圖畫風一致;Qwen-Image 修補 ControlNet 也成功。Qwen-Image-Edit-2511 拿掉貓的時候連坐墊一起拿掉了,變成空沙發——物件是拿乾淨了,但拿多了。Flux Fill 在坐墊上補了另一個藍色坐墊,LaMa 留下一塊模糊的色塊。
有標準答案的題目:浮水印、刮痕、草地
有標準答案的 8 題整體簡單得多,大部分路線都過,這裡挑三種類型各看一題。
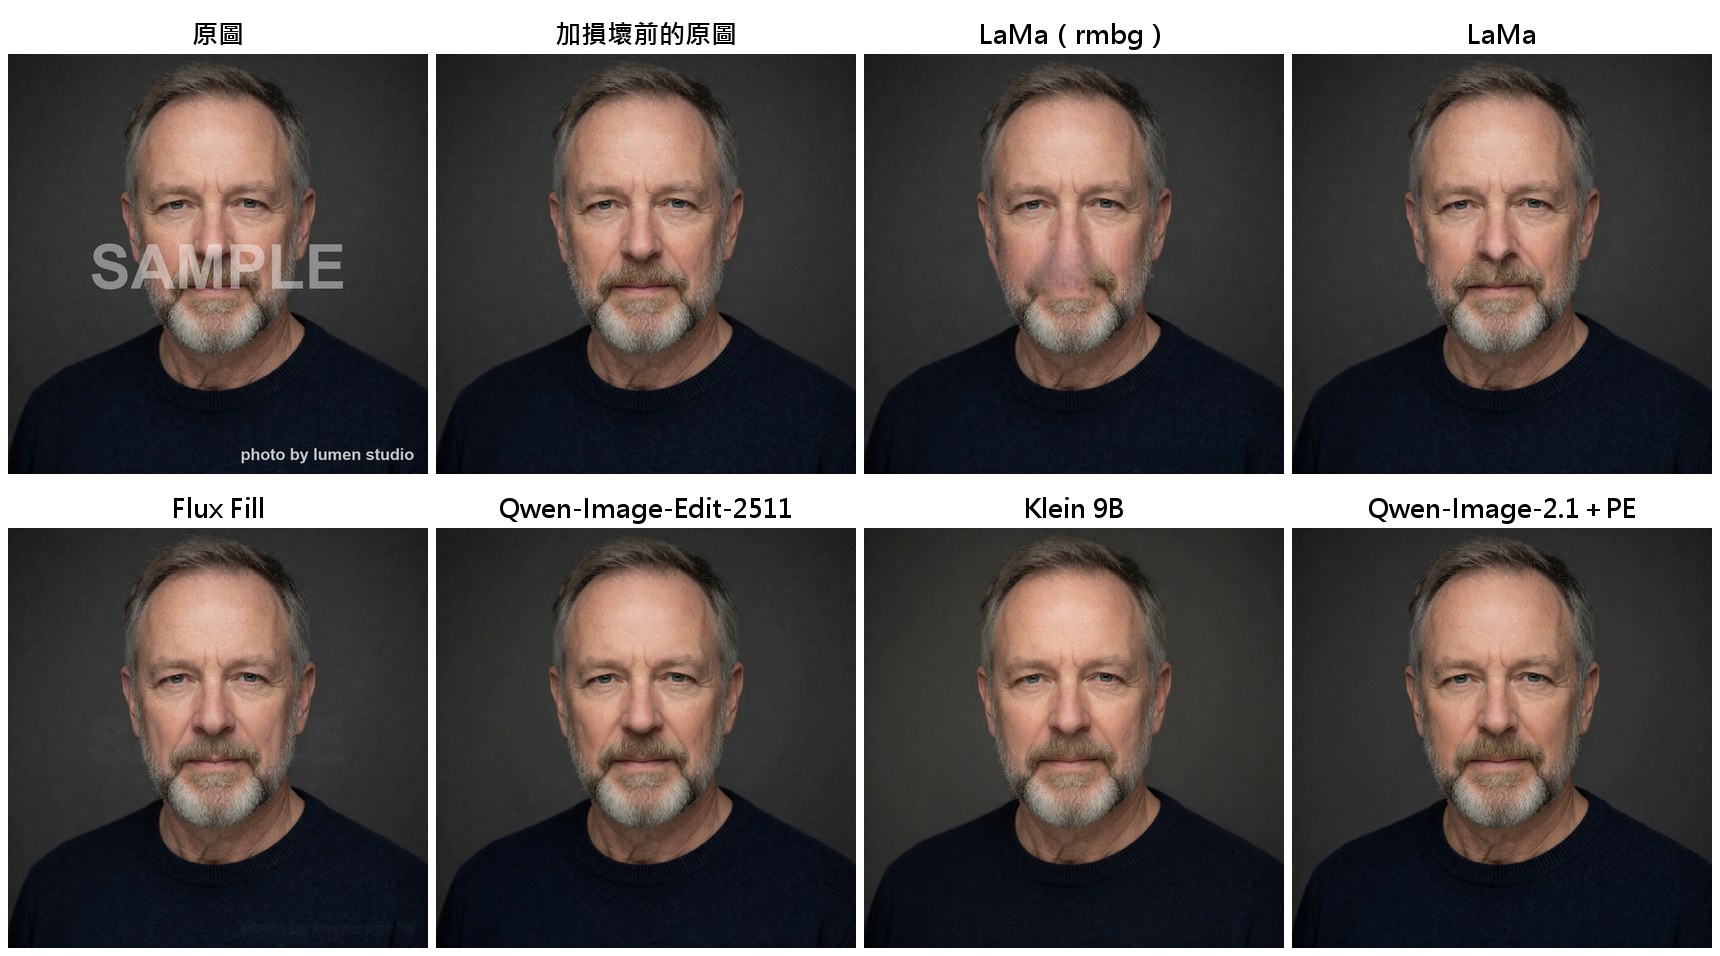
浮水印是最不需要煩惱的一題:浮水印本身是半透明的,底下的臉還看得到,模型只要把顏色修回來就好。12 條路線裡 11 條都成功,只有 comfyui-rmbg 節點的 LaMa 在鼻子上留下一塊顏色不對的區域。同樣是 LaMa,換成 LayerStyle 節點就沒有這個問題,兩個節點包對遮罩邊緣的處理方式不一樣,comfyui-rmbg 那個整場只成功了 1 題。
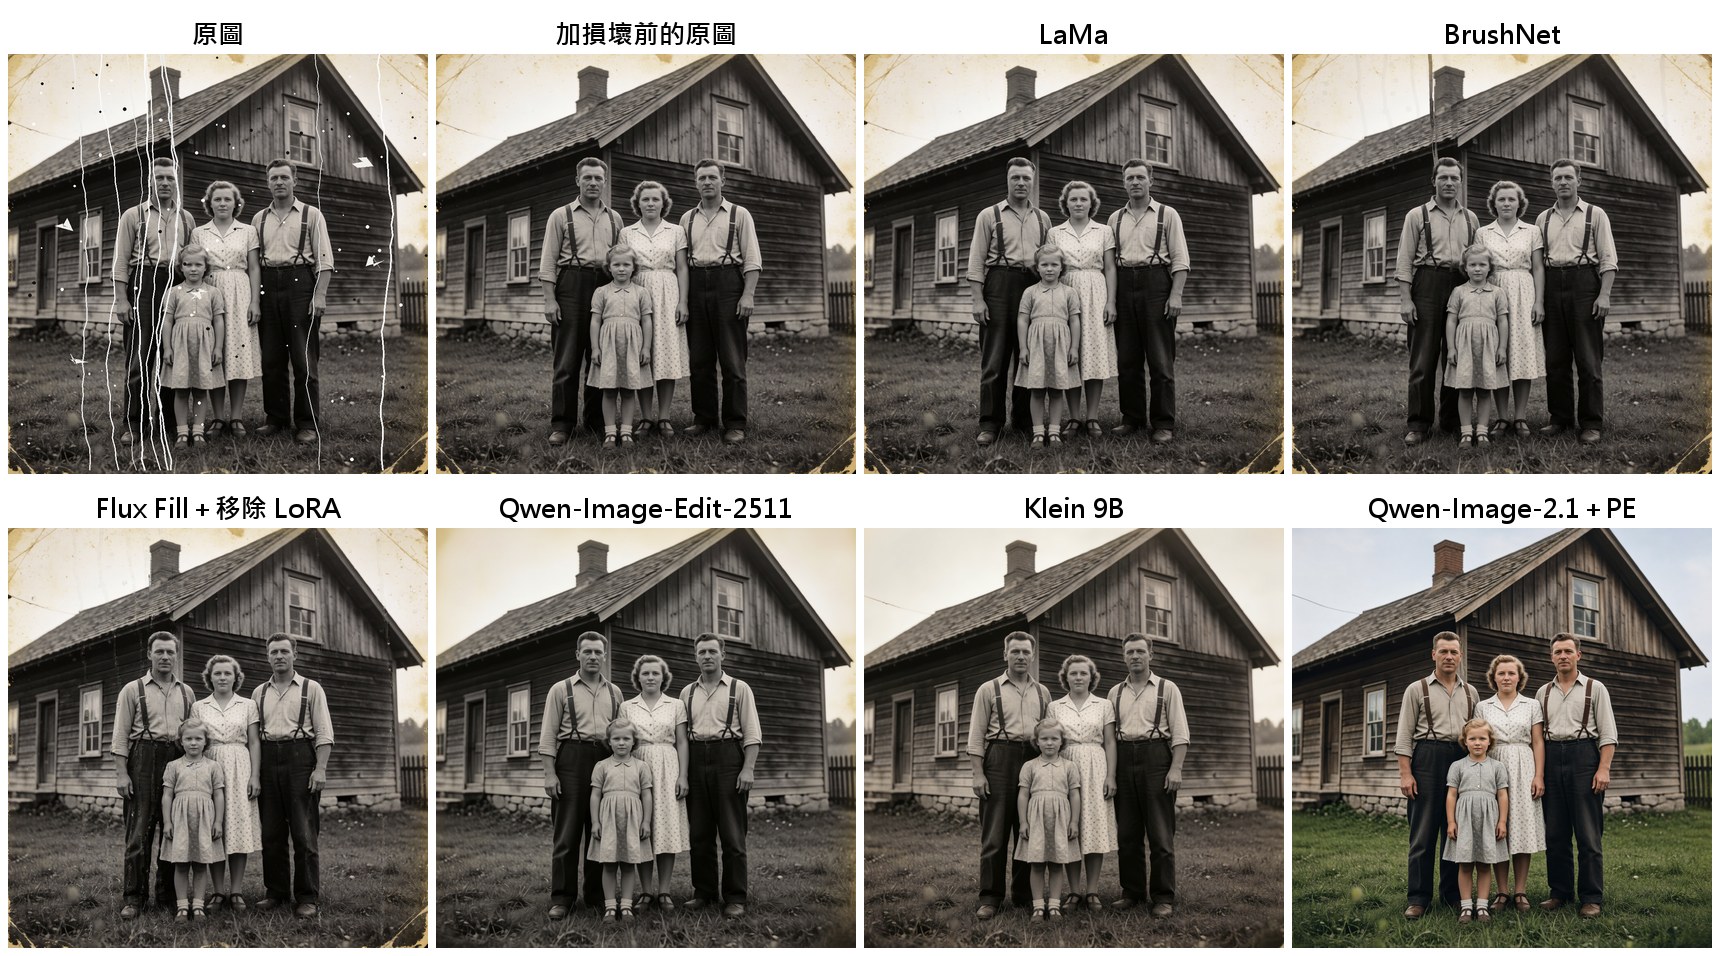
老照片的刮痕跨過人臉和衣服,遮罩是很多細線。Qwen-Image-Edit-2511、Klein 9B、Flux Kontext 修得最乾淨,照片還是黑白的;加了移除 LoRA 的 Flux Fill 和 BrushNet 也成功。Qwen-Image-2.1 這題把整張黑白老照片自動上了色,刮痕是不見了,但這不是修照片的人想要的結果,所以不算成功。要修老照片時,指令裡要特別寫明「保持黑白」,或者改用前面三款。
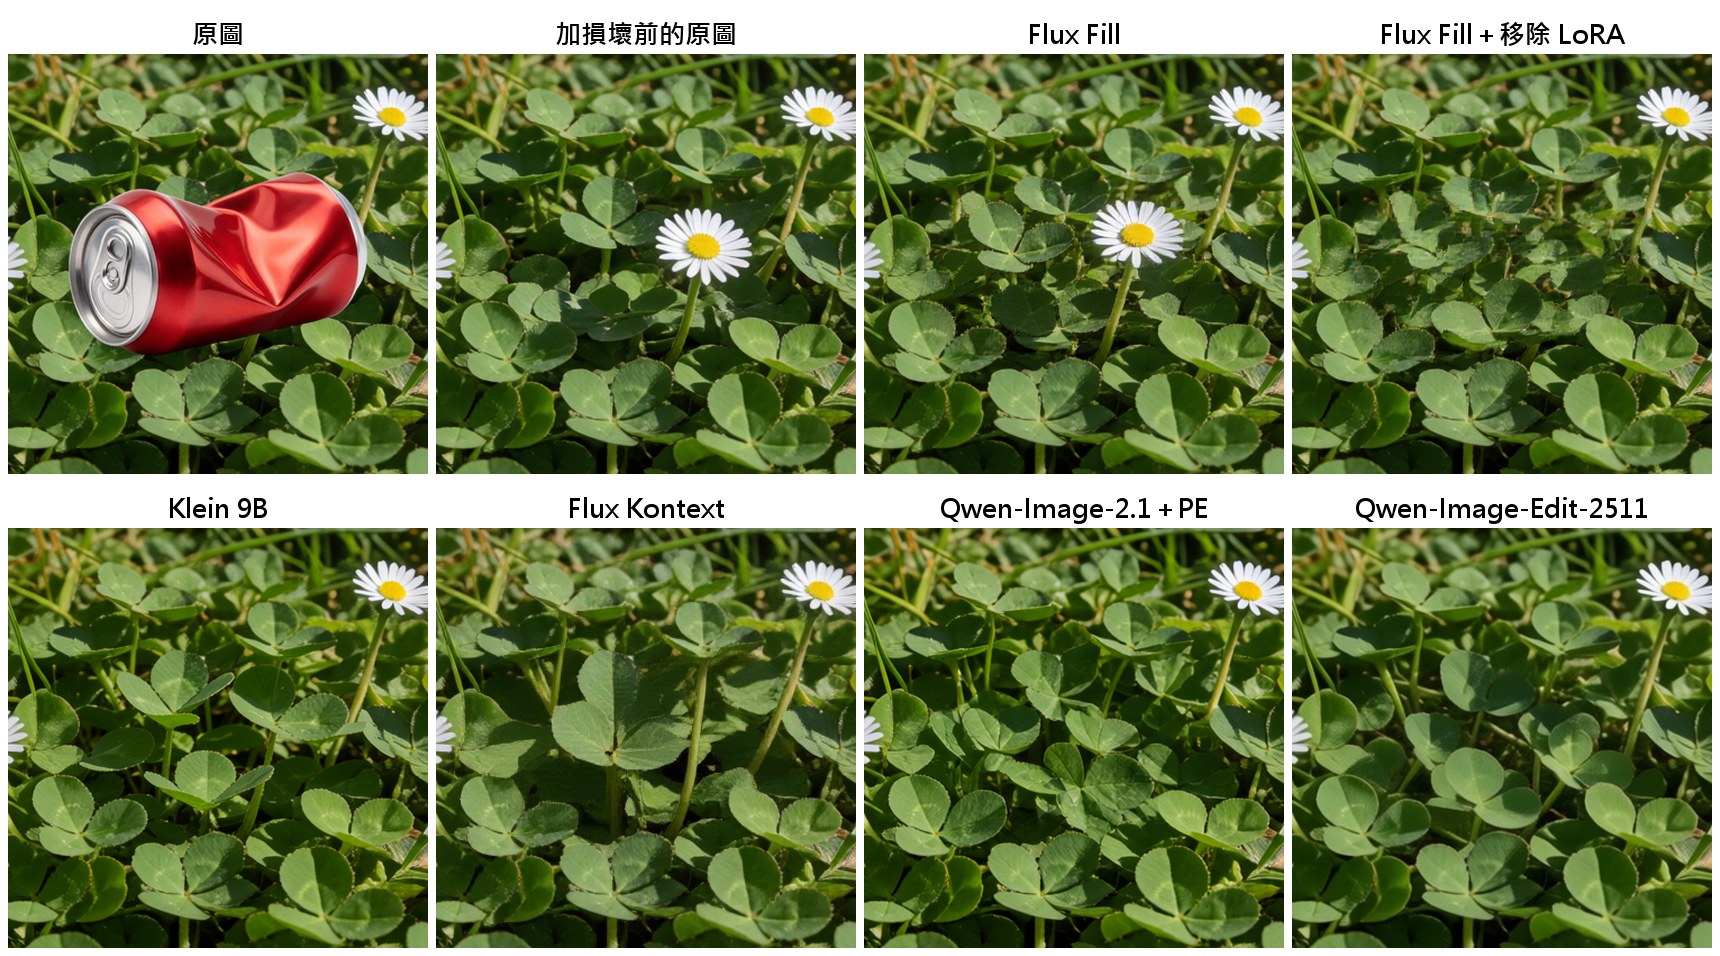
草地上的汽水罐是有趣的一題。原圖在汽水罐底下其實有一朵小雛菊,Flux Fill 補出了一朵位置幾乎一樣的雛菊,跟原本那張乾淨的圖最接近。Flux Kontext 和 Qwen-Image-2.1 補出來的葉子形狀與大小跟周圍的不一樣,放大看會覺得是另一種草,這兩款我沒有算成功。
自動指標只能參考
有標準答案那 8 題,可以把修好的圖跟「加損壞前的原圖」直接比,算出數字。表格裡三個數字的意思:
- PSNR:把兩張圖在遮罩範圍裡逐點比顏色,差得越少分數越高。它很嚴格,形狀對了但細節位置稍微偏一點也會扣分。數字越大越接近原圖。
- LPIPS:用一個看過大量照片的 AI 模型,判斷兩張圖「看起來」像不像,比較接近人眼的感覺,紋理對、細節位置不同也不太扣分。0 代表一模一樣,數字越小越接近原圖。
- 遮罩以外改動:只看遮罩以外、照理說不該被動到的地方,跟原圖相比平均每個點的顏色差了多少。電腦裡每個顏色用 0 到 255 的數字表示(0 是最暗、255 是最亮),所以這個數字是 0 代表完全沒動,數字越大代表改動越多。
| 路線 | PSNR | LPIPS(越低越好) | 遮罩以外改動 |
|---|---|---|---|
| Flux Fill | 28.11 | 0.089 | 0(貼回原圖) |
| Klein 9B | 26.14 | 0.089 | 5.97 |
| Flux Fill+移除 LoRA | 28.16 | 0.094 | 0(貼回原圖) |
| Qwen-Image-Edit-2511 | 28.04 | 0.094 | 3.62 |
| Qwen-Image-2.1+Prompt Enhancer | 26.83 | 0.105 | 4.96 |
| LaMa(LayerStyle 節點) | 28.07 | 0.108 | 0(只改遮罩內) |
| Flux Kontext | 21.45 | 0.214 | 10.84 |
前段的分數差距很小,不足以排名,而且這 8 題本來就是大家都會的簡單題;真正拉開差距的真實場景沒有標準答案可以算。第三欄倒是有用:它說明編輯模型雖然只被要求拿掉一個東西,整張圖其實都重畫過了,Flux Kontext 改動得最多,Qwen-Image-Edit-2511 最少。大部分情況肉眼看不出來,但如果你要拿結果去跟原圖疊在一起比對,這點要知道。
情境推薦
| 你要做的事 | 用這個 | 備註 |
|---|---|---|
| 一般照片拿掉路人、雜物 | Qwen-Image-2.1+Prompt Enhancer 或 Klein 9B | 不用畫遮罩,影子會一起拿掉 |
| 很多零散的小東西 | Qwen-Image-2.1+Prompt Enhancer | 這次唯一全部拿乾淨的 |
| 電線、細長的東西 | 任何一款編輯模型 | 畫遮罩的做法會把電線接回去 |
| 人像,主角一點都不能變 | Flux Fill+移除 LoRA 或 Qwen-Image+修補 ControlNet | 結果貼回原圖,遮罩外完全不變;面積大時容易補出新東西,可以多換幾個隨機種子試 |
| 浮水印 | 任何一條都可以 | 傳統擦除最快,LaMa 用 LayerStyle 節點那個 |
| 老照片刮痕 | Qwen-Image-Edit-2511 或 Klein 9B | Qwen-Image-2.1 會自動上色 |
| 動漫、插畫 | Klein 9B 或 Qwen-Image-2.1 | Qwen-Image-Edit-2511 有時會連旁邊的東西一起拿掉 |
留下哪些模型就夠用:日常一款編輯模型(Qwen-Image-2.1 或 Klein 9B)加上 Flux Fill 與移除 LoRA,就能涵蓋這次所有情境。傳統擦除模型體積很小,留一個 LaMa 處理浮水印這類小事也不佔空間。
授權備忘:Qwen-Image-2.1 是 Qwen Research License,僅限非商業用途,要拿來接案前請先確認。
附錄:這次用的指令
指令式編輯的移除指令(Qwen-Image-Edit-2511、Klein 9B、Flux Kontext 都用這一句,the toys 換成要拿掉的東西;加了移除 LoRA 的 Flux Fill 也用這一句):
Remove all the toys from the image. Fill the area naturally so it matches the surrounding background. Keep everything else in the image exactly the same.
遮罩式生成的背景描述(以寺廟那題為例,描述的是「拿掉之後應該看到什麼」,不是要拿掉的東西):
empty stone path in front of a red traditional Japanese temple gate, daylight
Qwen-Image-2.1 Prompt Enhancer 改寫後的指令(地毯玩具那題。輸入是上面那句移除指令加上原圖,Prompt Enhancer 看圖後改寫成這一段,再交給 Qwen-Image-2.1 生成):
Remove all toys from the image: the light brown teddy bear seated on the right side of the rug, the yellow toy dump truck with the blue cargo bed on the left, the yellow toy stroller with the red arch and blue wheels in the upper left, the central building-block tower made of red, yellow, and green blocks with the blue arch, the small yellow and red block column beside it, the scattered red, green, and orange cubes and green cylinders near the center, and the cluster of blue, yellow, red, and green blocks in the lower right. Fill every vacated area with a seamless continuation of the surrounding red patterned rug, matching its cream and navy floral motifs and texture, and extend the wooden floor and the sofa base naturally where the toys overlap them, so the rug and floor appear complete and undisturbed. Keep everything else in the image exactly the same: the red patterned rug with its white fringe, the light wooden floor, the white sofa with its beige checkered cushions, the green potted plant in the woven basket, the beige curtains, the sheer white window curtain, the radiator, and the original soft natural lighting, shadows, and reflections.
模型下載
| 模型 | 來源 | 放置位置 | 節點 |
|---|---|---|---|
| Qwen-Image-2.1、Prompt Enhancer | ComfyUI 範本庫「Qwen-Image-2.1 Image Edit」內附連結;Prompt Enhancer 見上一篇 | diffusion_models/、text_encoders/、vae/ | 核心 TextEncodeQwenImage21 |
| Klein 9B | ComfyUI 範本庫「Flux.2 Klein Image Edit 9B」內附連結 | diffusion_models/ | 核心 ReferenceLatent |
| Qwen-Image-Edit-2511 | Comfy-Org/Qwen-Image-Edit_ComfyUI | diffusion_models/ | 核心 TextEncodeQwenImageEditPlus |
| Flux Kontext | Comfy-Org/flux1-kontext-dev_ComfyUI | diffusion_models/ | 核心 ReferenceLatent |
| Flux Fill | Comfy-Org/flux1-dev(flux1-fill-dev) | diffusion_models/ | 核心 InpaintModelConditioning |
| 物件移除 LoRA | lrzjason/ObjectRemovalFluxFill | loras/ | 核心 LoraLoaderModelOnly |
| Qwen-Image+修補 ControlNet | Comfy-Org/Qwen-Image-InstantX-ControlNets | controlnet/ | 核心 ControlNetInpaintingAliMamaApply |
| LaMa、MAT | 節點第一次執行時自動下載 | models/lama/ | LayerStyle LaMa |
| SAM 3.1(做遮罩) | Comfy-Org(sam3.1_multiplex_fp16.safetensors) | checkpoints/ | 核心 SAM3 Detect |
兩個安裝時會碰到的問題:MAT 的模型檔從 GitHub 自動下載時可能被中斷,可以手動下載 Places_512_FullData_G.pth 放進 models/lama/;BrushNet 的節點包(comfyui-brushnet)目前跟新版 ComfyUI 不相容,執行時會出錯,要等作者更新。
SAM 3.1 要一次框出多個物件,文字要寫成 person:30 這種格式(冒號後面是最多要框幾個),只寫 person 的話它只會框出最有把握的那一個人。
相關文章
- ComfyUI 去背模型大評比:30 條路線同圖實測 — 同一套「同圖對照」的評比方法
- Qwen-Image-2.1 進階用法實測 — Prompt Enhancer 是什麼、為什麼這篇也照用
- 開源圖像編輯模型大亂鬥:JoyAI、Klein、Qwen 2511 同題實測 — 這次三款編輯模型的一般編輯能力比較